Kimi K3 рассуждает перед каждым ответом, и выключить это нельзя. В нашем замере 22.09.2026 запрос с max_tokens: 100 вернул 559 токенов выхода с finish_reason: stop: потолок длины через наш шлюз не сработал. Расход у K3 держат явный reasoning_effort и контроль usage. Если же вы выбираете модель с нуля, сначала посмотрите на K3.1 Pro: у Moonshot она на треть дешевле за токен и заметно сильнее в агентных задачах, но в нашем каталоге её пока нет.
K3 стала прошлым поколением: что изменилось с выходом K3.1 Pro
Kimi K3 — модель Moonshot AI на 2,8 трлн параметров, из которых на каждый токен работают 104 млрд. Контекст — 1 048 576 токенов, веса открыты под собственной лицензией Kimi K3 License (Hugging Face). В API Moonshot она появилась в июле 2026 года (changelog). В конце октября вышла K3.1 Pro, та же K3 после большого дообучения, и в документации K3 теперь называется флагманом прошлого поколения (список моделей).
| Модель | Moonshot: вход / выход | Moonshot: чтение кэша | altrouter: вход / выход |
|---|---|---|---|
| kimi-k3.1-pro | $2 / $10 | $0,20 | нет в каталоге |
| kimi-k3.1-pro-highspeed | $4 / $20 | $0,20 | нет в каталоге |
| kimi-k3 | $3 / $15 | $0,30 | $2,55 / $12,75 |
Цены за 1M токенов. Moonshot — по прайсу на 29.10.2026, altrouter — по каталогу на 27.10.2026, на 15% ниже официальной цены вендора. Запись в кэш Moonshot считает отдельно: по цене входа при хранении 5 минут и по двойной цене входа при хранении час.
Разрыв в качестве больше, чем в цене. На Terminal-Bench 4.0 у Vals.ai все модели работают через одного и того же минимального агента. Там K3.1 Pro решает 63,64% задач и тратит в среднем $4,57 на задачу, а K3 — 17,17% и $12,48 (Vals.ai, обновление 27.10.2026). Уровень рассуждений Vals не указывает. Как читать этот бенчмарк при выборе модели для кода, разобрано в статье о нейросетях для кода.
Если вы только выбираете модель для агента, у Moonshot K3 проигрывает K3.1 Pro и по цене токена, и по результату. Модели K2 Moonshot с 31 октября закрывает для новых пользователей, а к концу декабря 2026 года отключит совсем (прайс). Через нас доступна только K3, поэтому дальше речь о ней: что она делает со счётом и как этим управлять.
Замер: одна задача, девять прогонов
22.09.2026 мы отправили одну и ту же задачу через наш API: POST https://api.altrouter.ai/v1/chat/completions, без стриминга, с сервера в Нюрнберге. Время мерили часами клиента. Задача:
«Сколько раз за сутки (24 часа) часовая и минутная стрелки механических часов образуют прямой угол? Дай число и объяснение в 3-4 предложениях.»
Вопрос с подвохом. Частый неверный ответ — 48, правильный — 44: за 12 часов минутная стрелка обгоняет часовую 11 раз и на каждом круге дважды встаёт к ней под прямым углом.
| Настройка | Время | Вход | Выход | Из них рассуждения | Цена по каталогу 27.10 | Ответ |
|---|---|---|---|---|---|---|
low, прогон 1 | 4,8 с | 144 | 246 | 81 | $0,0035 | 44 |
low, прогон 2 | 7,6 с | 144 | 285 | 96 | $0,0040 | 44 |
high, прогон 1 | 5,1 с | 144 | 271 | 74 | $0,0038 | 44 |
high, прогон 2 | 7,3 с | 144 | 242 | 51 | $0,0035 | 44 |
high + max_tokens: 300 | 5,7 с | 144 | 247 | 53 | $0,0035 | 44 |
medium, прогон 1 | 13,0 с | 76 | 845 | 732 | $0,0110 | 44 |
medium, прогон 2 | 9,2 с | 76 | 549 | 426 | $0,0072 | 44 |
без reasoning_effort | 8,7 с | 76 | 366 | 232 | $0,0049 | 44 |
без reasoning_effort + max_tokens: 100 | 8,4 с | 76 | 559 | 427 | $0,0073 | 44 |
Все девять запросов вернули HTTP 200, finish_reason: stop и правильное число. Цена посчитана по usage и каталогу на 27.10.2026. В день замера модель стоила у нас дороже, об этом в разделе о цене.
Пути к ответу разные. С low модель объяснила через обгоны: «Минутная стрелка обгоняет часовую в полном обороте 11 раз за 12 часов…». С high появилась относительная скорость: «5,5° в минуту (6° − 0,5°)». С medium Kimi посчитала обороты за сутки: 24 у минутной, 2 у часовой, 22 относительных.
max_tokens не ограничил длину ответа
По документации Moonshot рассуждения входят в max_tokens: сумма reasoning_content и ответа не должна его превышать (Thinking Mode). В нашем прогоне с max_tokens: 100 Kimi K3 выдала 559 токенов, из них 427 рассуждений и 132 видимого ответа, а finish_reason остался stop. В первой проверке того же дня при max_tokens: 16 пришло 150 токенов, 127 из них рассуждения.
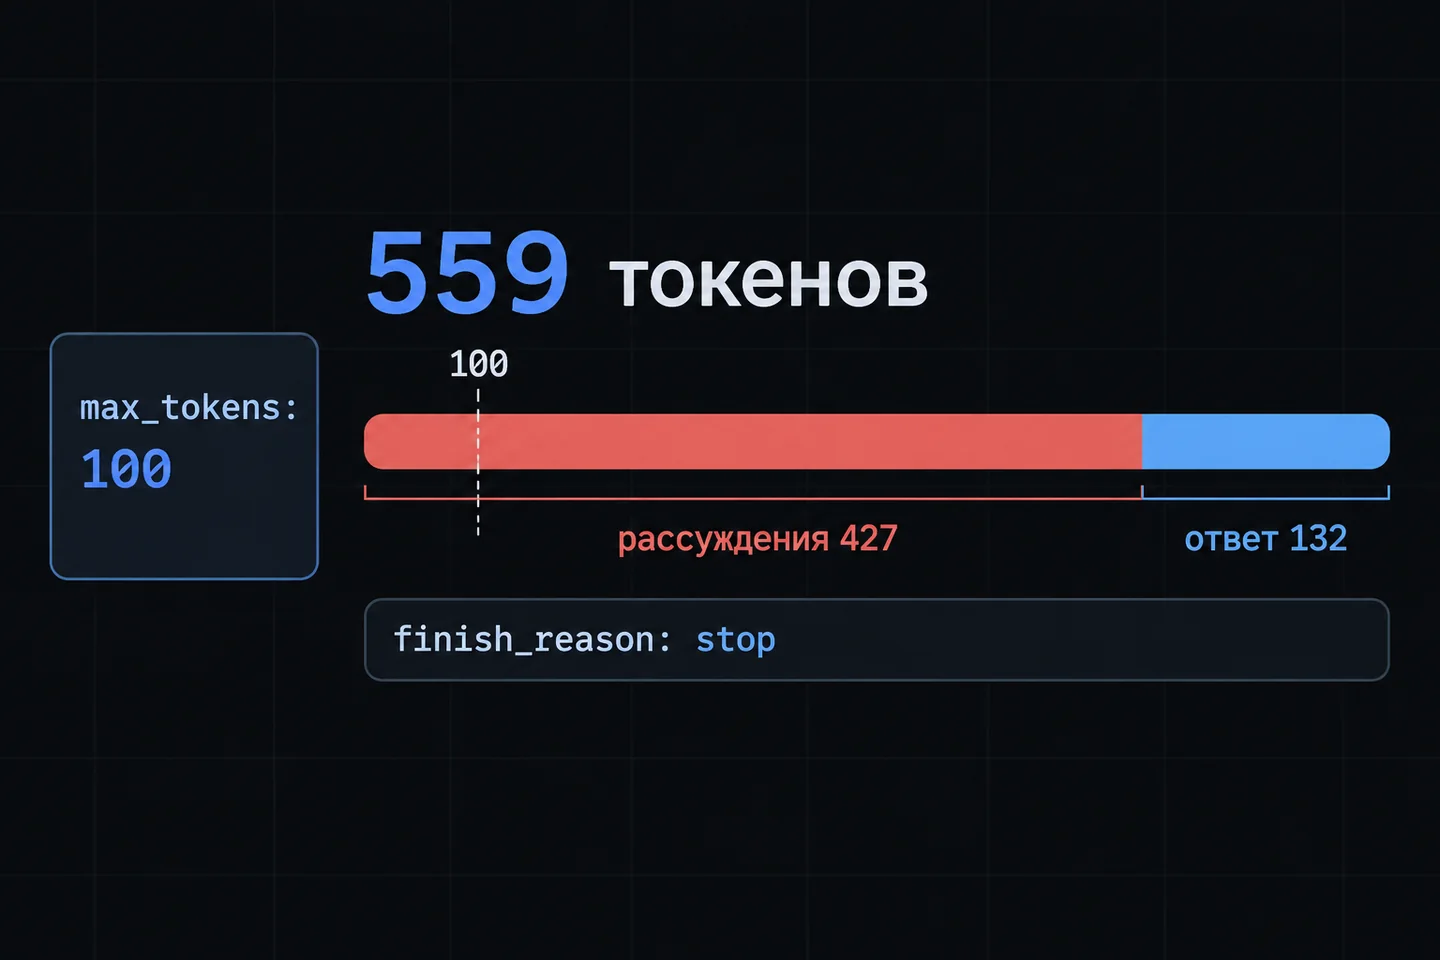
22.09 списание прошло за все 559 токенов. Поэтому max_tokens у Kimi K3 через наш шлюз не считайте потолком расходов, а сколько списано за конкретный запрос, смотрите в usage.cost. У xAI договорённость другая и прописана в документации: max_completion_tokens на рассуждения Grok не действует вовсе (разбор Grok API). Итог для разработчика тот же: длину черновика этим параметром не удержать.
Moonshot советует ставить думающим моделям max_tokens не меньше 16 000, чтобы рассуждения и ответ не обрезались. В нашем каталоге потолок для Kimi K3 — 32 000. Расход держите иначе: явным reasoning_effort, короткой постановкой задачи и контролем usage.completion_tokens вместе с completion_tokens_details.reasoning_tokens. Для фоновых задач заведите отдельный ключ с потолком трат (лимиты): когда он кончится, запросы по ключу получат 402, а остальной баланс не пострадает.
reasoning_effort: medium в замере дороже high
У Moonshot для K3 три уровня: low, high и max, по умолчанию max (K3 quickstart). В нашем каталоге для этой модели low, medium и high. Уровня medium у Moonshot нет, а max, на котором Moonshot снимает свои бенчмарки, через нас не задать.
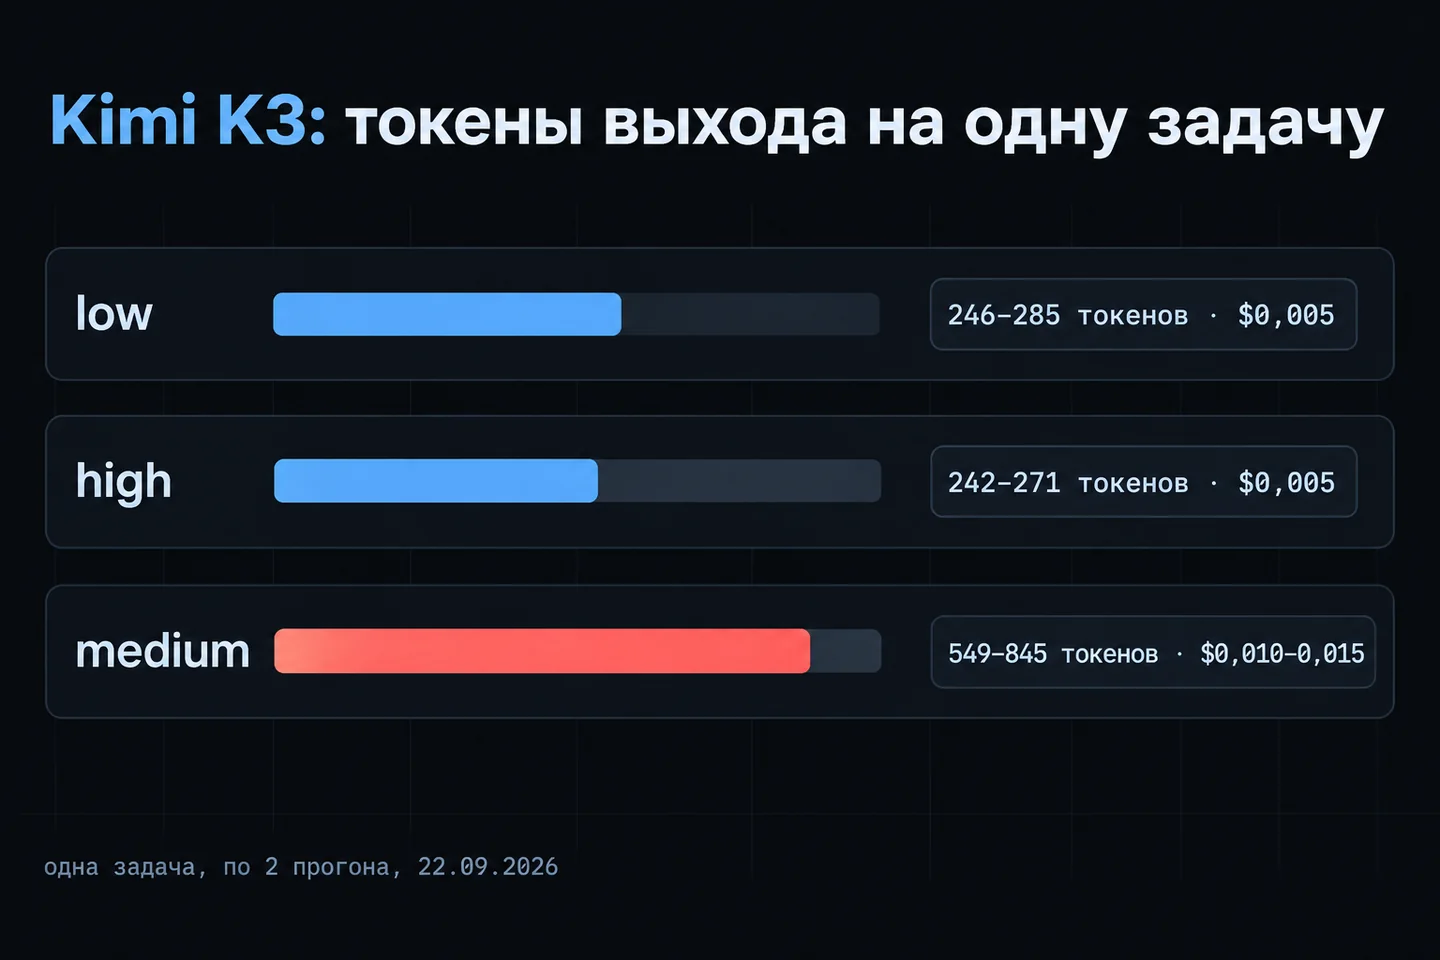
В замере medium обошёлся в 2–3 раза дороже high: 549–845 токенов выхода против 242–271 и 9,2–13,0 секунды против 5,1–7,3. Запрос без reasoning_effort вёл себя как medium: тот же вход в 76 токенов и 232–427 токенов рассуждений.
Почему у low и high вход 144 токена, а у medium и у запроса без параметра 76 на том же вопросе, по ответу API не видно. В деньгах это доли цента.
Передавайте low или high явно. На задаче из замера оба уровня дали правильный ответ, low уложился в 246–285 токенов выхода.
Сколько стоит запрос
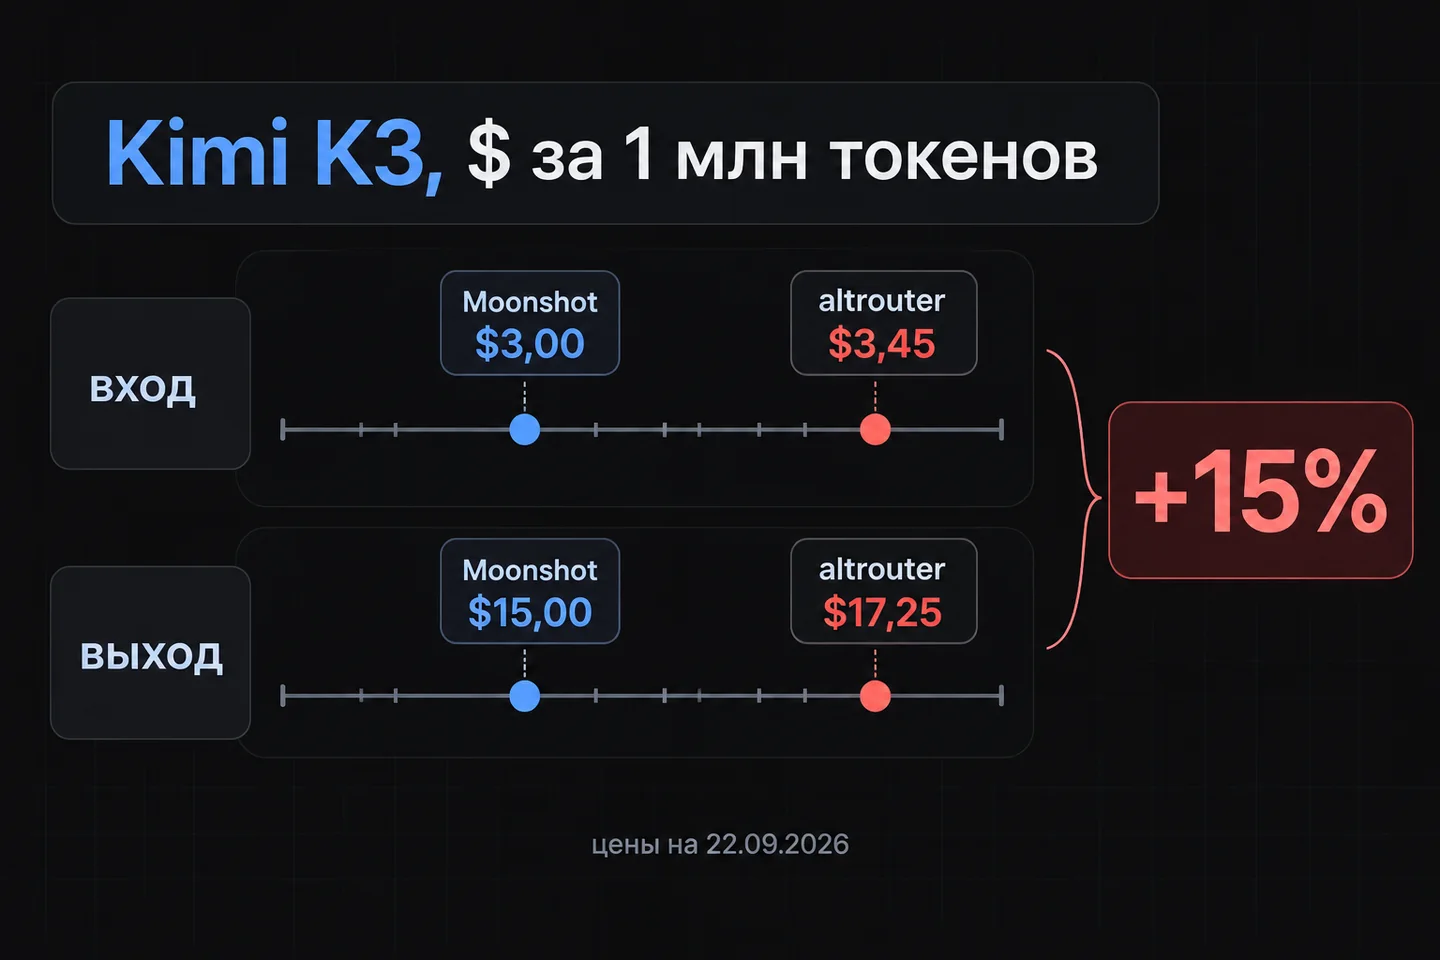
22.09.2026 Kimi K3 стоила у нас $3,45 / $17,25 за 1M токенов, на 15% дороже Moonshot, и эта цена на схеме ниже. По каталогу на 27.10.2026 она другая: $2,55 / $12,75, на 15% ниже официальной цены Moonshot.
Средние по замеру, пересчитанные на 10 000 похожих запросов:
| Настройка | Средний запрос: вход / выход | altrouter, 10 000 запросов | Moonshot, 10 000 запросов |
|---|---|---|---|
low | 144 / 265,5 | $37,5 | $44,1 |
high (прогоны 1 и 2) | 144 / 256,5 | $36,4 | $42,8 |
medium | 76 / 697 | $90,8 | $106,8 |
Ход расчёта для high по нашему каталогу: 144 × $2,55 / 1M + 256,5 × $12,75 / 1M = $0,00037 + $0,00327 = $0,00364 за запрос. Выход у K3 впятеро дороже входа, и почти весь счёт здесь составляют рассуждения и ответ. Сколько токенов на ту же задачу потратит K3.1 Pro, мы не замеряли, но токен у неё у Moonshot на треть дешевле.
Moonshot сам кэширует повторяющееся начало промпта: чтение из кэша у K3 стоит $0,30 за 1M, в 10 раз дешевле обычного входа. Отдельной цены кэша для Kimi K3 в нашем каталоге нет. Агент на каждом шаге заново отправляет длинную историю, и у Moonshot напрямую кэш может перевесить нашу скидку в 15%: сравнивайте по usage.cost на своих запросах (логи и стоимость). Batch API со скидкой у Moonshot есть, но с K3 он не работает, только с моделями K2 (Batch pricing).
Чтобы открыть K3 у Moonshot напрямую, баланс нужно пополнить минимум на $1 (лимиты Moonshot). Через altrouter K3 оплачивается картой РФ, СБП или криптой, без подписки.
Запрос к Kimi K3: что передавать и что нет
import os

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["ALTROUTER_API_KEY"],
    base_url="https://api.altrouter.ai/v1",
)

messages = [
    {"role": "user", "content": "Сколько раз за сутки стрелки часов образуют прямой угол?"},
]

resp = client.chat.completions.create(
    model="kimi-k3",
    reasoning_effort="low",  # задавайте явно: low или high
    messages=messages,
)

msg = resp.choices[0].message
usage = resp.usage
details = usage.completion_tokens_details

print(msg.content)
print("выход:", usage.completion_tokens)
print("из них рассуждения:", details.reasoning_tokens if details else "нет данных")
print("списано, $:", getattr(usage, "cost", None))

# Следующий ход: сообщение ассистента целиком, вместе с reasoning_content и tool_calls
messages.append(msg)
Что учесть, если переносите код с другой модели:
temperature,top_p,n,presence_penaltyиfrequency_penaltyу K3 зафиксированы (1.0, 0.95, 1, 0 и 0), и Moonshot просит их не передавать. Если общий клиент подставляет их по умолчанию, для Kimi уберите.- В многоходовом диалоге и при вызове инструментов возвращайте сообщение ассистента целиком. Moonshot требует сохранять
reasoning_contentиtool_calls, а у нас рассуждения приходят вmessage.reasoning_content(параметры). - Картинки по публичной ссылке Moonshot не принимает, только base64 или id загруженного файла. Передавайте изображение как base64 data URI.
- Moonshot советует стрим для думающих моделей: ответ с рассуждениями длиннее обычного, а поток спасает от сетевых таймаутов. На задаче про стрелки
mediumдумал 13 секунд, длинная задача по коду займёт минуты.
Другие способы урезать выход, которые работают для любой модели, собраны в разборе расходов на токены.
Пределы замера
Замер узкий: одна задача, один или два прогона на настройку, без стриминга. Время зависит от нагрузки. Цена посчитана по usage и каталогу, а не по выписке биллинга.
Для контроля в тот же день мы дали K3 простую задачу по коду: функцию проверки 10-значного ИНН на Python. Четыре прогона дали 160–191 токен выхода и 6,1–7,3 секунды, код во всех случаях совпал по логике. На простом коде разница между уровнями почти не видна. На длинных агентных задачах соотношение может оказаться другим, поэтому замерьте его на своих сценариях.
FAQ
Чем K3.1 Pro Highspeed отличается от K3.1 Pro?
По словам Moonshot, это та же модель, которая отвечает в 2–3 раза быстрее (список моделей). Стоит она вдвое дороже: $4 / $20 за 1M токенов против $2 / $10. В нашем каталоге нет ни одной из них.
Можно ли запустить Kimi K3 на своём сервере?
Веса K3 лежат на Hugging Face, Moonshot рекомендует vLLM, SGLang и TokenSpeed. Но 2,8 трлн параметров даже в 4-битном виде занимают около 1,4 ТБ (2,8 × 10¹² × 0,5 байта): это кластер из нескольких серверов с GPU. Веса K3.1 Pro Moonshot обещает опубликовать до 4 ноября 2026 года.
Отдаёт ли Kimi K3 строгий JSON?
У Moonshot да: response_format с json_schema и strict: true ограничивает финальный content, а reasoning_content разбирать не нужно (K3 quickstart). В нашей документации response_format заявлен для моделей Gemini и GPT, на Kimi K3 мы его не проверяли. Проверьте на тестовом запросе или получайте JSON через вызов инструмента.