Счёт за API растёт не от числа запросов, а от того, сколько токенов уходит в каждый и по какой ставке. Кратную экономию дают три вещи: модель под задачу, кэш повторяющегося начала запроса и batch для того, что может подождать. Обрезка истории, пачки и уменьшение картинок срезают десятки процентов. Начните с того, куда уходят деньги.
Сначала разложите счёт
В каждом ответе API есть блок usage, где вендор пишет, сколько токенов он насчитал. prompt_tokens — вход: системный промпт, история, документы. completion_tokens — выход. У OpenAI и Anthropic в него входят токены рассуждений, черновик модели, которого нет в ответе: их число лежит в поле reasoning_tokens или thinking_tokens. Там же вендоры показывают, сколько входа прочитано из кэша.
Если вы работаете через нас, тот же журнал с ценой каждого запроса отдаёт GET /v1/usage (справочник). Скрипт ниже собирает последние 2 000 запросов и показывает, какая модель сколько стоит и сколько в среднем читает и пишет:
import os
from collections import defaultdict

import requests

BASE = "https://api.altrouter.ai/v1"
HEADERS = {"Authorization": f"Bearer {os.environ['ALTROUTER_API_KEY']}"}

stats = defaultdict(lambda: {"n": 0, "cost": 0.0, "prompt": 0, "completion": 0})
cursor = None
for _ in range(20):  # 20 страниц по 100 запросов
    params = {"limit": 100}
    if cursor:
        params["cursor"] = cursor
    page = requests.get(f"{BASE}/usage", headers=HEADERS, params=params, timeout=30).json()
    for row in page["data"]:
        s = stats[row["model"]]
        s["n"] += 1
        s["cost"] += row.get("cost_usd") or 0
        s["prompt"] += row.get("prompt_tokens") or 0
        s["completion"] += row.get("completion_tokens") or 0
    cursor = page.get("next_cursor")
    if not cursor:
        break

for model, s in sorted(stats.items(), key=lambda kv: -kv[1]["cost"]):
    print(f"{model:24} {s['n']:5} запр.  ${s['cost']:8.2f}  "
          f"вход {s['prompt'] // s['n']:6}  выход {s['completion'] // s['n']:5}")
Дальше всё зависит от того, что перевесит. Если средний вход в десятки раз больше выхода, деньги уходят на чтение, и работают кэш, обрезка истории и пачки. Если выход большой, а видимые ответы короткие, платите вы за рассуждения. Если одна модель забирает почти весь счёт, начинайте с неё.
Модель под задачу: разница в десятки раз
Классификация 100 000 обращений, на каждое 500 токенов входа и 50 выхода. Цены по нашему каталогу на 27.10.2026:
| Модель | Вход / выход за 1M | 100 000 классификаций |
|---|---|---|
claude-haiku-4-5 | $0,77 / $4,00 | $58,60 |
claude-opus-4-8 | $4,50 / $22,50 | $337,50 |
claude-haiku-5.5 | $0,085 / $0,425 | $6,38 |
claude-opus-5.5 | $3,40 / $17,00 | $255,00 |
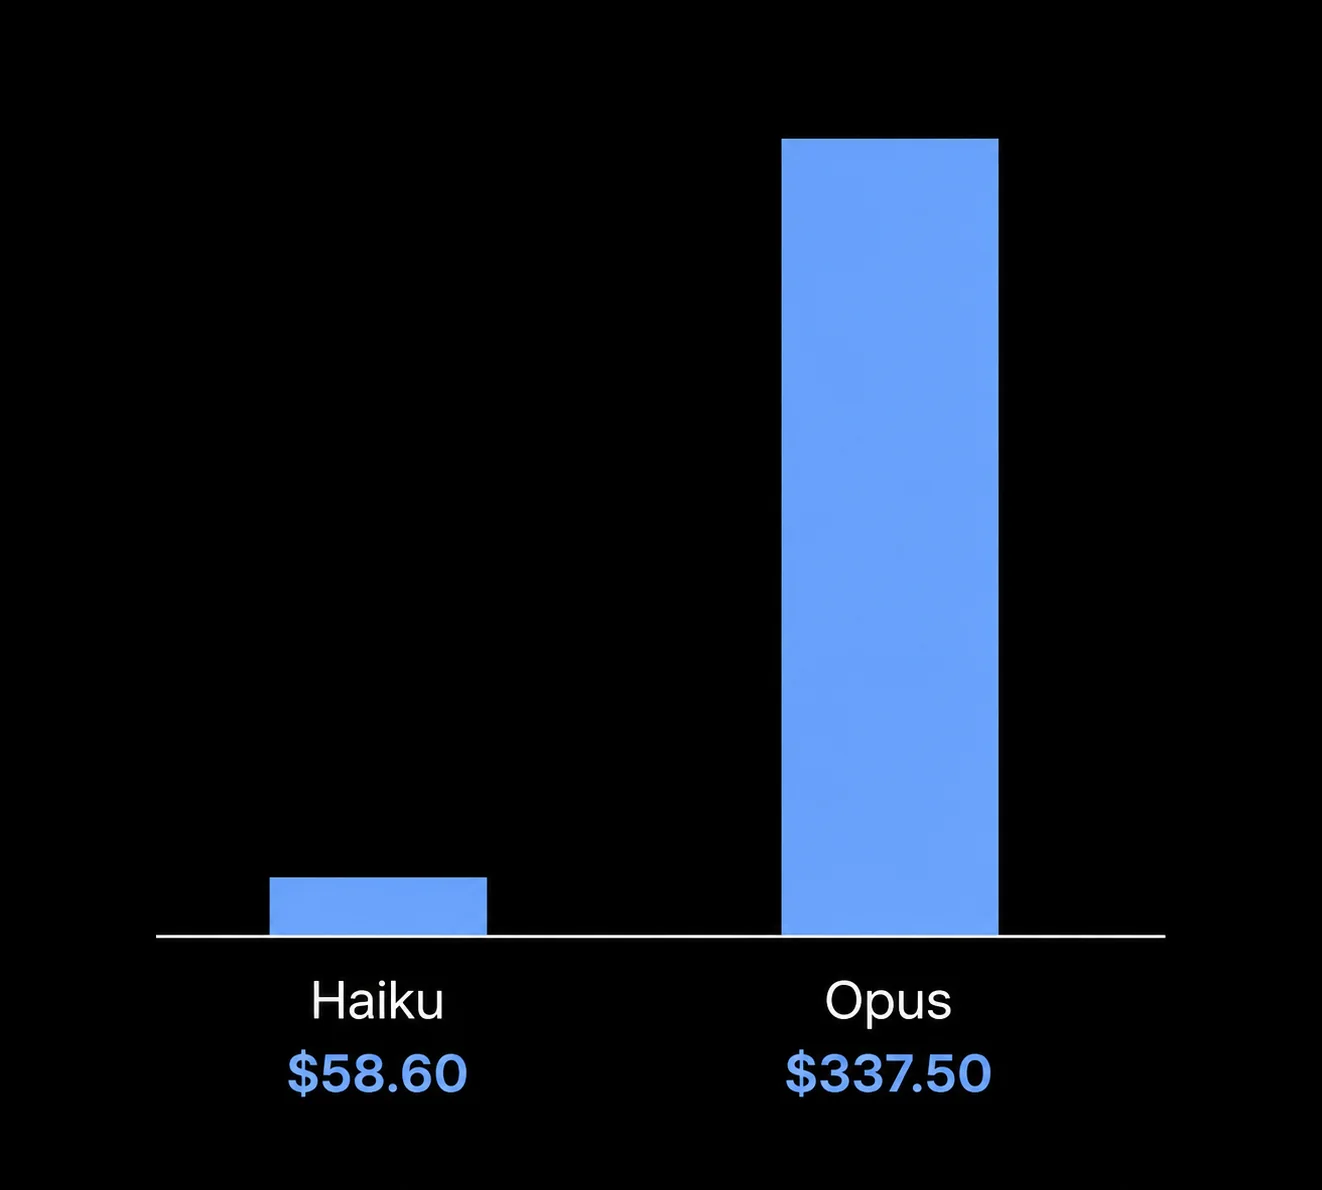
В поколении 4.x лёгкая модель была дешевле тяжёлой в 5,8 раза, в поколении 5.5 — в 40 раз. Задача «выбери категорию из списка» требует аккуратности, а не рассуждения, но проверьте это на своих данных: прогоните 200–300 размеченных примеров через обе модели и сравните долю совпадений.
Есть оговорка. Haiku 5.5 и Opus 5.5 по умолчанию думают, а Haiku 4.5 и Opus 4.8 — нет (Anthropic). Если на каждую классификацию уйдёт ещё 200 токенов рассуждений, Haiku 5.5 подорожает на $8,50, а Opus 5.5 — на $340. Как раздавать задачи по моделям в коде, мы разбирали в статье про маршрутизацию, цены остальных вендоров собраны в сравнении стоимости API.
Кэш: повторное начало запроса за 5–10% цены
Кэш — сохранённое начало запроса. Если следующий запрос начинается с того же текста, вендор не обрабатывает его заново и берёт за этот кусок малую долю цены входа. По прайсам на 29.10.2026 это 10% у большинства моделей OpenAI, Anthropic и Google, 5% у Claude Opus 5.5, Sonnet 5.5 и GPT-6.1 Sol. Первая запись дороже обычного входа: 1,25 цены у Anthropic и у OpenAI с GPT-5.6.
Условия у вендоров похожие:
- начало запроса должно совпадать полностью, поэтому неизменное (инструкция, описания инструментов, документ) ставят первым, а вопрос пользователя — в конец;
- префикс короче порога не кэшируется: 512 токенов у Claude 5.5, 1 024 у OpenAI с GPT-5.6, 4 096 у Gemini 3.8 Flash (Google);
- запись живёт ограниченное время: у Anthropic 5 минут по умолчанию и час за двойную цену, у OpenAI 30 минут и 12 часов в Responses API, у Google кэш неявный и включён сам.
Посчитаем бота поддержки на Claude Sonnet 5.5 по прайсу Anthropic: 45 000 запросов в месяц, неизменное начало на 4 000 токенов, 300 токенов вопроса, 300 ответа. Без кэша вход стоит $387 в месяц. С кэшем 4 000 токенов читаются по $0,10 за миллион ($18), вопрос идёт по полной цене ($27). Допустим, кэш пересоздаётся 100 раз в сутки после пауз, это ещё $30. Вход дешевеет с $387 до $75, ответ остаётся на $135.
🔴 Кэш ломается от одного символа в начале. Текущая дата, имя пользователя или случайный id в первой строке системного промпта делают каждый запрос новым. Там, где запись платная (у Anthropic и у OpenAI с GPT-5.6), каждый такой запрос оплачивается как запись, то есть на четверть дороже, чем без кэша вовсе.
Если вы работаете через посредника, проверьте, как он списывает повтор: отправьте два одинаковых длинных запроса подряд и сравните usage.cost. У нас цену чтения кэша публичный каталог не показывает, фактическое списание видно в том же usage.cost ответа (документация).
Batch: половина цены, если ответ может подождать сутки
Batch — пакет запросов, который вендор обрабатывает асинхронно. OpenAI, Anthropic и Google берут за него вдвое меньше и обещают результат в течение 24 часов, у Anthropic большинство пакетов готово за час (документация). xAI даёт скидку 20%. У Anthropic batch и кэш складываются.
Ночной разбор 10 000 документов по 40 000 токенов с выжимкой на 800 стоит на Gemini 3.8 Flash $330 по стандартному прайсу и $165 через Batch API. Через нас такой скидки нет: в нашем справочнике API нет batch-эндпоинта. Если основная нагрузка — ночные пачки документов, прямой batch у вендора выйдет дешевле.
Рассуждения и длина ответа
Новые модели думают по умолчанию, и платите вы за рассуждения по цене выхода. Просьба в промпте «не рассуждай» не помогает: Anthropic прямо пишет, что Sonnet 5.5 от такой инструкции надёжно меньше думать не начинает (документация). Работает параметр:
- у GPT-6 Luna рассуждение выключается значением
none, у GPT-6.1 Sol минимальный уровень —low(OpenAI); - у Claude Haiku 5.5 его выключает
thinking: {"type": "disabled"}, у Sonnet 5.5, Opus 5.5 и Fable 5.1 такой запрос вернёт 400, им снижаютeffort; - у Gemini 3.8 Flash минимальный уровень
low, у Gemini 3.5 Flash-Lite по умолчанию стоитminimal(Google).
На формальных задачах (классификация, извлечение полей, перевод коротких строк) начинайте с минимального уровня и поднимайте его, только если качество проседает.
🔴 Потолок длины ответа у OpenAI (max_output_tokens в Responses API) считает и рассуждения. Если поставить его слишком низко, модель может исчерпать лимит на черновике и вернуть пустой ответ, а вход и рассуждения будут оплачены. OpenAI советует на старте оставлять не меньше 25 000 токенов.
Видимый ответ короче делают формат и инструкция: «верни JSON с полями category и confidence» вместо «объясни и в конце дай JSON». Объяснение вы всё равно выбросите, а заплатите за него по цене выхода. У OpenAI для этого есть ещё параметр text.verbosity со значениями low, medium и high.
История диалога: каждый шаг оплачивает всю переписку
В чате каждый запрос везёт с собой всю историю. Пусть системный промпт занимает 1 000 токенов, вопрос — 150, ответ — 300. Первый ход читает 1 150 токенов, двадцатый — 9 700. За 20 ходов набегает 108 500 токенов входа.
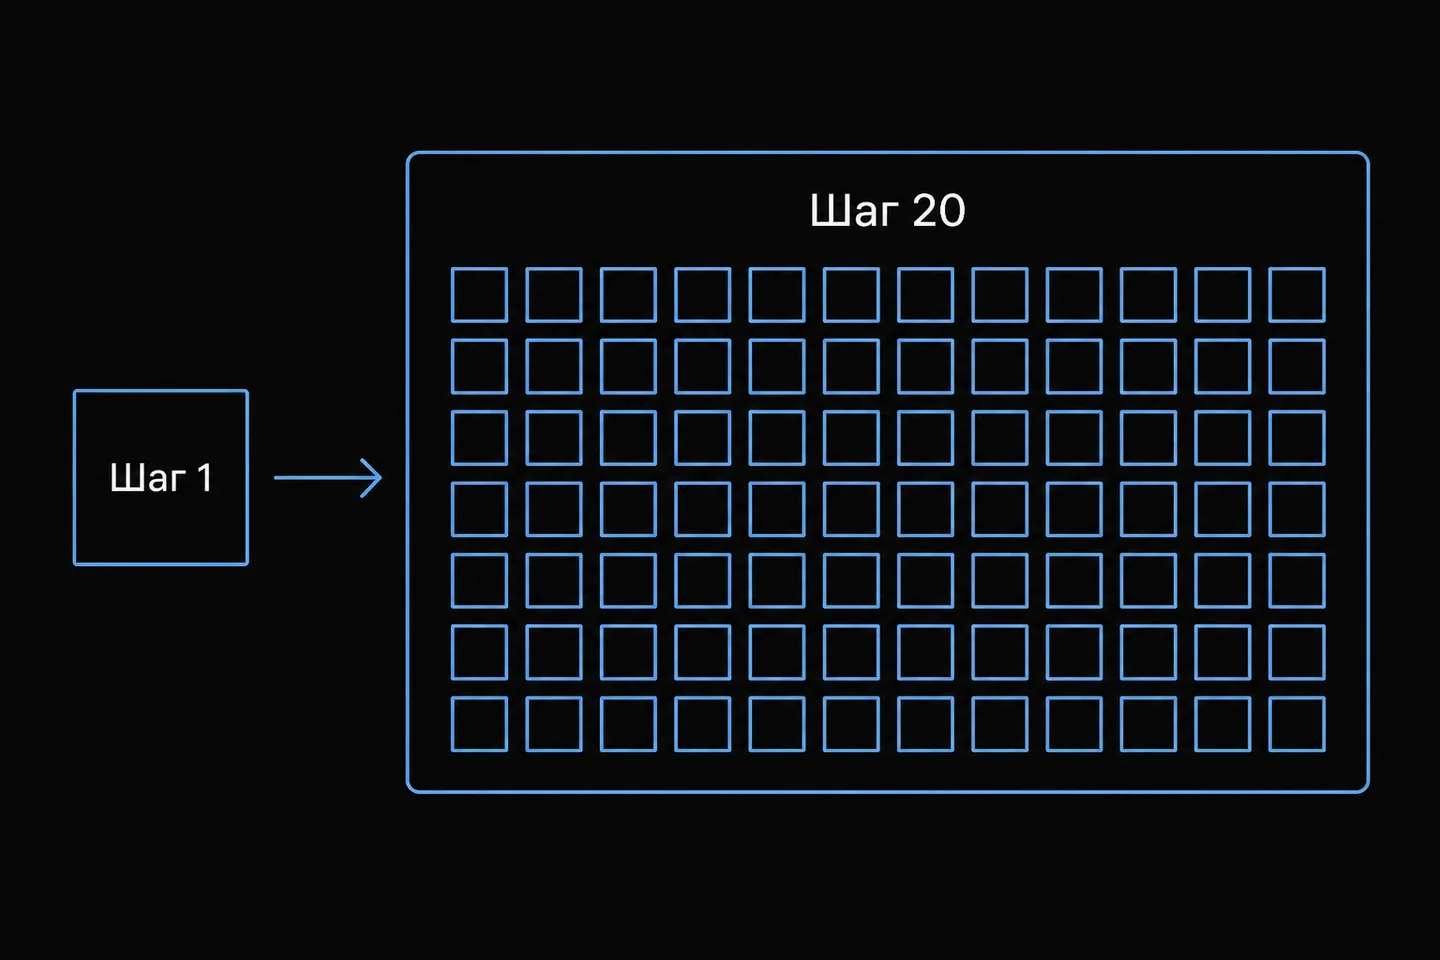
Если оставлять только три последних обмена, за те же 20 ходов выйдет 47 300 токенов, на 56% меньше. Когда пользователь сменил тему, сбрасывайте старую переписку целиком.
У приёма есть конфликт с кэшем. Скользящее окно меняет начало истории на каждом ходе, и закэшированный префикс перестаёт совпадать. Если кэш включён, надёжнее раз в 10–15 ходов заменять старую часть кратким пересказом: между пересказами начало остаётся тем же и читается из кэша. У агентов, которые на каждом шаге добавляют результаты инструментов, история растёт быстрее; разбор с формулой — в статье про ИИ-агентов.
Пачки однотипных элементов
Если обрабатывать элементы по одному, инструкция оплачивается столько раз, сколько элементов. Промпт на 800 токенов и десять товаров по 100 токенов: десять запросов прочитают 9 000 токенов, один запрос со списком — 1 800.
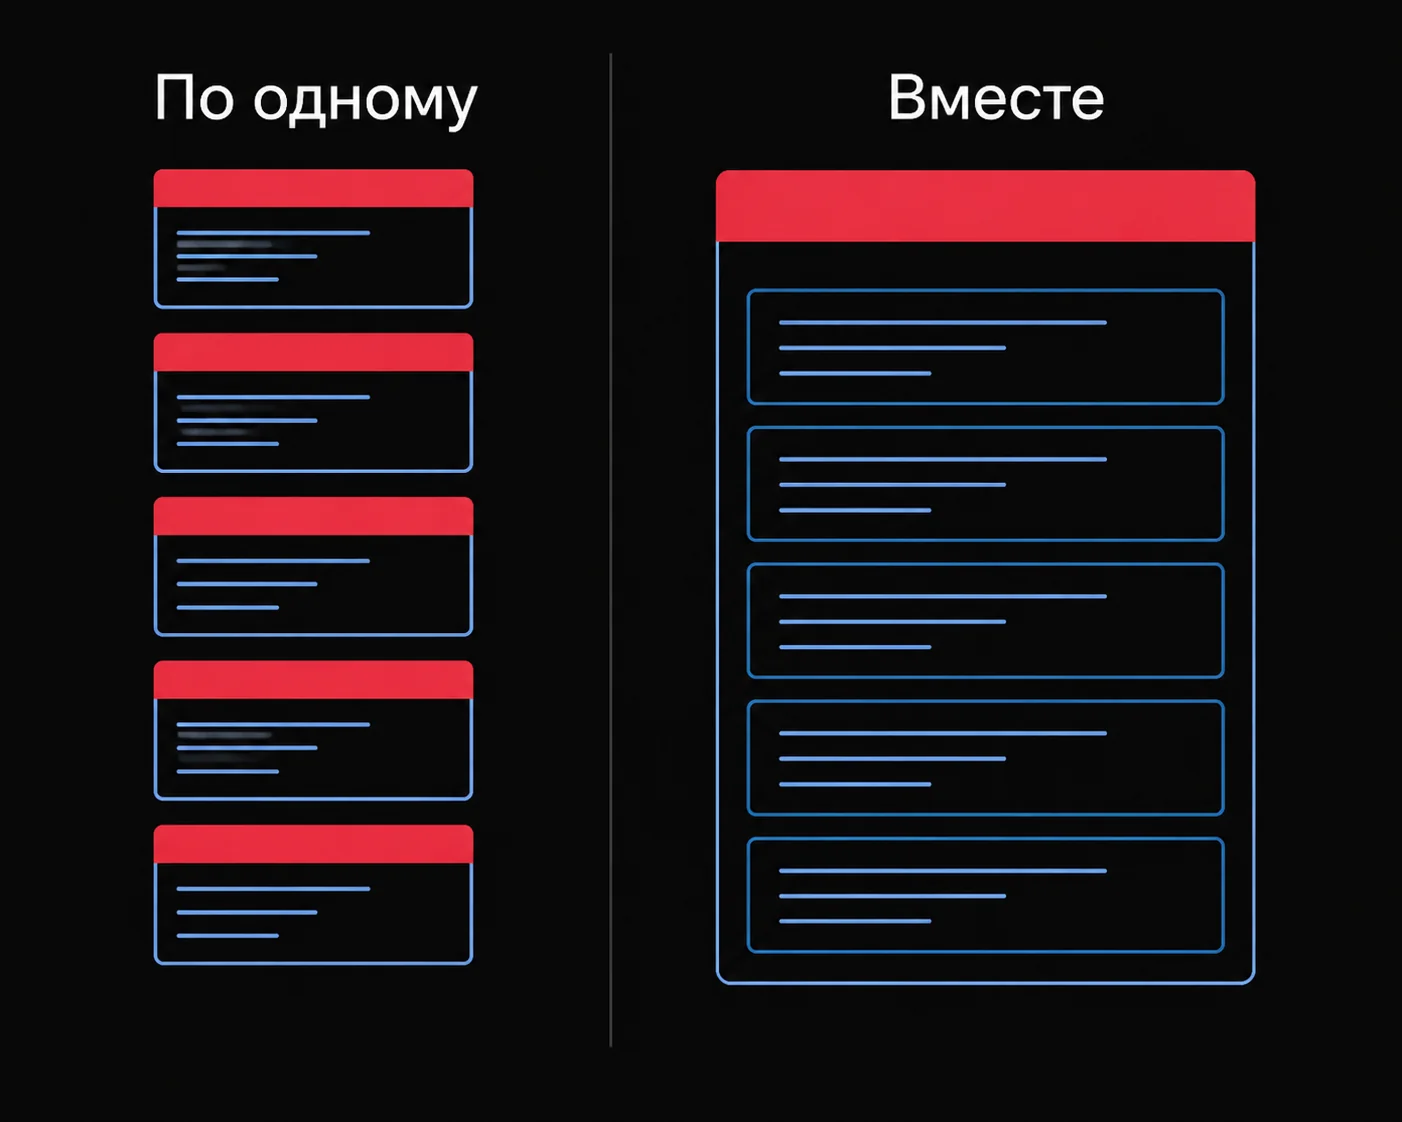
Для таких коротких промптов пачка выгоднее кэша: 800 токенов меньше порога OpenAI в 1 024, и кэшировать там нечего. Ограничение — точность. На длинных списках модель начинает пропускать и путать элементы, а одна ошибка заставляет переделывать всю пачку. Рабочий размер подбирают замером, обычно в пределах 5–20 элементов, и каждый элемент снабжают id, чтобы сверять ответ со входом.
Картинки во входе
Картинка тоже превращается в токены, и их число растёт с разрешением. У Claude формула открытая: ⌈ширина / 28⌉ × ⌈высота / 28⌉, у Claude 4.7 и новее до 4 784 токенов на картинку (Anthropic). Фото с телефона уменьшается до этого потолка, а кадр 1000×1000 занимает 1 296 токенов. У Gemini картинка до 384 пикселей стоит 258 токенов, крупная режется на плитки 768×768 по 258 токенов каждая (Google).
10 000 фото на Claude Sonnet 5.5 по прайсу Anthropic обойдутся в $95,68 в исходном размере и в $25,92 после уменьшения до 1000×1000. Полное разрешение нужно, только если модель должна прочитать мелкий текст.
Лимит трат как страховка
Лимит не снижает счёт, но ограничивает ущерб, когда ключ утёк или скрипт зациклился. У нас потолок ставится на каждый ключ на день, неделю, месяц или всё время, и после него запросы получают 402 spend_limit_exceeded (лимиты). Предохранитель мягкий: пачка одновременных запросов может немного его превысить. Отдельный ключ на каждый сценарий заодно показывает в журнале, какой продукт сколько тратит.
FAQ
Стоит ли сокращать системный промпт?
Если кэш работает, выигрыш небольшой. Промпт на 1 000 токенов в 100 000 запросах на GPT-6.1 Sol стоит $200 без кэша и около $10 при чтении из кэша по $0,10 за миллион. Важнее держать промпт неизменным и ставить его в начало запроса. Сокращение имеет смысл, когда промпт короче порога кэша или запросы приходят реже, чем живёт запись.
Подробнее: GPT-6.1 Sol: цены и параметры.
Дешевле ли писать промпты на английском?
Русский текст занимает больше токенов, чем английский, а насколько — зависит от токенизатора модели. Замеры собраны в статье сколько токенов в русском тексте. Переводить ради экономии пользовательские данные рискованно: ответ всё равно нужен на русском, а перевод туда и обратно добавляет и токены, и ошибки.
Можно ли кэшировать ответы на своей стороне?
Можно, если вопросы повторяются дословно: храните ответ по хешу нормализованного вопроса и отдавайте его без запроса к модели. Поиск «похожего» вопроса по эмбеддингам опаснее: два близких по формулировке вопроса могут требовать разных ответов, и пользователь получит чужой.
Подробнее: Хранение данных.