В августе мы советовали здесь Claude Sonnet 5 как модель для кода по умолчанию. На независимом прогоне Terminal-Bench 4.0 от 27.10.2026 он решает 10,61% задач, а Sonnet 5.5, вышедший 28 сентября по той же цене за токен, — 64,14%. Сейчас по умолчанию берите Claude Sonnet 5.5 или GPT-6.1 Sol, длинную самостоятельную работу в репозитории отдавайте Claude Opus 5.5, а модели сравнивайте по цене решённой задачи, а не токена.
Почему SWE-bench Verified больше не помогает выбрать
SWE-bench Verified — 500 задач из настоящих Python-репозиториев: модель получает описание бага и пишет патч, который должен пройти тесты. На официальной доске последняя запись в этом рейтинге датирована 26.02.2026, верхний результат 79,2% у агентов на Claude Opus 4.5. Моделей, вышедших позже, там нет.
23.02.2026 OpenAI объявила, что перестаёт публиковать этот бенчмарк: задачи и их решения попали в обучающие данные, а часть тестов составлена с ошибками. Компания предложила перейти на SWE-bench Pro.
Каждый вендор теперь выбирает свои тесты. В анонсах Opus 5.5 (22.09) и Sonnet 5.5 (28.09) Anthropic приводит Terminal-Bench 4.0, FrontierCode и CursorBench, а SWE-bench не упоминает. Google в анонсе Gemini 4 Argon (30.09) показывает 77,9% на DeepSWE. Таблицы разных вендоров между собой почти не сравнить: у прогонов разная обвязка, разный уровень рассуждений и разные соперники.
Остаются независимые прогоны с одной обвязкой для всех. Мы берём Terminal-Bench 4.0 от Vals.ai: все модели работают через один минимальный агент, mini-swe-agent, у которого есть только bash. Каждую задачу модель проходит трижды, в зачёт идёт среднее.
Уровень рассуждений для каждой модели Vals не указывает. С цифрами вендоров результаты расходятся на 1–2 пункта: у Opus 5.5 — 65,15% против 66,4% в анонсе Anthropic, у GPT-6 Astra — 59,60% против 57,9% в той же таблице Anthropic со ссылкой на OpenAI.
Одна оговорка до таблицы. Terminal-Bench проверяет не только код: из 66 задач к разработке относятся 18, остальные — наука, машинное обучение, администрирование, железо, безопасность и медиа. По оценке Vals, у эксперта задача занимает в медиане около четырёх часов. Это экзамен для агента на долгой самостоятельной работе в терминале, а не просьба написать функцию.
Одинаковый прогон: сколько задач решено и во что обошлась каждая
В таблице модели из нашего каталога с результатами Vals на 27.10.2026. Последний столбец — наш расчёт: средние расходы на задачу, делённые на долю решённых. В него входят и деньги, потраченные на провалы.
| Модель | Решено | $ за задачу | $ за решённую задачу |
|---|---|---|---|
claude-opus-5.5 | 65,15% | 13,20 | 20,26 |
claude-sonnet-5.5 | 64,14% | 16,51 | 25,74 |
gpt-6-astra | 59,60% | 9,58 | 16,07 |
claude-fable-5.1 | 58,08% | 17,18 | 29,58 |
gpt-6.1-sol | 55,05% | 1,72 | 3,12 |
claude-haiku-5.5 | 36,36% | 3,12 | 8,58 |
claude-opus-4-8 | 23,23% | 17,14 | 73,78 |
gemini-3.8-flash | 19,70% | 8,65 | 43,91 |
gpt-6-luna | 13,64% | 0,35 | 2,57 |
claude-sonnet-5 | 10,61% | 26,05 | 245,52 |
Источник: Vals.ai, обновление 27.10.2026. Расходы на задачу взяты у Vals, это не наши цены. Пример расчёта для Opus 5.5: $13,20 / 0,6515 = $20,26.
Opus 5.5 и Sonnet 5.5 разделяет один пункт. Третье и четвёртое места у Vals заняли Kimi K3.1 Pro (63,64%) и Gemini 4 Carbon (63,13%). Их в нашем каталоге нет, как и Gemini 4 Argon (57,58%). Kimi K3, которая у нас есть, решает 17,17% задач при $12,48 за задачу.
Самые дорогие модели в коде не самые сильные. Fable 5.1 и GPT-6 Astra стоят у вендоров $10 за миллион токенов входа и $50 за миллион выхода, в 2,5 раза дороже Opus 5.5, а задач решают меньше. В собственной таблице Anthropic картина та же: на Terminal-Bench 4.0 у Fable 5.1 55,8%, у Opus 5.5 — 66,4%. В обзоре моделей Anthropic советует начинать с Opus 5.5, а Fable 5.1 предлагает для тяжёлых рассуждений, долгой агентной работы и случаев, когда Opus 5.5 не справился даже на высоком уровне рассуждений.
GPT-6.1 Sol отстаёт от лидера на 10 пунктов, зато решённая задача стоит у него $3,12, в 6,5 раза дешевле, чем у Opus 5.5. OpenAI на странице модели так его и описывает: качество, близкое к Astra, за меньшие деньги.
Низ таблицы объясняет, почему статья переписана. Sonnet 5 мы советовали по умолчанию, Opus 4.8 — для сложных задач, если не справится Opus 4.5. На этом прогоне они решают 11% и 23% задач, а решённая задача у Sonnet 5 стоит $245,52. Haiku 5.5 и GPT-6 Luna вендоры сами позиционируют для массовых задач. Длинный агентный цикл они, как и Gemini 3.8 Flash, не тянут.
Почему дешёвая за токен модель тратит на задачу больше
Sonnet 5.5 вдвое дешевле Opus 5.5 за токен, а задача у Vals обходится ему дороже: $16,51 против $13,20. Причина в объёме. По данным Vals, на одну задачу Opus 5.5 расходует 28,27 млн токенов, Sonnet 5.5 — 58,53 млн и работает на 18 минут дольше.
Из тех же цифр видна роль кэша. Кэш — сохранённое начало запроса: если следующий запрос начинается с того же текста, вендор берёт за этот кусок малую долю цены. Агент на каждом шаге заново отправляет всю историю, поэтому большая часть его входа — перечитанный контекст.
Если бы 28,27 млн токенов Opus 5.5 шли по полной цене входа, $4 за миллион, задача стоила бы $113,08. Vals показывает $13,20, в 8,6 раза меньше. Как Vals считает стоимость, на странице не написано, но объяснить такую разницу может только кэш: за пакетную обработку Anthropic даёт скидку 50%, а чтение кэша у Opus 5.5 стоит $0,20 вместо $4 (прайс Anthropic).
У Opus 5.5 и Sonnet 5.5 чтение кэша стоит 5% цены входа. GPT-6.1 Sol берёт за кэш $0,10 вместо $2 (прайс OpenAI), Gemini 4 Argon даёт на кэшированный вход скидку 95% (анонс Google).
🔴 Это касается любого посредника, и нас тоже. Скидка к базовой цене входа ничего не говорит о стоимости агентной сессии, где большая часть входа — перечитанный контекст: итог решает то, как посредник считает кэш.
Прежде чем переводить агента, прогоните одну реальную сессию. В каждом нашем ответе есть поле usage.cost со списанием за запрос (документация): сложите его и сравните с расчётом по прайсу вендора. Почему агент дорожает с каждым шагом, мы разбирали в статье про растущую историю переписки.
Цена токена у вендора, у нас и где она меняется посреди запроса
| Модель | Вендор, вход / выход | У нас, вход / выход | Ниже цены вендора |
|---|---|---|---|
claude-opus-5.5 | $4 / $20 | $3,40 / $17,00 | 15% |
claude-sonnet-5.5 | $2 / $10 | $1,70 / $8,50 | 15% |
gpt-6.1-sol | $2 / $10 | $1,70 / $8,50 | 15% |
claude-haiku-5.5 | $0,10 / $0,50 | $0,085 / $0,425 | 15% |
gpt-6-luna | $0,10 / $0,50 | $0,10 / $0,50 | по цене вендора |
gemini-3.8-flash | $0,75 / $3,75 | $0,64 / $3,19 | 15% |
gpt-6-astra, claude-fable-5.1 | $10 / $50 | $8,50 / $42,50 | 15% |
Цены за миллион токенов. Вендоры — прайсы Anthropic, OpenAI и Google на 29.10.2026, наши — каталог на 27.10.2026.
Миллион токенов контекста теперь есть у Claude 5.5, у GPT-6.1 Sol (1,05 млн) и у Gemini. Размер окна перестал отличать модели друг от друга. Отличает их цена длинного запроса.
Прайс из таблицы действует не всегда. У GPT-6.1 Sol запрос длиннее 272 тыс. токенов входа стоит вдвое дороже на входе и в полтора раза на выходе, причём целиком (OpenAI). У Haiku 5.5 порог ниже: после 100 тыс. токенов промпта цена растёт в пять раз, до $0,50 / $2,50 (Anthropic). Gemini 3.8 Flash с 01.01.2027 подорожает вдвое, до $1,50 / $7,50 (Google). У Opus 5.5 и Sonnet 5.5 весь миллион контекста идёт по обычной цене.
Как у нас списан конкретный длинный запрос, покажет usage.cost в ответе.
Какую модель на какую работу
- Длинная самостоятельная работа агента в репозитории: рефакторинг, который задевает много файлов, миграция, поиск бага по логам. Берите
claude-opus-5.5: у него лучший результат на прогоне Vals, а Anthropic в анонсе Sonnet 5.5 пишет, что на сложной открытой работе Opus 5.5 «явно сильнее». - Повседневная работа: функция с тестами, разбор чужого модуля, ревью дифа. Подходят
claude-sonnet-5.5иgpt-6.1-sol. Sonnet 5.5 почти догоняет Opus по доле решённых задач. GPT-6.1 Sol решает меньше, но решённая задача у него в 6,5 раза дешевле. Глубину рассуждения у GPT-6.1 Sol задаёт параметрreasoning_effort, отlowдоxhigh: на рутине держите его низким. - Массовая механика: докстринги, однотипные тесты, разметка ошибок по категориям, сообщения коммитов. Хватит
claude-haiku-5.5илиgpt-6-luna. Длинный агентный цикл им не отдавайте: на Terminal-Bench 4.0 они решают 36% и 14% задач.
На вашем репозитории порядок может поменяться. Дешёвая проверка — 20–30 уже решённых задач из вашего трекера с понятным критерием «готово», прогнанные через две-три модели с одинаковым промптом. Как потом раздавать задачи по моделям в коде, мы разбирали в статье про маршрутизацию.
Ревью дифа в CI: сколько стоит один запрос
Модель можно встроить в разработку и без агента, например через ревью изменений в пайплайне. Скрипт берёт диф ветки, отправляет его модели и печатает замечания вместе со списанием:
import os
import subprocess

from openai import OpenAI

client = OpenAI(
    base_url="https://api.altrouter.ai/v1",
    api_key=os.environ["ALTROUTER_API_KEY"],
)

diff = subprocess.run(
    ["git", "diff", "origin/main...HEAD"],
    capture_output=True, text=True, check=True,
).stdout

r = client.chat.completions.create(
    model="claude-sonnet-5.5",
    messages=[
        {"role": "system", "content": "Ты ревьюер. Ищи ошибки в логике и безопасности, стиль не трогай. Формат: файл, строка, проблема."},
        {"role": "user", "content": diff},
    ],
    max_tokens=1500,
)

print(r.choices[0].message.content)
usage = r.usage.model_dump()
print(usage["prompt_tokens"], usage["completion_tokens"], usage.get("cost"))
max_tokens — потолок длины ответа, который ставите вы. Чтобы сменить модель, достаточно поменять строку model=.
Посчитаем диф на 3000 токенов и ответ на 800 по нашим ценам. Формула: (вход × цена входа + выход × цена выхода) / 1 000 000.
| Модель | Расчёт | За запрос | 500 ревью в месяц |
|---|---|---|---|
claude-haiku-5.5 | 3000 × 0,085 + 800 × 0,425 | $0,0006 | $0,30 |
gpt-6.1-sol | 3000 × 1,70 + 800 × 8,50 | $0,0119 | $5,95 |
claude-sonnet-5.5 | 3000 × 1,70 + 800 × 8,50 | $0,0119 | $5,95 |
claude-sonnet-4-6 | 3000 × 2,6843 + 800 × 13,50045 | $0,0189 | $9,43 |
claude-opus-5.5 | 3000 × 3,40 + 800 × 17,00 | $0,0238 | $11,90 |
claude-opus-4-8 | 3000 × 4,50 + 800 × 22,50 | $0,0315 | $15,75 |
Диаграмма ниже — три строки этой таблицы: Sonnet 5.5, Sonnet 4.6 и Opus 4.8.
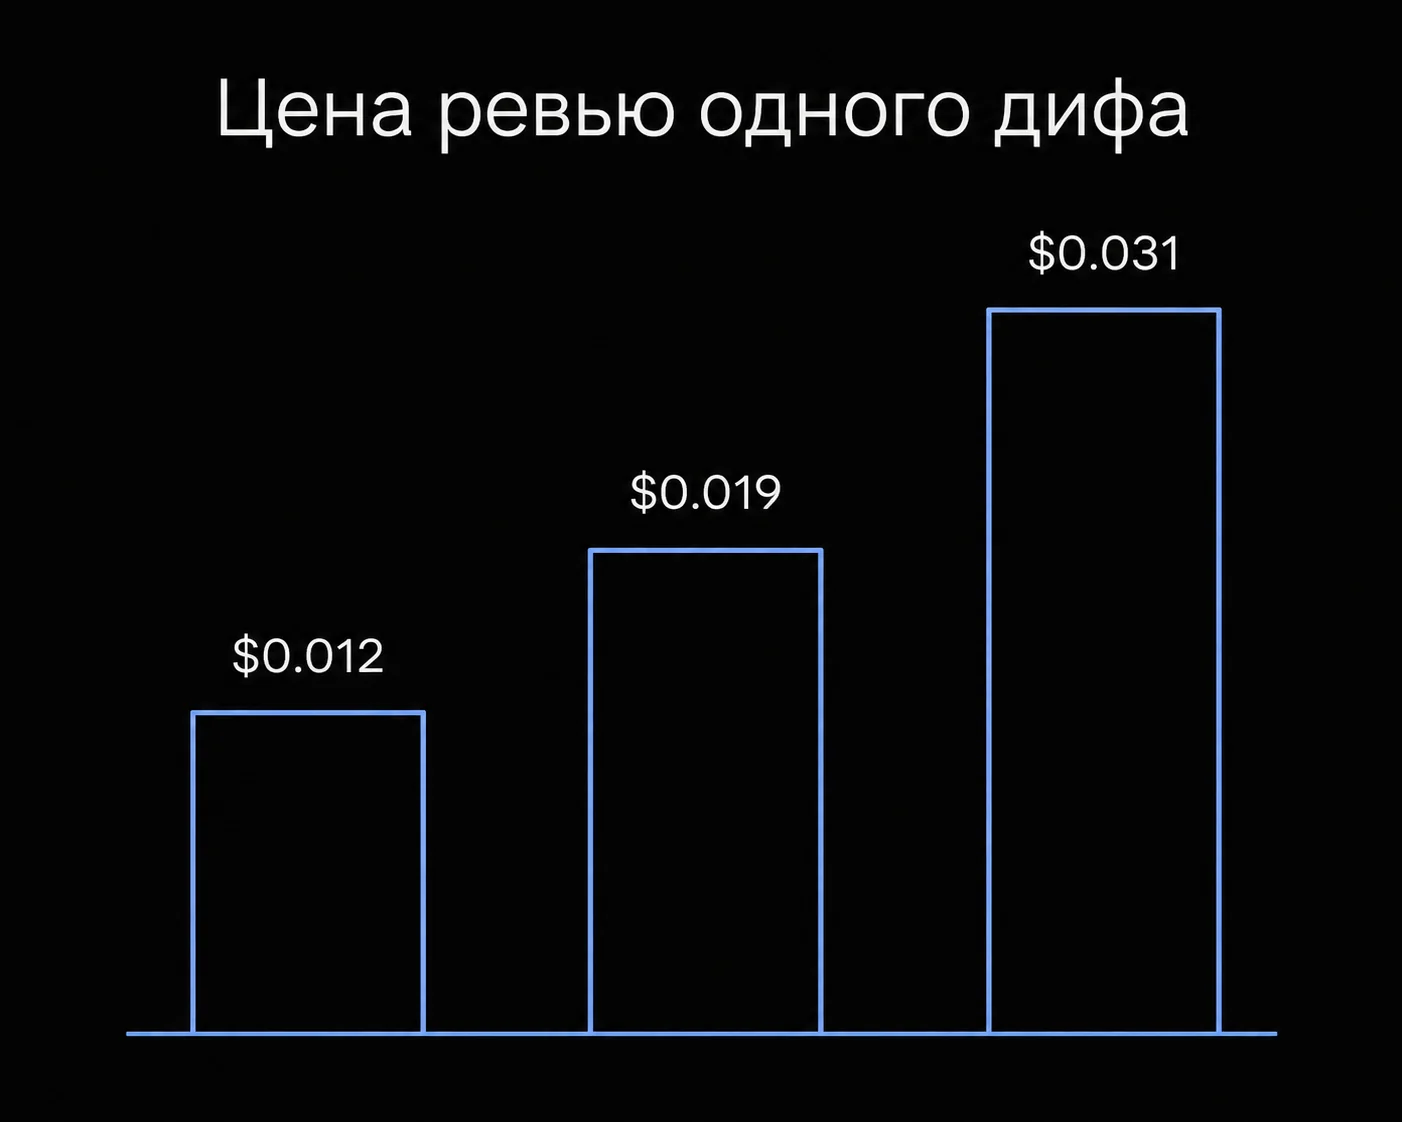
Расчёт — нижняя граница. Модели с рассуждениями пишут черновик, которого нет в ответе, а платите вы за него по цене выхода. Сколько токенов выхода оплачено на самом деле, видно в usage.completion_tokens.
В деньгах разброс небольшой: от $0,30 до $15,75 в месяц на 500 ревью. Важнее другое: самая дорогая строка, Opus 4.8, на прогоне Vals решает 23% задач против 65% у Opus 5.5, который на четверть дешевле.
Агент в терминале и плагин в редакторе
Claude Code — агент Anthropic для терминала: читает файлы, правит код, запускает команды. OpenAI-совместимый API он не понимает, ему нужен формат Anthropic. С 27.10.2026 Claude Code подключается к нам через Anthropic-совместимый /v1/messages:
export ANTHROPIC_BASE_URL=https://api.altrouter.ai
export ANTHROPIC_AUTH_TOKEN=ar-...
export ANTHROPIC_MODEL=claude-opus-5.5
claude
Что при этом работает, а что нет, мы собрали в статье Claude Code в России.
Расширения редакторов и агенты, где можно задать свой адрес API и ключ, подключаются к OpenAI-совместимому адресу https://api.altrouter.ai/v1. Как за минуту проверить конкретный инструмент, описано в разборе своего ключа в редакторе. Cursor через нас мы не проверяли. Своего плагина с автодополнением по Tab у нас нет: мы даём API, а не редактор.
Если нужно именно автодополнение в IDE без зарубежных сервисов, есть российские ассистенты. SourceCraft Code Assistant от Яндекса работает в VS Code, VSCodium и JetBrains: автодополнение, чат и агентный режим, расход учитывается в нейрокредитах. GigaCode от Сбера живёт на платформе GitVerse и работает в PyCharm, VS Code и Jupyter. В таблице Vals их моделей нет, так что сравнить их с Claude и GPT на одном прогоне не получится.
Напрямую Anthropic, OpenAI и Google Россию не обслуживают: на 29.10.2026 её нет в списках поддерживаемых стран у Anthropic, OpenAI и Gemini API. Баланс у нас пополняется картой РФ, СБП или криптой.
FAQ
Cursor и Copilot — это тоже нейросети для кода?
Это инструменты, а не модели. Редактор отправляет ваш код и запрос в языковую модель, свою или стороннюю, и показывает ответ — подсказку или правку. Качество ответа задаёт модель, удобство работы — инструмент. Через API модель выбираете вы сами и платите за токены, а не за подписку.
Подробнее: Каталог моделей и цены.
Нужен ли для кода контекст в миллион токенов?
Такой контекст есть у Claude 5.5, GPT-6.1 Sol и Gemini, поэтому выбирать по нему уже не приходится. Агенты вроде Claude Code читают файлы по мере надобности, а не загружают репозиторий целиком. Большое окно помогает, когда ошибка сидит на стыке модулей, но каждый шаг с длинным контекстом оплачивается заново, а у части моделей длинный запрос ещё и дороже за токен.
Подробнее: GPT-6.1 Sol: цены и параметры.
Что делать, когда выйдут новые модели?
Держите id модели в конфиге, а не в коде, и заведите свой набор из 20–30 задач с проверкой результата. Новую модель прогоняйте на нём и сравнивайте долю решённых задач и сумму usage.cost. Sonnet 5.5 вышел по той же цене, что Sonnet 5, и на Terminal-Bench 4.0 решает в шесть раз больше задач: без своего набора такую смену легко пропустить.
Подробнее: Каталог моделей и цены.