Код для Gemini API, написанный по прошлогоднему гайду, в конце октября 2026 года обычно запускается без ошибок, но делает уже не то, что задумано. Gemini 3 Pro Google отключила в марте, запросы к gemini-3.5-flash с 8 октября обслуживает другая модель, а temperature на новых Flash игнорируется молча. Для новых проектов Google советует Gemini 3.5 Flash-Lite или 3.8 Flash, причём у 3.8 Flash уровень рассуждений лучше задавать явно.
Какие модели живы на 29 октября и какие id уже не те
Список моделей Google обновила 28.10.2026. Рассуждения в таблице — черновик, который модель пишет до ответа. Вы его не видите, но платите за него по цене выхода (Google).
| Модель (id у Google) | Статус у Google | Рассуждения по умолчанию | В каталоге altrouter |
|---|---|---|---|
Gemini 4 Argon (gemini-4-argon) | стабильная, флагман, с 13.10.2026 | medium | нет |
Gemini 3.8 Flash (gemini-3.8-flash) | стабильная, с 02.09.2026 | medium | gemini-3.8-flash |
Gemini 3.6 Flash (gemini-3.6-flash) | стабильная, прошлое поколение Flash | medium | gemini-3.6-flash |
Gemini 3.5 Flash-Lite (gemini-3.5-flash-lite) | стабильная | minimal | gemini-3.5-flash-lite |
Gemini 3.1 Flash-Lite (gemini-3.1-flash-lite) | стабильная | не указано | gemini-3.1-flash-lite |
Gemini 3.1 Pro (gemini-3.1-pro-preview) | preview | high | gemini-3.1-pro |
Gemini 3 Flash (gemini-3-flash-preview) | preview | high | gemini-3-flash |
| Gemini 2.5 Pro и 2.5 Flash | только для тех, кто вызывал их раньше | включены | есть |
Уровни рассуждений взяты из документации Google, даты выхода из changelog. Доступ к моделям 2.5 Google ограничила 18.09.2026: новые проекты их не получат, но и отключать их не обещают.
Три id из старых гайдов теперь ведут к другой модели:
gemini-3-pro-previewотключена 09.03.2026, запросы идут в 3.1 Pro (deprecations);- запросы к
gemini-3.5-flashс 08.10.2026 обслуживаетgemini-3.6-flash; - запросы к
gemini-3.7-flashс той же даты обслуживаетgemini-3.8-flash(changelog).
🔴 Переадресация тихая: ошибки нет, ответ приходит от другой модели. Регрессионные тесты, которые вы прогоняли на 3.5 Flash, на этом id теперь проверяют 3.6 Flash. В нашем каталоге на 27.10.2026 id gemini-3-pro, gemini-3.5-flash и gemini-3.7-flash ещё есть, но новый код пишите на актуальных: 3.6 Flash, 3.8 Flash, 3.1 Pro.
По имени модели цену не угадать. Gemini 3.5 Flash-Lite новее 3.1 Flash-Lite, а стоит дороже: $0,30 и $2,50 за миллион токенов входа и выхода против $0,25 и $1,50 по прайсу Google на 29.10.2026. А 3.6 Flash Google выпустила дешевле 3.5 Flash. Полная таблица цен и расчёт счёта на сценариях — в разборе сколько стоит Gemini API.
Три способа вызвать модель
Нативный API Google
Quickstart теперь начинается с Interactions API: запрос POST /v1beta/interactions, пакет google-genai, ключ в переменной GEMINI_API_KEY, в примерах модель gemini-3.8-flash. Старый метод generateContent по-прежнему документирован. Live API для голоса, загрузка файлов и поиск по ним есть только здесь. С 26.10.2026 новые платные проекты по умолчанию хранят запросы на стороне Google (store=true), отключается это флагом store=false в запросе или в настройках (changelog).
OpenAI-совместимый слой Google
Ключ тот же, библиотека — openai, меняется base_url, то есть адрес, куда SDK отправляет запросы: https://generativelanguage.googleapis.com/v1beta/openai/. Работают чат, стриминг, вызов функций, структурированный ответ, эмбеддинги и пакетные запросы. Google называет этот слой бетой, и загрузка файлов через него не работает. Параметр reasoning_effort Google переводит в свой уровень рассуждений, и вместе с нативным thinking_level его передавать нельзя.
OpenAI-совместимый шлюз
Так устроен altrouter: один ключ к Gemini, Claude и GPT, оплата картой РФ, СБП или криптой. Ограничений у шлюза больше, чем у слоя Google. Мы принимаем только формат OpenAI и Anthropic-совместимый /v1/messages, поэтому google-genai, Interactions API и загрузка файлов не подключатся, а пакетного режима нет. Gemini 4 Argon в нашем каталоге на 27.10.2026 тоже нет.
Если продукт держится на Live API или поиске по файлам, нужен нативный API. Пакетные запросы за полцены есть и в совместимом слое Google. Если код уже написан под OpenAI SDK и моделей несколько, хватит совместимого слоя или шлюза.
Ключ у Google: auth-ключи, предоплата и 402
Ключ выпускается в AI Studio, но правила поменялись весной. С 28.05.2026 новые ключи там по умолчанию создаются как auth-ключи: они привязаны к сервисному аккаунту и ограничены Gemini API. Стандартный ключ без ограничений Google отклоняет (документация по ключам). Если ключ создан в Cloud Console по старой инструкции, ограничьте его Gemini API, иначе запросы не пройдут.
Частая ловушка в окружении: если заданы и GEMINI_API_KEY, и GOOGLE_API_KEY, библиотеки Google берут второй. Старый ключ в GOOGLE_API_KEY перебьёт новый.
Платный тир включается привязкой биллинга и предоплатой от $5 (биллинг). По умолчанию работает предоплата: когда баланс доходит до нуля, запросы получают 402 — ответ «денег нет». У тиров есть потолок трат за расчётный период: $250 на первом тире, $2 000 на втором после $100 оплат и трёх дней. Достигнет счёт потолка — Google приостановит все проекты этого биллинг-аккаунта до следующего цикла.
Из России этот путь закрыт: страны нет в списке регионов Gemini API на 22.10.2026, а карты российских банков с марта 2022 года не работают за рубежом. Что именно недоступно и что остаётся, разобрано в статье про Gemini в России.
Что молча меняется в коде под Gemini 2.5
Google описала ломающие изменения в гайде по 3.6 Flash и 3.5 Flash-Lite и предупредила, что они распространяются на все следующие модели.
temperature,top_pиtop_kобъявлены устаревшими и игнорируются. Ручка разброса ответов больше ничего не крутит, а в следующих поколениях Google обещает за них ошибку 400. Уберите их из запросов. Для стабильного ответа Google советует правила в системной инструкции или жёсткую схему ответа.- Нельзя заканчивать запрос репликой модели. Приём «начни ответ за модель с
{» теперь получает 400. candidate_count, то есть несколько вариантов ответа за один вызов, не поддерживается с Gemini 3.thinking_budgetв токенах заменён наthinking_levelс уровнями.
Самое дорогое изменение касается рассуждений: у Gemini 3 и 2.5 Pro их нельзя выключить. Значение reasoning_effort: "none" работает только у моделей 2.5 Flash. По умолчанию 3.8 Flash рассуждает на уровне medium, а 3.1 Pro на уровне high. Если код писали под Gemini 2.5 Flash с выключенными рассуждениями, после смены модели оплачиваемый выход вырастет, хотя видимый ответ останется прежним.
Первый вызов через OpenAI-клиент
Ниже минимальный запрос через шлюз. Чтобы вызывать Google напрямую, поменяйте base_url на адрес Google, ключ на ключ из AI Studio, а id моделей сверьте со списком Google: 3.1 Pro там называется gemini-3.1-pro-preview.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["ALTROUTER_API_KEY"],
    base_url="https://api.altrouter.ai/v1",
)

resp = client.chat.completions.create(
    model="gemini-3.8-flash",
    reasoning_effort="low",  # у 3.8 Flash по умолчанию medium
    max_tokens=2000,
    messages=[
        {"role": "system", "content": "Определи тему обращения: оплата, доставка или возврат. Ответ — одно слово."},
        {"role": "user", "content": "Заказ 4471 оплатил позавчера, статус до сих пор «в обработке»."},
    ],
)

u = resp.usage
hidden = u.total_tokens - u.prompt_tokens - u.completion_tokens

print(resp.choices[0].message.content)
print("finish_reason:", resp.choices[0].finish_reason)
print("вход:", u.prompt_tokens, "видимый выход:", u.completion_tokens, "скрыто:", hidden)
print("списано, $:", getattr(u, "cost", None))
max_tokens — потолок длины ответа, который ставите вы. Если finish_reason пришёл со значением length, ответ упёрся в этот потолок и оборвался. usage — блок, где API пишет, сколько токенов посчитало. В нашем замере через altrouter 22.09.2026 скрытые рассуждения Gemini не входили в completion_tokens и были видны только как разница total − prompt − completion, поэтому код считает её отдельно. Поле cost показывает, сколько списано с баланса в долларах (логи и стоимость).
Насколько это заметно, показал тот же замер. На коротком ответе клиенту у 3.8 Flash было 1 101 скрытый токен при 65 видимых, то есть токенов выхода, за которые Google берёт деньги, оказалось почти в 18 раз больше видимых. Разбор с тремя моделями — в статье про Gemini в России. Перед запуском прогоните 30–50 своих типичных запросов с тем reasoning_effort, который пойдёт в прод, и посмотрите на среднее «скрыто».
Контекст 1M: когда класть документ целиком
Контекст — всё, что модель видит за один запрос: инструкция, история и документы. У всех текущих моделей Gemini он около миллиона токенов. По оценке Google, это примерно 50 000 строк кода или восемь романов на английском. Для русского текста Google оценки не даёт, поэтому объём проверяйте на своих документах по полю usage.prompt_tokens.
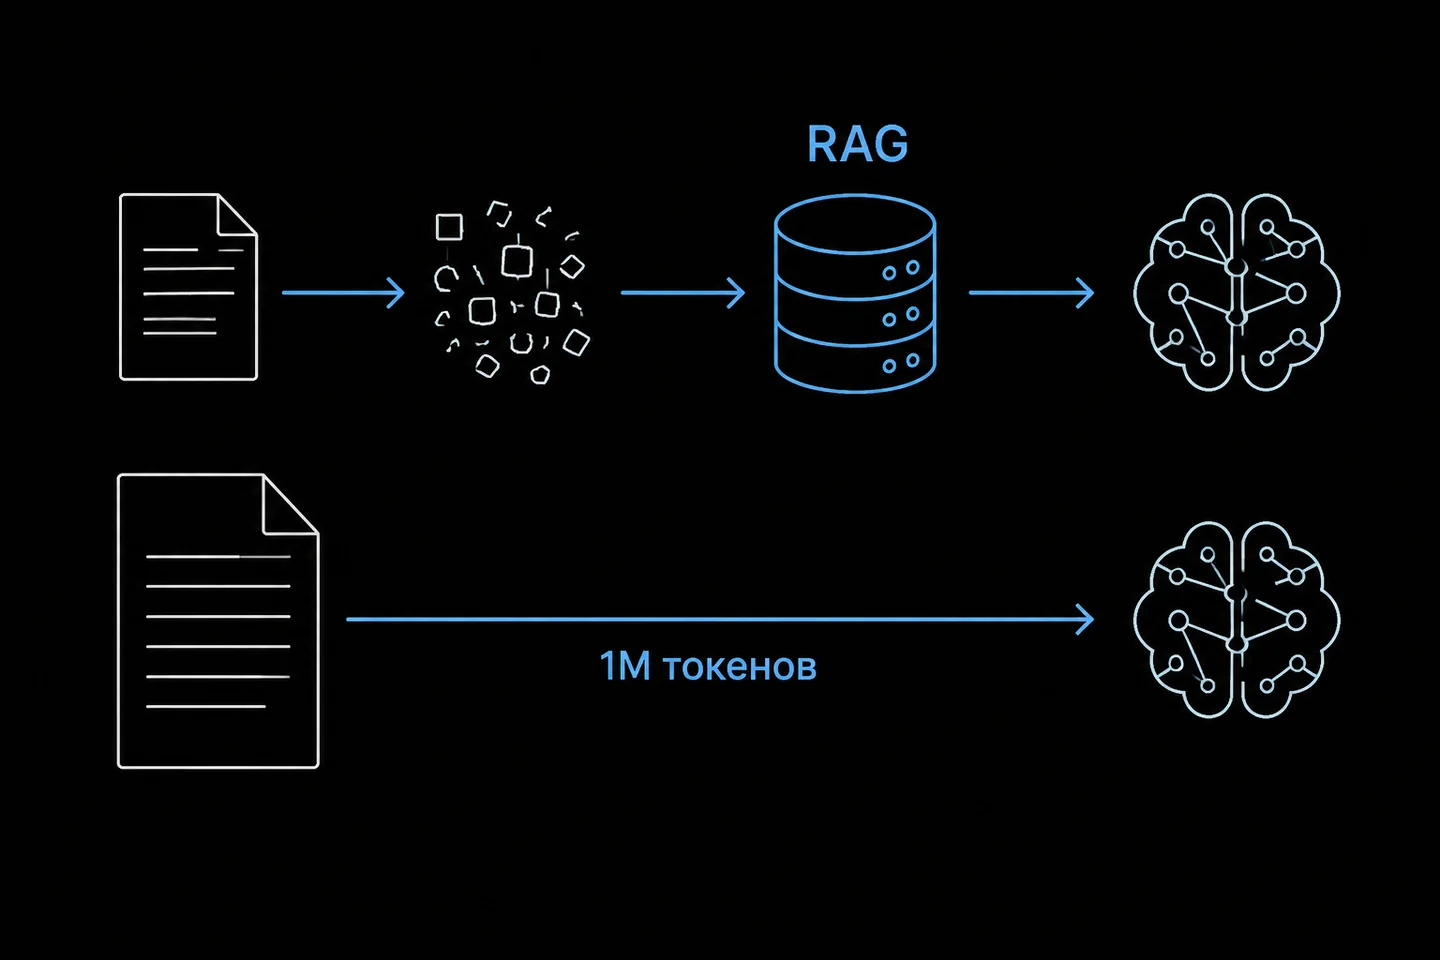
Большой контекст позволяет обойтись без RAG — поиска по нарезанным кускам документа, когда в запрос кладут только найденные фрагменты. Договор, техзадание или модуль кода целиком отправляют в один запрос, и модель видит перекрёстные ссылки, которые нарезка рвёт.
Ограничения у подхода такие:
- Один факт в длинном контексте модель находит уверенно, а несколько разрозненных уже хуже. Google пишет, что для ста фактов с высокой точностью может понадобиться около ста запросов.
- Вопрос ставьте в конец промпта, после документа. Так модель отвечает точнее.
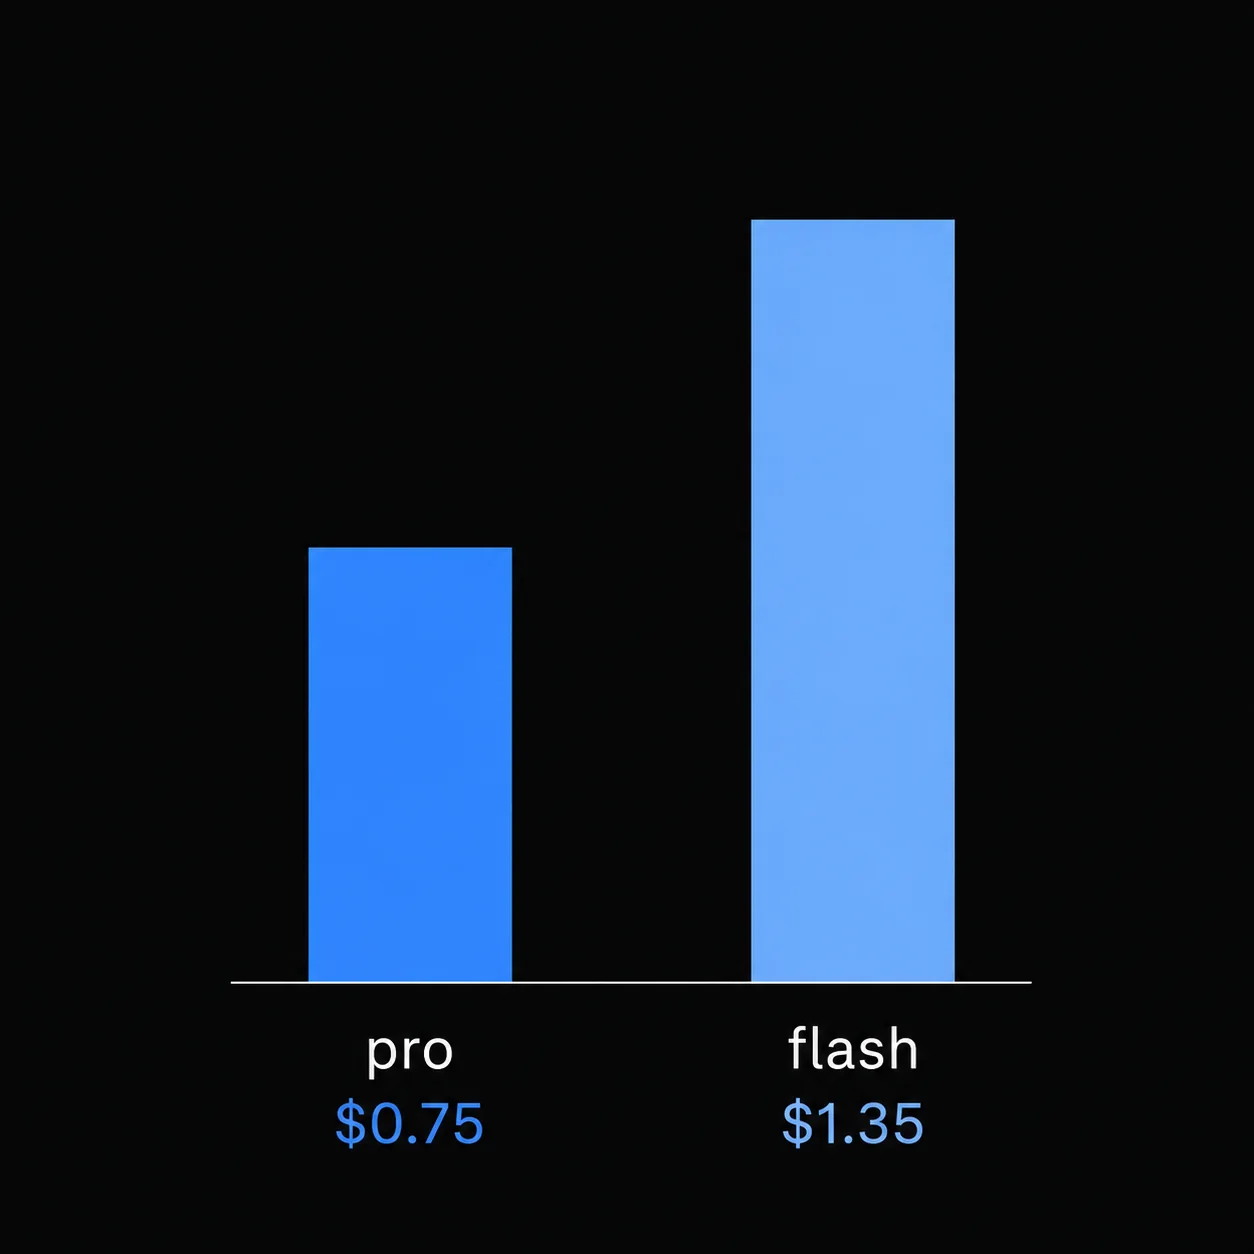
- Вход оплачивается в каждом запросе заново. Полный миллион токенов на 3.8 Flash стоит $0,75 по прайсу Google, а у 3.1 Pro промпт длиннее 200K токенов переводит запрос на ставку $4 за вход и $18 за выход вместо $2 и $12 (прайс).
Повторный вход Google частично удешевляет неявным кэшем. Если начало промпта длиной от 4 096 токенов совпадает с недавним запросом, эти токены у 3.8 Flash считаются по $0,075 вместо $0,75, но попадание в кэш не гарантировано. Если вы вызываете Gemini через шлюз, сколько списано за длинный запрос, показывает usage.cost, а не прайс.
RAG остаётся правильным выбором, когда корпус больше миллиона токенов или один и тот же набор документов опрашивают сотни раз в день. Моделей эмбеддингов в нашем каталоге нет: векторы придётся считать у другого поставщика, например через gemini-embedding-2 у Google.
Flash-Lite, Flash или Pro
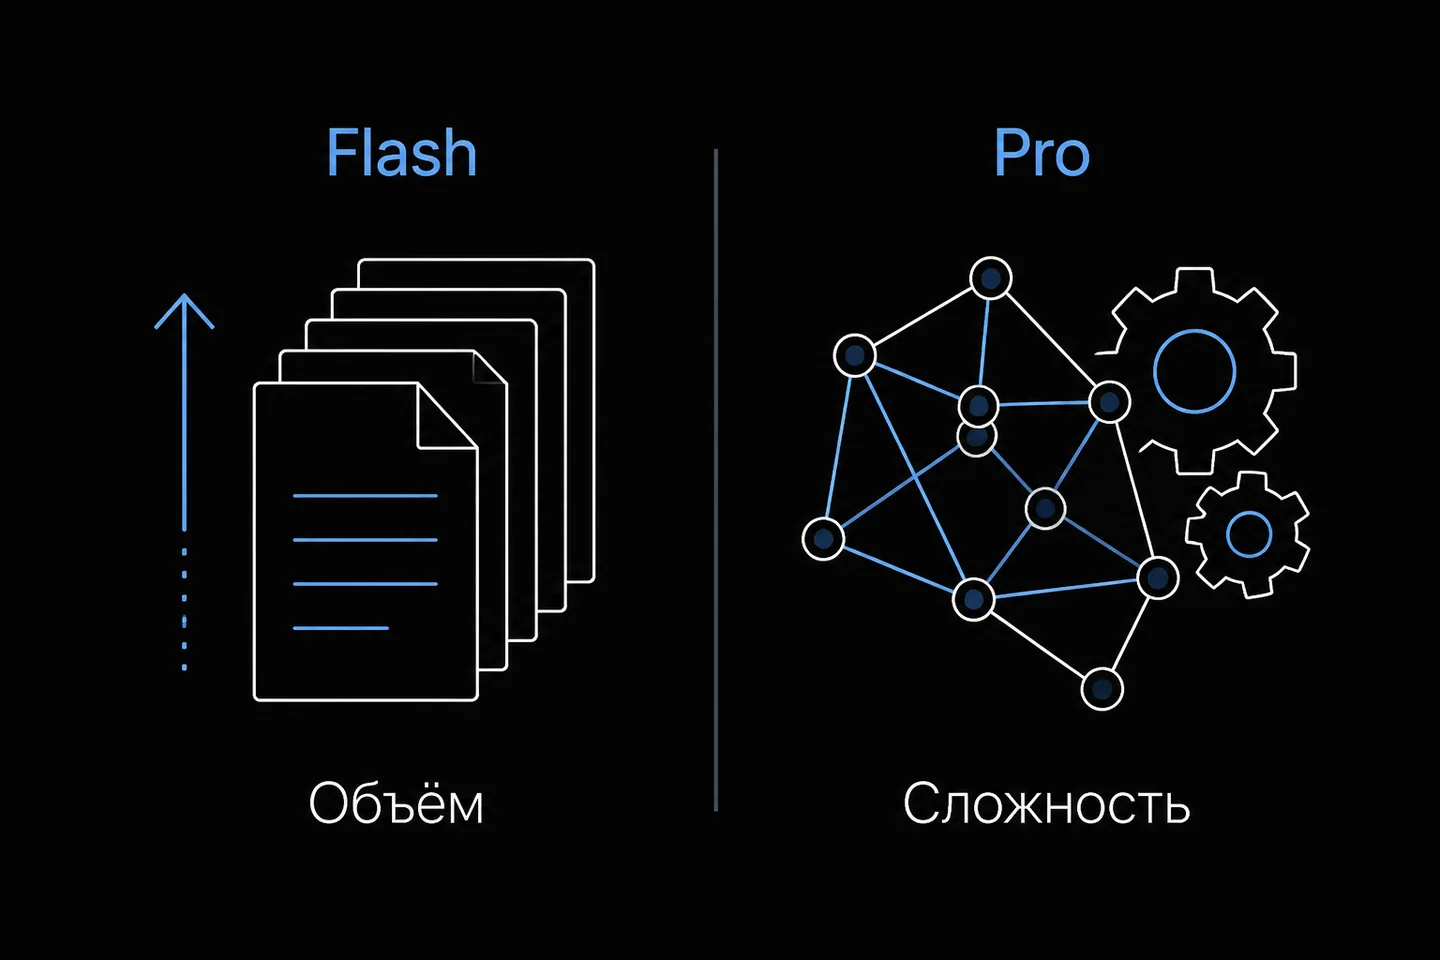
Gemini 3.1 Flash-Lite и 3.5 Flash-Lite подходят для классификации, извлечения полей и тегов, первичной фильтрации. 3.1 дешевле, у 3.5 по умолчанию минимальные рассуждения, и Google рекомендует её для массовой обработки. Разницу между ними на замерах разбирали в статье про Gemini 3.5 Flash Lite.
Gemini 3.8 Flash Google называет самой способной Flash для кода, агентов и длинных цепочек шагов. Для чата и простых задач попробуйте уровень рассуждений low: по умолчанию стоит medium.
Gemini 3.1 Pro у Google всё ещё в статусе preview, по умолчанию рассуждает на уровне high и дорожает на промптах длиннее 200K. Берите её, когда ошибка обходится дороже токенов.
Gemini 4 Argon — новый флагман для сложного кода, математики и автономных агентов. До 30.11.2026 Google берёт $2 за вход и $10 за выход, с 1 декабря цены удваиваются, бесплатного тира нет (прайс).
Порядок выбора не изменился. Возьмите 20–50 реальных запросов, начните с самой дешёвой модели и поднимайтесь на ступень только там, где видите конкретные ошибки.
FAQ
Нужен ли пакет google-genai, если код уже на библиотеке openai?
Для чата, стриминга, вызова функций и структурированного ответа не нужен: у Google есть OpenAI-совместимый слой, хоть и в статусе беты. Пакет google-genai понадобится для загрузки файлов и Live API, через совместимый слой их не вызвать.
Подробнее: OpenAI API: модели и цены.
Есть ли у Gemini API бесплатный тир?
Есть у моделей Flash, Flash-Lite и 2.5 Pro, у 4 Argon и 3.1 Pro его нет. На бесплатном тире Google использует запросы и ответы для улучшения своих продуктов, и их могут читать люди (условия). Лимиты и переход на платный тариф разобраны в статье про бесплатный API Gemini.
Почему счёт вырос, хотя ответы модели не стали длиннее?
Скорее всего, вы перешли на модель, у которой рассуждения нельзя выключить, или запрос ушёл на перенаправленный id. Сравните usage.total_tokens с суммой prompt_tokens и completion_tokens: разница и есть скрытые рассуждения. Понизьте reasoning_effort и проверьте id модели по списку Google.
Подробнее: Google API: модели и цены.