Gemini 3.5 Flash-Lite кажется очевидной заменой 3.1: номер больше, и Google советует её для новых проектов. Но прирост у неё в агентных задачах, а выход стоит на 67% дороже. В нашем замере обе модели извлекли поля из отзыва слово в слово одинаково, и 3.5 обошлась в полтора раза дороже. Поток простых задач оставляйте на 3.1, а 3.5 берите для субагентов, которые вызывают инструменты.
3.5 сильнее там, где модель действует, а не читает
Google выпустила 3.5 Flash-Lite 21 июля 2026 года вместе с 3.6 Flash (changelog Gemini API). Более новой текстовой Flash-Lite на 29.10.2026 нет: модель с индексом 3.8 в этой ветке одна, gemini-3.8-flash-lite-tts, и она синтезирует речь (список моделей).
| Модель | Google: вход / выход | altrouter: вход / выход | Отключение у Google |
|---|---|---|---|
| gemini-3.5-flash-lite | $0,30 / $2,50 | $0,27 / $2,25 | не объявлено |
| gemini-3.1-flash-lite | $0,25 / $1,50 | $0,225 / $1,35 | не раньше 07.05.2027 |
| gemini-2.5-flash-lite | $0,10 / $0,40 | нет в каталоге | не объявлено |
Цены за 1M токенов. Google — по прайсу на 29.10.2026, altrouter — по каталогу на 27.10.2026, на 10% ниже официальной цены вендора. Даты отключения — со страницы устаревших моделей: Google называет их самыми ранними и обещает предупредить заранее.
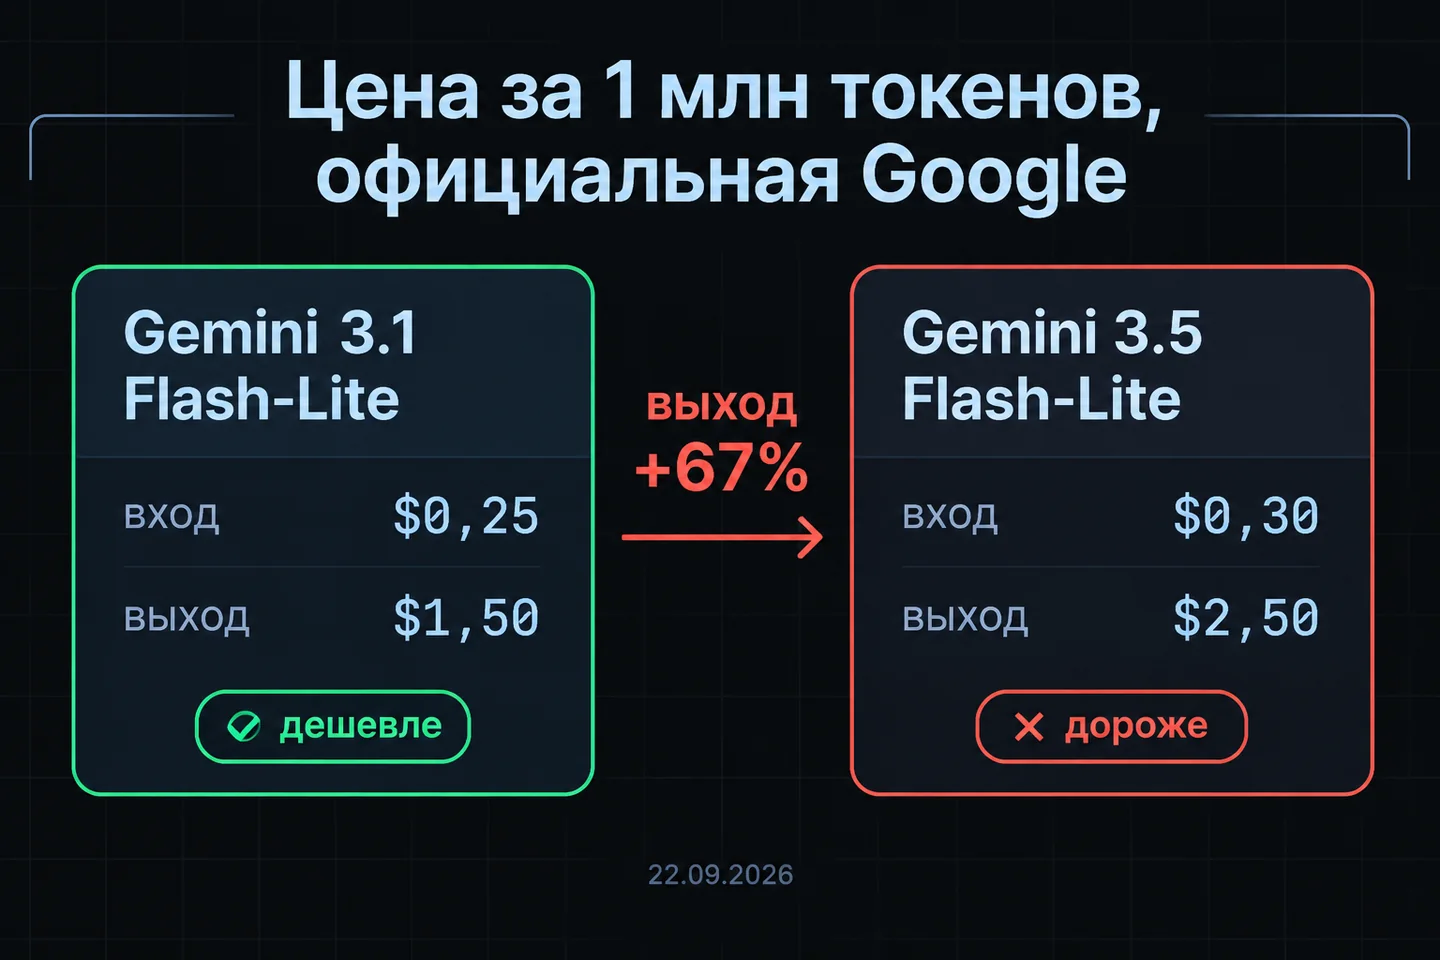
За что доплачивать, видно по бенчмаркам на странице Flash-Lite у Google DeepMind:
| Бенчмарк | Что проверяет | 3.5 Flash-Lite | 3.1 Flash-Lite |
|---|---|---|---|
| SWE-Bench Pro | правки кода в реальных репозиториях | 54,2% | 38,3% |
| Terminal-bench 2.1 | работа в терминале | 54,0% | 31,0% |
| OSWorld-Verified | управление компьютером через интерфейс | 74,0% | 54,3% |
| MRCR v2, 128K | поиск нужного места в длинном контексте | 72,2% | 60,1% |
| CharXiv Reasoning, без инструментов | вопросы по графикам из научных статей | 74,5% | 73,2% |
Где модель пишет код, запускает команды или кликает по интерфейсу, 3.5 выигрывает 16–23 пункта. Поиск в длинном контексте вырос на 12 пунктов, а на вопросах по графикам разница 1,3 пункта. В changelog Google так и описывает 3.5: вариант субагента для массовой автоматизации. Задача «прочитай короткий отзыв и заполни три поля» не требует ни действий, ни длинного контекста, и в нашем замере прироста на ней не было.
Контекст 3.5 Flash-Lite — 1 048 576 токенов на вход, выход до 65 536 токенов (карточка модели).
Замер: тот же JSON за полторы цены
22.09.2026 мы отправили через наш API одну и ту же задачу обеим моделям: извлечь из отзыва покупателя тональность, товар и суть проблемы. Отзыв был про наушники, у которых не заряжается левый вкладыш, а поддержка третий день молчит.
| gemini-3.5-flash-lite | gemini-3.1-flash-lite | |
|---|---|---|
| Ответ | JSON с тремя полями | тот же JSON слово в слово |
| Время ответа | 8,9 с | 7,0 с |
| Токены: вход / выход | 142 / 47 | 142 / 47 |
| Запрос по нашим ценам | ≈ $0,000144 | ≈ $0,000095 |
| 10 000 отзывов | ≈ $1,44 | ≈ $0,95 |
Ход расчёта для 3.5: 142 × $0,27 / 1M + 47 × $2,25 / 1M = $0,000038 + $0,000106 = $0,000144. Выход в 47 токенов обошёлся почти втрое дороже входа в 142 токена. На задачах извлечения счёт определяет цена выхода, поэтому разница в 67% по выходу дала разницу в 51% по запросу.
По прайсу Google те же 10 000 отзывов стоят $1,60 на 3.5 и $1,06 на 3.1. На 2.5 Flash-Lite вышло бы $0,33, но её на этой задаче мы не проверяли.
Замер узкий: одна задача и один вызов на модель, время зависит от нагрузки. Он показывает, что на простом извлечении 3.5 не дала прироста. Вывода «3.5 нигде не лучше» из него не сделать. Google приводит для 3.5 скорость 350 выходных токенов в секунду по Artificial Analysis. С такой скоростью 47 токенов генерируются за 0,13 секунды, а у нас ответ шёл 8,9 секунды, то есть почти всё время ушло не на генерацию. Если модель нужна для чата в реальном времени, замерьте задержку на своих запросах.
json_object не гарантирует чистую строку
В запросе стоял response_format: {"type": "json_object"}. Обе модели вернули правильный объект, но завернули его в markdown-блок:
```json
{
  "sentiment": "negative",
  "product": "наушники",
  "problem": "левый наушник не заряжается, поддержка не отвечает третий день"
}
```
Строка начинается с трёх обратных кавычек, и json.loads падает на первом символе. В пайплайне на тысячи отзывов это значит, что упадёт первый же запрос.
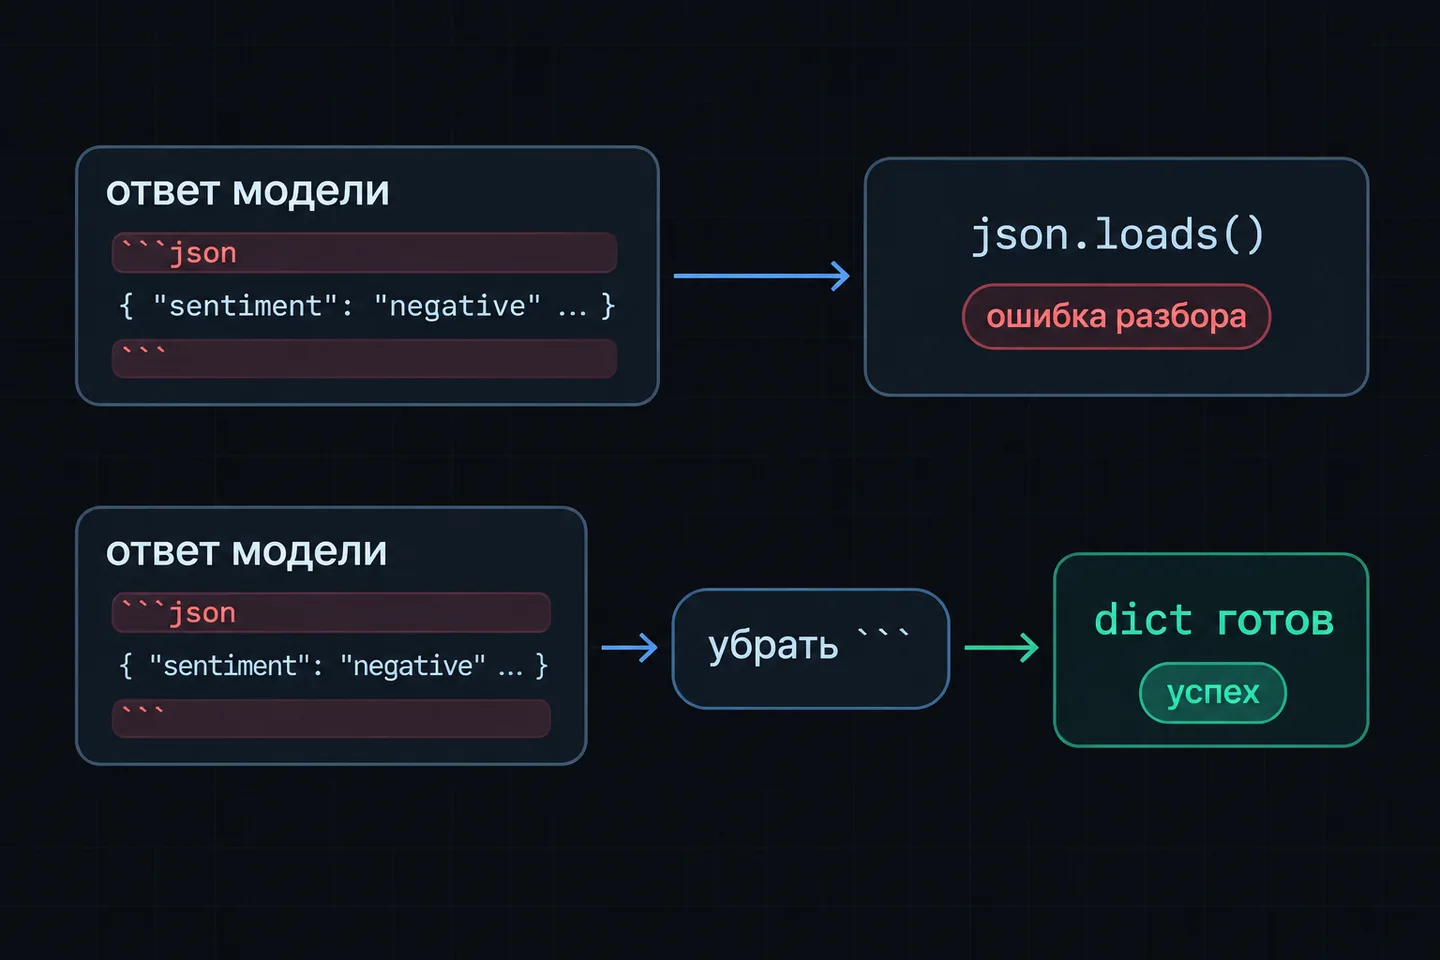
Режим json_schema со схемой мы на Flash-Lite не замеряли. Даже в своём нативном режиме Google обещает только синтаксически верный JSON, а значения советует проверять в приложении. Кроме того, Google поддерживает подмножество JSON Schema: minLength, maxLength и ещё несколько ключей API молча выбрасывает (structured output). Поэтому код ниже снимает обёртку и проверяет поля при любом режиме. Как устроены JSON-режим, схема и повторы, разобрано в статье «Модель вернула не JSON».
87 токенов за слово «hi»: короткие тексты шлите пачкой
Второй замер того же дня: запрос из одного слова hi. В usage пришло 87 входных и 9 выходных токенов. Около 80 из них — служебная часть запроса на нашем маршруте к Gemini, а не ваш текст. Это наш минус.
Добавка стоит примерно 80 × $0,27 / 1M ≈ $0,00002 за запрос. На отзыве в сотню слов её не видно. На миллионе коротких фраз, отправленных по одной, она сложится примерно в $22. С тех пор этот замер мы не повторяли, поэтому ориентируйтесь на usage.prompt_tokens своих запросов.
Короткие тексты выгоднее отправлять пачкой: 20–50 пронумерованных фраз в одном запросе и массив объектов в ответе. Служебная часть тогда оплачивается один раз на пачку. Пачка экономит и лимит запросов: у нас это 600 запросов в минуту на ключ (лимиты), так что 10 000 фраз по одной займут минимум 17 минут, а пачками по 25 — 400 запросов. Обратная сторона: из-за одного битого элемента переспрашивать придётся всю пачку, поэтому не раздувайте её. Другие приёмы экономии собраны в разборе расходов на токены.
Рассуждения: по умолчанию минимальные, и через шлюз их не поднять
У 3.5 Flash-Lite рассуждения включены всегда. По умолчанию уровень minimal, ещё есть low, medium и high (Google, thinking). Токены рассуждений Google считает по цене выхода, а для извлечения фактов и классификации сама советует minimal или low.
В наших запросах 22.09.2026 скрытых токенов не было: total_tokens совпал с суммой входа и выхода. В каталоге altrouter у этой модели нет параметра reasoning_effort (страница модели), так что задать ей уровень рассуждений через нас нельзя.
Если задаче нужен разбор с рассуждениями, берите Gemini 3.8 Flash с reasoning_effort. Готовьтесь к другому счёту: в замере из статьи про оплату Gemini из России 3.8 Flash при видимом ответе в 65 токенов добавила 1 101 скрытый токен. У моделей, которые рассуждают всегда и помногу, ломается и max_tokens: так вела себя Kimi K3.
Первый запрос: сравнить две версии на своих данных
Перед тем как пускать поток, проверьте пять настроек.
- Точный id:
gemini-3.5-flash-liteилиgemini-3.1-flash-lite. response_formatплюс снятие обёртки и проверка полей.max_tokensпод задачу (на три поля хватает 300) и проверкаfinish_reason.usageиcostиз каждого ответа в своих логах.- Прогон 20–30 реальных примеров через обе версии до запуска.
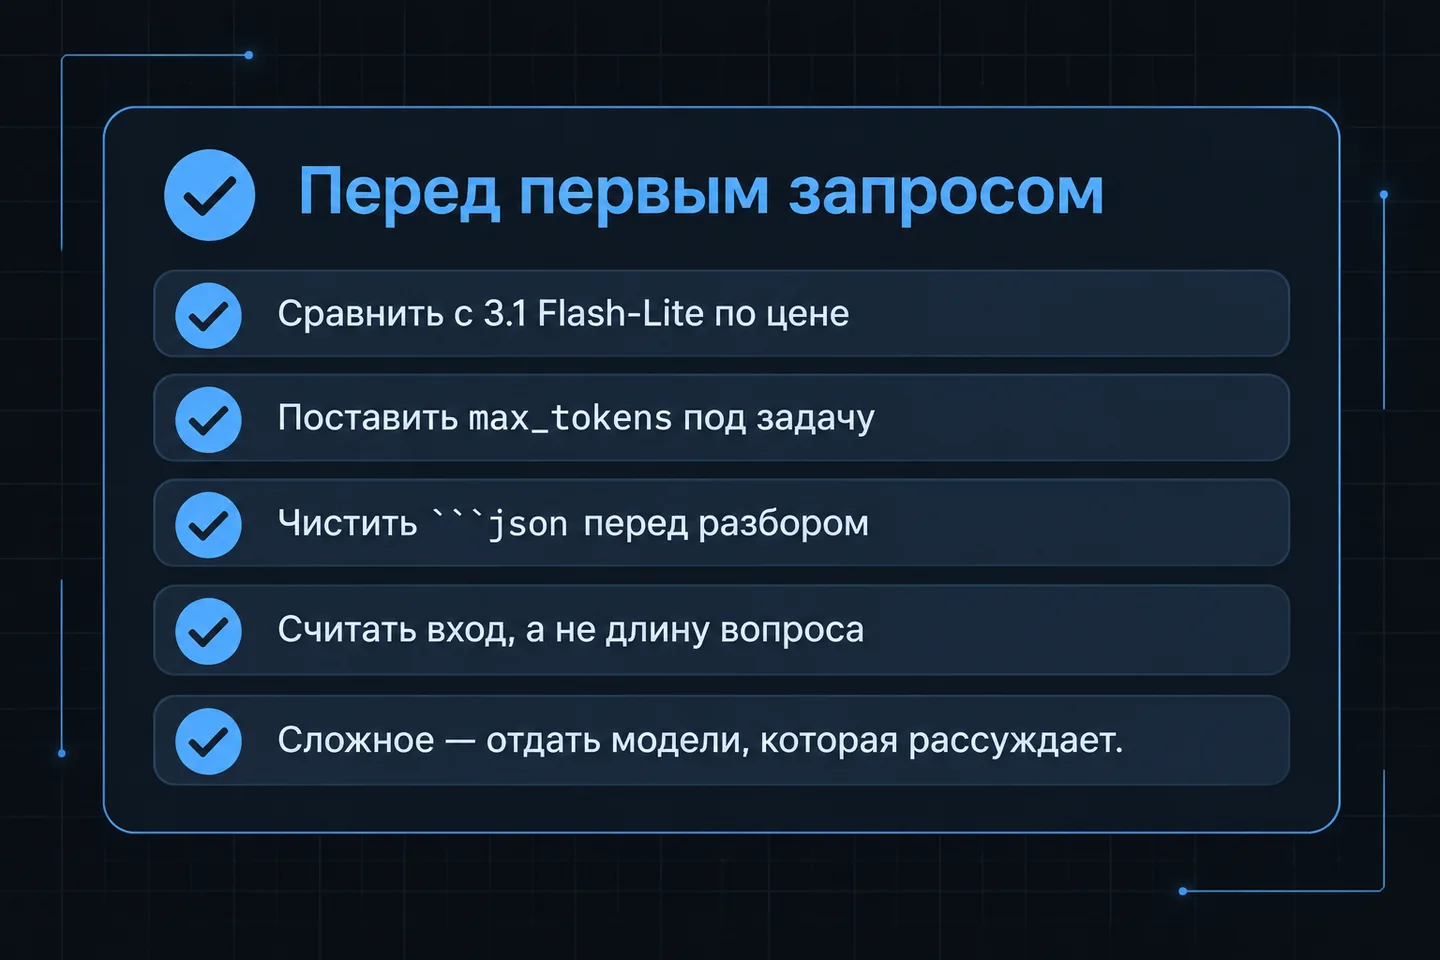
Скрипт ниже прогоняет файл reviews.txt (один отзыв на строку) через обе модели, сверяет тональность и товар и суммирует списания.
import json
import os
import re

from openai import OpenAI

client = OpenAI(
    api_key=os.environ["ALTROUTER_API_KEY"],
    base_url="https://api.altrouter.ai/v1",
)

PROMPT = (
    "Извлеки из отзыва JSON с полями sentiment (positive, negative или neutral), "
    "product и problem. Верни только JSON."
)
FENCE = re.compile(r"^```(?:json)?\s*|\s*```$")
MODELS = ["gemini-3.5-flash-lite", "gemini-3.1-flash-lite"]


def extract(model: str, review: str) -> tuple[dict, float]:
    resp = client.chat.completions.create(
        model=model,
        messages=[
            {"role": "system", "content": PROMPT},
            {"role": "user", "content": review},
        ],
        response_format={"type": "json_object"},
        max_tokens=300,
    )
    choice = resp.choices[0]
    if choice.finish_reason == "length":
        raise ValueError(f"{model}: ответ обрезан по max_tokens")
    data = json.loads(FENCE.sub("", choice.message.content.strip()))
    if not {"sentiment", "product", "problem"} <= data.keys():
        raise ValueError(f"{model}: не хватает полей: {data}")
    return data, getattr(resp.usage, "cost", None) or 0.0


with open("reviews.txt", encoding="utf-8") as f:
    reviews = [line.strip() for line in f if line.strip()]

same = 0
spent = dict.fromkeys(MODELS, 0.0)
for review in reviews:
    a, cost_a = extract(MODELS[0], review)
    b, cost_b = extract(MODELS[1], review)
    spent[MODELS[0]] += cost_a
    spent[MODELS[1]] += cost_b
    same += a["sentiment"] == b["sentiment"] and a["product"] == b["product"]

print(f"совпало {same} из {len(reviews)}, списано, $: {spent}")
Поле problem скрипт не сверяет: свободный текст редко совпадает буквально, его удобнее просмотреть глазами. cost — сумма, списанная за запрос, в долларах (логи и стоимость). Если тональность и товар совпали почти везде, а суммы различаются в полтора раза, ставьте в поток 3.1.
Чего нет через шлюз по сравнению с API Google
- Нет Batch и Flex. У Google эти режимы вдвое дешевле стандартной цены: $0,15 / $1,25 у 3.5 Flash-Lite, а наша скидка — 10% от стандартной. Для фоновой обработки, которая терпит задержку, прямой API Google дешевле, если вы можете с ним работать: России и Беларуси нет в списке стран Gemini API.
- Нет бесплатного уровня. У Google он для 3.5 Flash-Lite есть, но присланные на нём данные Google использует для улучшения своих продуктов (прайс). У нас оплата только по токенам.
- Выход короче. В нашем каталоге
max_tokensу 3.5 Flash-Lite ограничен 32 000 токенов, у Google — 65 536. - Формат только OpenAI-совместимый: Chat Completions без
generateContentи пакетаgoogle-genai. Сама Google называет поддержку библиотек OpenAI бета-версией (OpenAI compatibility).
Через altrouter баланс пополняется картой РФ, СБП или криптой. В коде меняются только ключ и base_url. Если у Google сбой, запросы к Gemini не пройдут и у нас.
FAQ
Принимает ли 3.5 Flash-Lite картинки и PDF?
У Google модель принимает текст, картинки, видео, аудио и PDF, а отвечает только текстом (карточка модели). В нашем каталоге у неё отмечены инструменты и картинки на входе. Скриншоты и фото чеков передавайте как image_url в сообщении.
Когда Google отключит Gemini 3.1 Flash-Lite?
Не раньше 7 мая 2027 года, замена — 3.5 Flash-Lite. Если ставите 3.1 в поток, вынесите id модели в конфиг и прогоните свои тесты на 3.5 до весны 2027 года.
Подробнее: Google API: модели и цены.
Чем Flash-Lite отличается от Flash?
Flash-Lite рассчитана на поток простых задач, где важны цена и задержка. Gemini 3.8 Flash рассуждает с настраиваемой глубиной и нужна там, где ответ надо вывести, а не найти в тексте. По прайсу Google до 31 декабря 2026 года 3.8 Flash стоит $0,75 / $3,75 за 1M токенов: в 2,5 раза дороже 3.5 Flash-Lite по входу и в 1,5 раза по выходу. С 1 января 2027 года Google поднимает цену 3.8 Flash до $1,50 / $7,50.
Подробнее: Gemini 3.8 Flash: цены и параметры.