Скрипт рефакторинга старой базы кода уходит в работу, делает десяток шагов и на середине пути теряет начальную инструкцию. Вы смотрите в консоль и видите, что правила из первого сообщения больше не соблюдаются. Для таких многошаговых задач Anthropic выпустила Claude Fable 5.1: модель сначала пишет себе скрытый черновик и только потом отвечает. Разберём, что она умеет, сколько стоит один вызов и как подключить её по API.
Fable 5.1 пишет черновик перед ответом, но вендор просит не торопиться
Anthropic выпустила Fable 5.1 1 сентября 2026 года. По словам вендора, модель сделана для сложных рассуждений и долгой агентной работы, где скрипт сам планирует шаги и анализирует большие объемы данных.
При этом официальная рекомендация гласит: не переходите на новинку по умолчанию. Для большинства повседневных задач вендор советует использовать Claude Opus 5. Переключаться на Fable 5.1 имеет смысл тогда, когда ваши проверки на Opus 5 даже с высоким уровнем усилий не дотягивают до нужного результата.
Модель принимает на вход текст и картинки, а возвращает только текст. Контекст — всё, что модель видит за один запрос: ваш вопрос, системная инструкция и история переписки. Он жестко ограничен, и то, что не влезло, для модели не существует. Окно контекста в новой версии вмещает один миллион токенов. Токен — кусочек текста, обычно часть слова. Модель считает вход и выход в токенах, и счёт вам приходит за них же. Миллион токенов позволяет загрузить в один вызов целую библиотеку документации или огромный репозиторий кода.
Официальные замеры показывают прирост на бенчмарках разработчика
Вместе с релизом появились результаты внутренних тестов Anthropic. Это официальные цифры вендора, а не наши независимые замеры. Мы приводим их без изменений, чтобы показать, в каких именно областях ожидается скачок качества при переходе со старой версии.
| Название бенчмарка | Предыдущая версия (Fable 5) | Новая версия (Fable 5.1) |
|---|---|---|
| Terminal-Bench 4.0 | 42,0% | 55,8% |
| Terminal-Bench-Science 0.1 | 24,7% | 52,6% |
| CursorBench 3.2.0 | 70,5% | 73,4% |
| Humanity's Last Exam (без инструментов) | 57,8% | 60,9% |
| OSWorld 2.0 (partial) | 72,9% | 77,9% |
Особое внимание уделили безопасности генерации. В сгенерированный текст теперь встраивается невидимая водяная метка, которая позволяет точно идентифицировать происхождение контента. По данным анонса, в фирменном инструменте Claude Code количество ложных срабатываний систем кибербезопасности упало примерно на шестьдесят процентов. Меньше ложных тревог — меньше ручного разбора после автоматической проверки кода.
Встроенное размышление и почему первый токен заставляет ждать
Модель не начинает сразу генерировать финальный ответ. Сначала она формирует токены рассуждений — скрытый черновик. Только после него модель выдает готовый результат. В итоговом ответе вы этот черновик не увидите, но в счёте за генерацию он будет.
Глубина размышления у вендора управляется параметром effort, по умолчанию он стоит на высоком уровне. Здесь наш минус: через наш API этот параметр пока не передать. В передаваемых аргументах вы можете контролировать только max_tokens — жесткий потолок общей длины ответа. Кончится лимит — модель замолчит на полуслове. Вы всегда будете получать более проработанный, но более объемный ответ, потому что отключить размышление полностью нельзя.
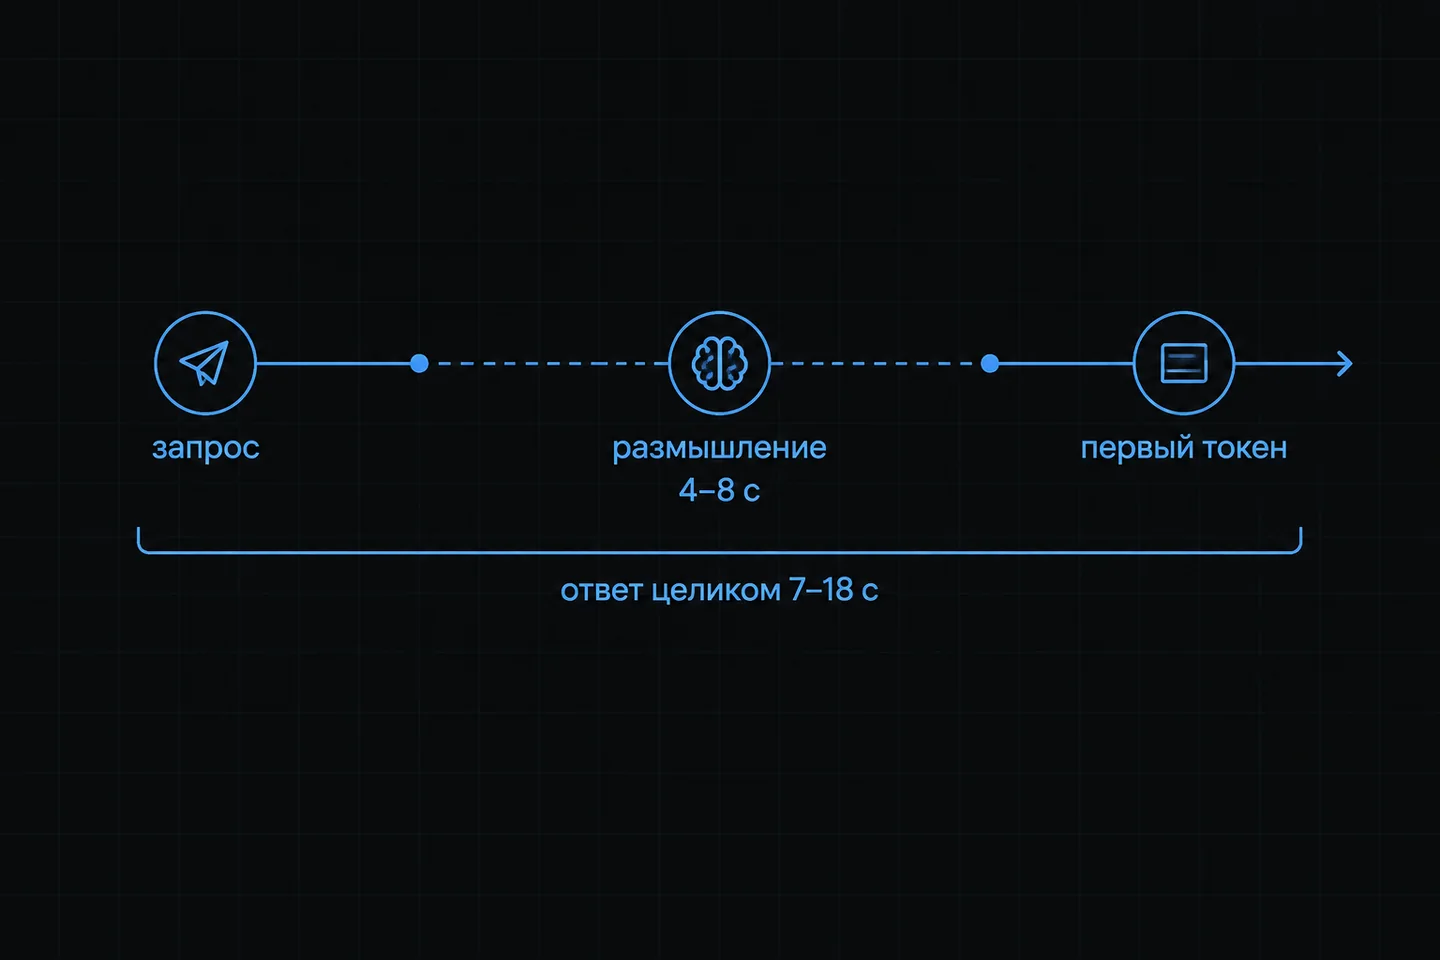
Из-за скрытой работы возникает задержка. Стриминг — режим, при котором ответ приходит кусками по мере генерации, как будто его печатают — работает здесь с нюансом. Первого слова придется ждать дольше обычного. Невидимый черновик пишется до начала трансляции видимого текста. Сам вендор помечает эту архитектуру как более медленную относительно основной линейки.
Сколько стоит вызов по официальному прайсу и через наш API
Официальная цена Anthropic составляет десять долларов за миллион входных токенов и пятьдесят долларов за миллион выходных. Вендор заявляет экономию до 45 процентов на агентной нагрузке и около 25 процентов на типичной за счет дешевого чтения кэша. Мы отдаем доступ к модели через единый интерфейс со скидкой от базового тарифа.
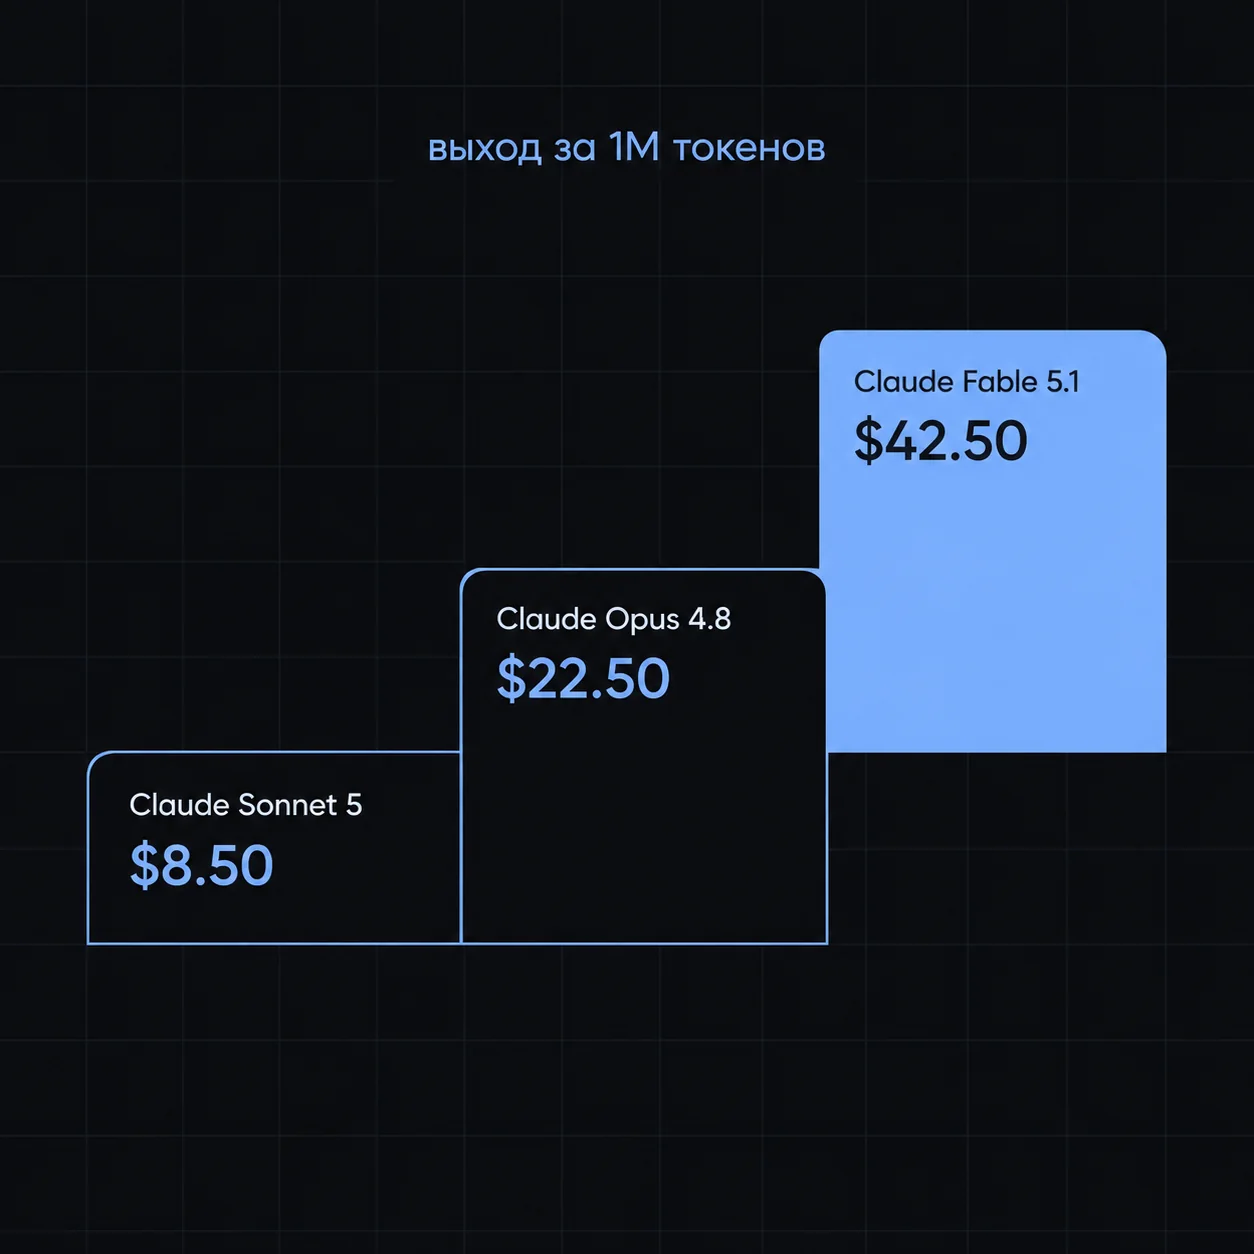
На 16.09.2026 цена через нас — 8.50 доллара за миллион на вход и 42.50 доллара за миллион на выход. Это скидка 15 процентов, посчитанная от официальной цены вендора. Предыдущая версия Fable 5 стоит ровно столько же. Переход на новую архитектуру не потребует увеличения бюджетов на генерацию.
| Параметр тарификации | Официальная цена Anthropic | Цена на altrouter.ai (на 16.09.2026) |
|---|---|---|
| Входные токены (за 1 млн) | $10.00 | $8.50 |
| Выходные токены (за 1 млн) | $50.00 | $42.50 |
| Размышление | Считается по тарифу выхода | Считается по тарифу выхода |
Токены размышления тарифицируются как выходные. Итоговый ответ может состоять из двух предложений, но скрытый черновик перед ним займет сотни токенов. За них спишется плата по ставке 42.50 доллара за миллион.
Считаем реальную математику на примере задачи
16.09.2026 мы прогнали модель через наш API на коротких задачах. Проверили арифметику, объяснение концепций на двести пятьдесят слов, написание кода на TypeScript, строгий возврат данных в формате JSON и вызов внешних инструментов. Tool calling — механизм, при котором модель не выполняет действие сама, а просит ваш код запустить конкретную функцию с нужными аргументами и вернуть ей результат. В нашем прогоне ответы были корректны, включая ответ модели после того, как код вернул ей результат инструмента.
Во время тестов мы замерили реальные задержки. Первый токен в стриме появлялся через четыре-восемь секунд после отправки запроса. Короткий ответ целиком формировался за семь-восемнадцать секунд. Модель заметно берет паузу на размышление перед тем, как заговорить с пользователем.
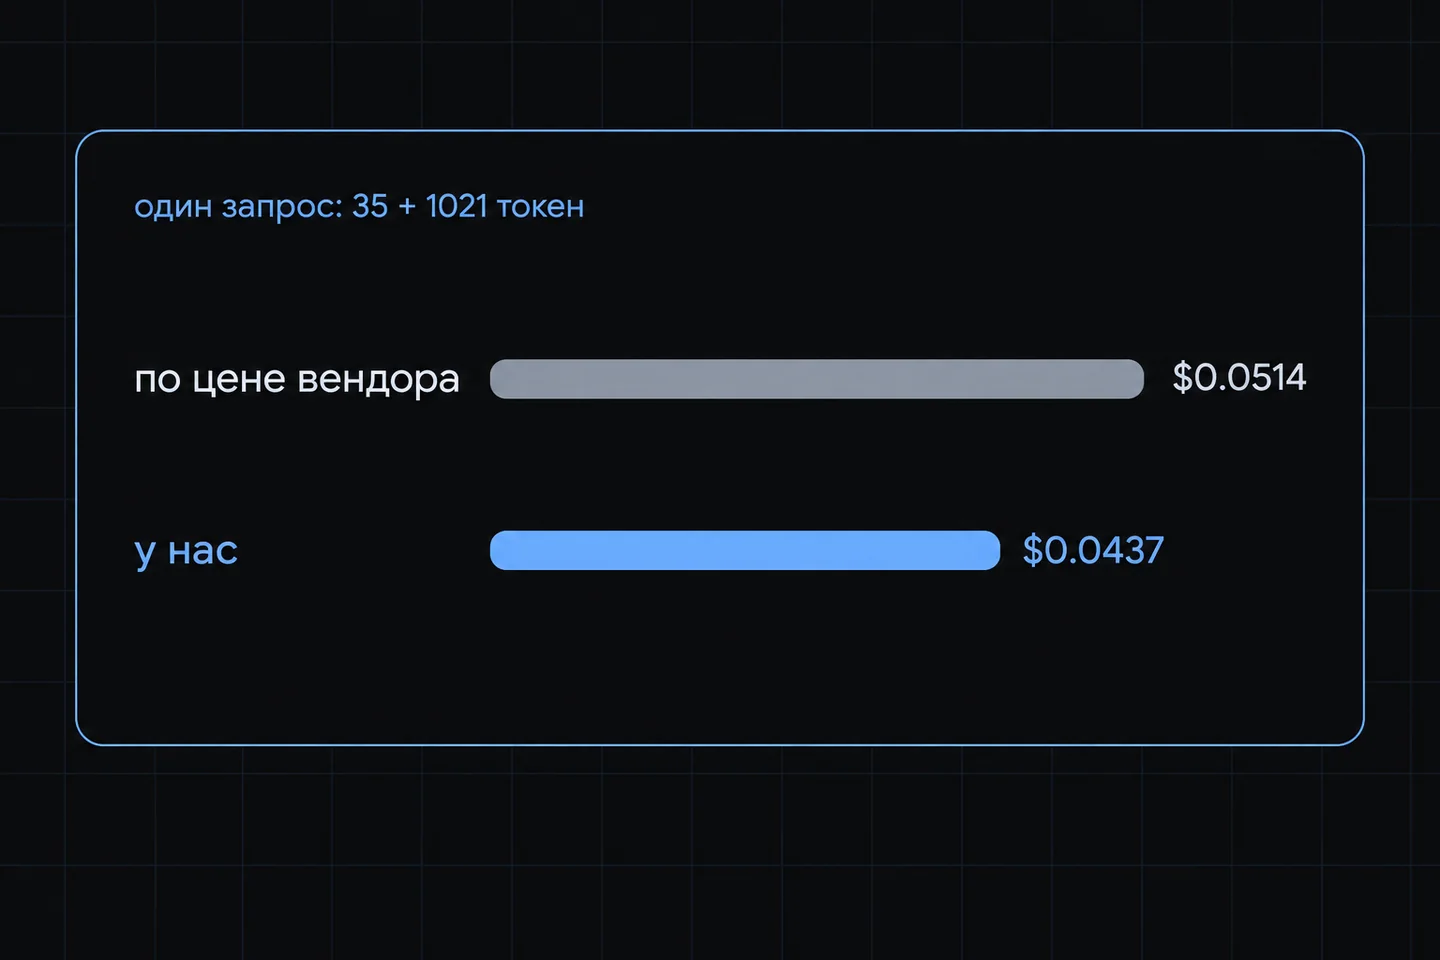
Для точной оценки стоимости мы взяли задачу по математике — доказательство иррациональности корня из двух. Текст доказательства занял около четырехсот слов. В ответе всегда присутствует usage — технический блок, где API сообщает, сколько токенов ушло на запрос и ответ. По данным этого блока, запрос потребил 35 входных и 1021 выходной токен.
Считаем наши расходы. Вход обошелся в 35 токенов: умножаем на 8.50 и делим на миллион, получаем 0.0003 доллара. Выход составил 1021 токен: умножаем на 42.50 и делим на миллион, получаем 0.0434 доллара. Итоговая стоимость одной генерации составила 0.0437 доллара. Если отправить тот же запрос напрямую по официальной цене, выйдет 0.0514 доллара. По полю usage мы не разделяли, сколько из тысячи выходных токенов ушло на скрытое размышление, а сколько на видимый текст. Тарифицируются они одинаково, и платите вы за весь сгенерированный объем.
Чего мы не измерили и где наш потолок
Дыры в методике мы называем сразу. Время ответа замерялось на короткой дистанции внутри одного дня. Нагрузку и время суток мы не выравнивали. В часы пик задержки до первого токена будут другими.
Мы гоняли короткие задачи. Длинные агентские сессии, под которые эта модель проектировалась, остались за бортом. Миллионный контекст на практике мы тоже не нагружали. Собрать осмысленный тестовый запрос такого объема под реальную задачу не вышло.
Есть жесткое ограничение на нашей стороне. Вендор отдает до 128 тысяч выходных токенов на запрос. У нас потолок параметра max_tokens срезан до 32 тысяч. Этого хватит для генерации скриптов, но написать книгу за один вызов не получится.
Скидки вендора на чтение кэша и пакетный API через наш API мы не проверяли и не обещаем.
У модели есть ломающие изменения при переходе с Fable 5. Принудительный вызов инструмента теперь возвращает ошибку. Если вы программно правите ранние реплики в истории диалога, блоки размышления инвалидируются. Их нельзя переиспользовать в следующем запросе.
Когда скрытые токены сжигают бюджет впустую
Флагманская архитектура нужна не везде. Если вы переводите текст, достаете поля из короткого документа или пишете базовый скрипт, встроенное размышление только вредит. Вы ждете дольше и платите за скрытые токены, которые модель тратит на внутренние рассуждения.
Для простых задач в каталоге есть быстрые альтернативы. На 16.09.2026 миллион входных токенов Sonnet 5 стоит 1.69 доллара, выходных — 8.50.
Opus 4.8 обойдется в 4.50 доллара на вход и 22.50 на выход. Оставьте тяжеловесные решения для тех моментов, когда код действительно заходит в тупик.
Как отправить первый запрос
Переписывать архитектуру не придется. Вы меняете ключи и адреса в стандартных библиотеках, остальной код работает по старому протоколу.
- Получите ключ в личном кабинете на altrouter.ai.
- Поменяйте
base_url— адрес, куда SDK шлет запрос. - Запишите
claude-fable-5.1в параметр модели. - Заложите в код обработку паузы. До появления первого символа ответа пройдет время.
Ниже собран прямой запрос через curl. Мы убрали системную инструкцию, оставив только вопрос пользователя без потоковой передачи.
curl https://api.altrouter.ai/v1/chat/completions \
  -H "Authorization: Bearer $ALTROUTER_API_KEY" \
  -H "Content-Type: application/json" \
  -d '{
    "model": "claude-fable-5.1",
    "max_tokens": 2000,
    "messages": [
      {"role": "user", "content": "Докажи, что корень из 2 иррационален."}
    ]
  }'
На Python работает стандартная библиотека. Скрипт ниже открывает потоковую передачу и печатает текст по мере появления. В конце он запрашивает статистику потребления и считает цену по нашему тарифу — 8.50 и 42.50 долларов за миллион токенов.
import os
from openai import OpenAI

client = OpenAI(
    api_key=os.environ["ALTROUTER_API_KEY"],
    base_url="https://api.altrouter.ai/v1",
)

stream = client.chat.completions.create(
    model="claude-fable-5.1",
    max_tokens=4000,
    stream=True,
    stream_options={"include_usage": True},
    messages=[
        {"role": "system", "content": "Отвечай по-русски, коротко."},
        {"role": "user", "content": "Найди ошибку в этой функции: ..."},
    ],
)

for chunk in stream:
    if chunk.choices and chunk.choices[0].delta.content:
        print(chunk.choices[0].delta.content, end="", flush=True)
    if chunk.usage:
        u = chunk.usage
        cost = u.prompt_tokens * 8.5 / 1e6 + u.completion_tokens * 42.5 / 1e6
        print(f"\n\nвход {u.prompt_tokens}, выход {u.completion_tokens}, ≈ ${cost:.4f}")
Для JavaScript мы написали пример на Node. Жесткий режим вывода здесь не используется. Код просит вернуть JSON обычным текстом в промпте, дожидается ответа и выводит статистику использования токенов.
import OpenAI from "openai";

const client = new OpenAI({
  apiKey: process.env.ALTROUTER_API_KEY,
  baseURL: "https://api.altrouter.ai/v1",
});

const res = await client.chat.completions.create({
  model: "claude-fable-5.1",
  max_tokens: 2000,
  messages: [{ role: "user", content: "Верни JSON: {\"city\": string, \"population\": number} для Казани" }],
});

console.log(res.choices[0].message.content);
console.log(res.usage); // prompt_tokens и completion_tokens — это и есть ваш счёт
Если вы считаете экономику проекта, посмотрите сколько стоит Claude API по моделям. Для старта интеграции пригодится разбор того, что из Claude работает в России. Если скрипты должны обращаться к вашим базам данных, прочитайте как устроен tool calling. Актуальные цены лежат на странице модели в каталоге.
FAQ
Сколько стоит Claude Fable 5.1 по API?
На 16.09.2026 официальная цена вендора — 10 долларов за миллион входных токенов и 50 долларов за миллион выходных. Через нас те же токены идут со скидкой 15 процентов от цены вендора: 8.50 на вход и 42.50 на выход. Скрытые токены размышления тарифицируются ровно по цене выходных.
Как подключить Claude Fable 5.1 из России?
Вы берете ключ на altrouter.ai и меняете в своем коде ровно две вещи: базовый адрес для отправки запросов и имя модели. Запрос уходит на наш адрес, дальше к вендору. Никаких дополнительных настроек окружения или сложных схем не требуется. Код продолжает говорить на привычном протоколе.
Можно ли отключить размышление у Fable 5.1?
Нет, адаптивное размышление встроено в архитектуру и работает всегда. Модель в любом случае формирует скрытый черновик перед тем, как выдать финальный результат. Вы не можете пропустить этот шаг ради экономии. Вы можете только жестко ограничить общую длину ответа параметром лимита токенов.
Какой лимит токенов на выход у Fable 5.1?
Сам вендор позволяет модели генерировать до 128 тысяч токенов в одном ответе. Однако через наш интерфейс установлен жесткий потолок в 32 тысячи токенов на один вызов. Это наш минус. Для подавляющего большинства практических задач программирования этого объема достаточно.
Поддерживает ли Fable 5.1 вызов функций?
Да, модель работает с вызовом внешних инструментов и возвратом структурированных данных. В нашем прогоне ответы корректны. Но есть важное изменение в поведении. Принудительное требование использовать конкретный инструмент теперь возвращает ошибку. Выбор инструмента оставляйте модели, иначе запрос упадет.