Просьба «верни JSON» в промпте ничего не гарантирует, а строгая схема в параметрах запроса гарантирует только форму ответа. Её поддерживают OpenAI, Anthropic и Google, но каждый свой поднабор JSON Schema, и у всех есть два исключения: отказ модели и обрыв по лимиту токенов. Надёжная связка такая: схема в запросе, валидатор в коде, проверка причины остановки и заранее решённый путь для брака.
Три режима и что каждый обещает
Просьба в промпте — самый слабый режим. Модель учили отвечать человеку, поэтому JSON приходит в markdown-блоке с пометкой json, после фразы «Вот результат:», с плейсхолдером "<СУММА>" вместо числа или с полем, которого вы не просили. Для разового скрипта этого хватает, для продакшена нет.
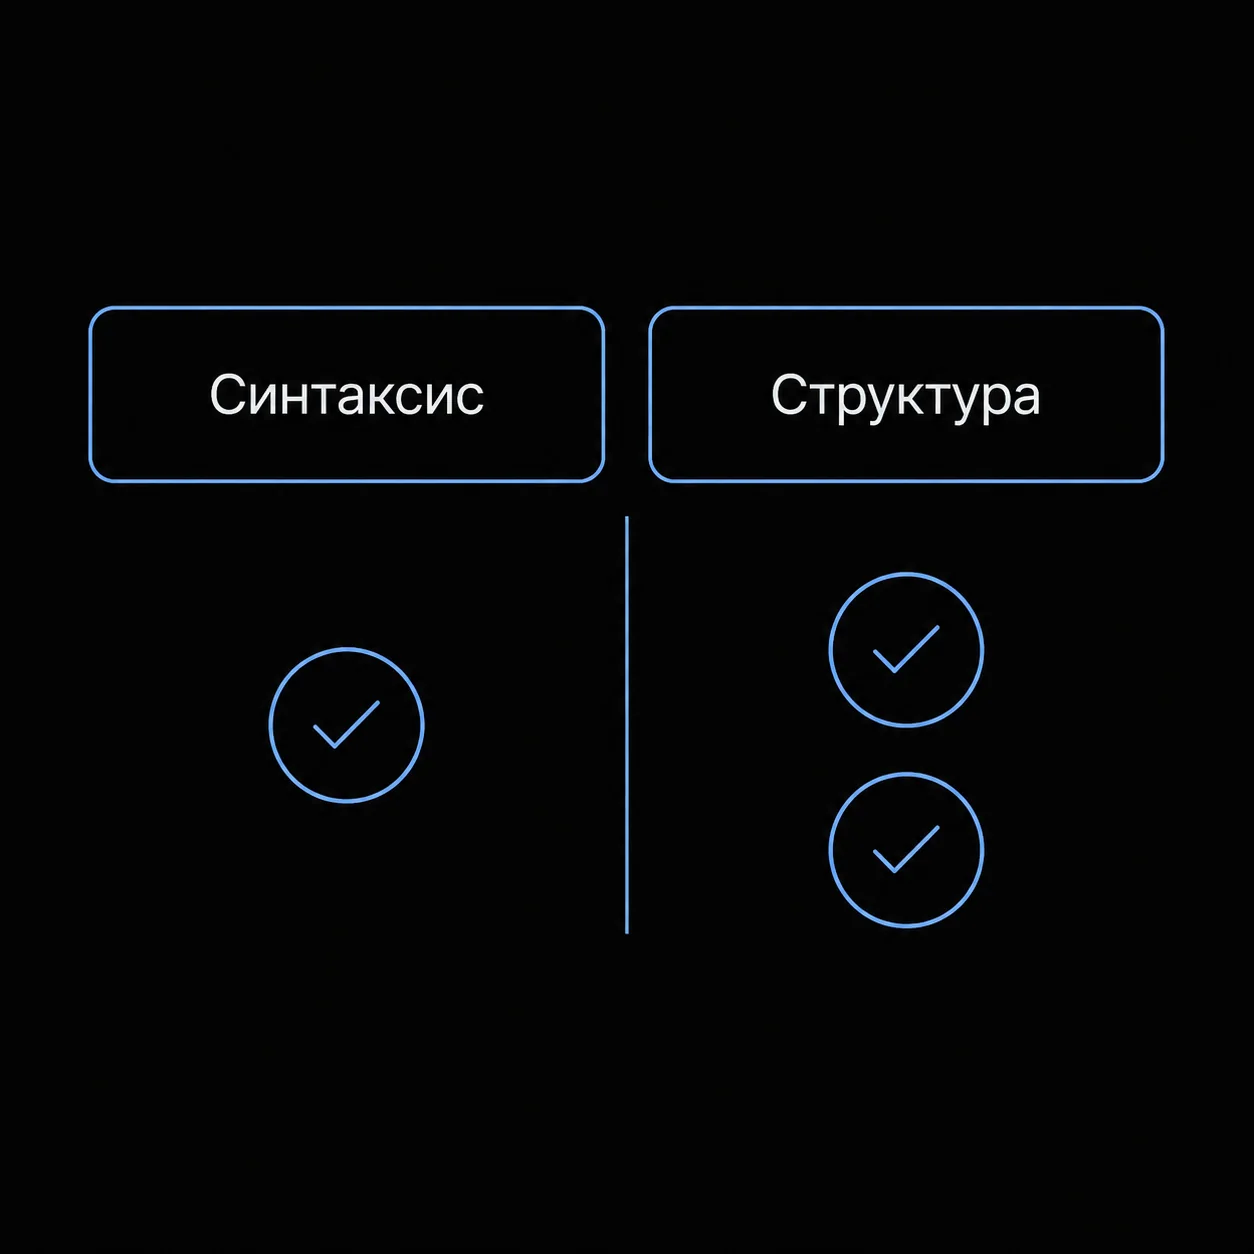
JSON mode включается параметром response_format: {"type": "json_object"} и гарантирует синтаксис: ответ разберётся json.loads. Про содержимое он ничего не обещает. Поле может называться sum вместо amount, а число может прийти строкой. У OpenAI в сообщениях обязательно должно быть слово «JSON», иначе API вернёт ошибку. Без явной инструкции модель может до лимита токенов слать пробелы (OpenAI).
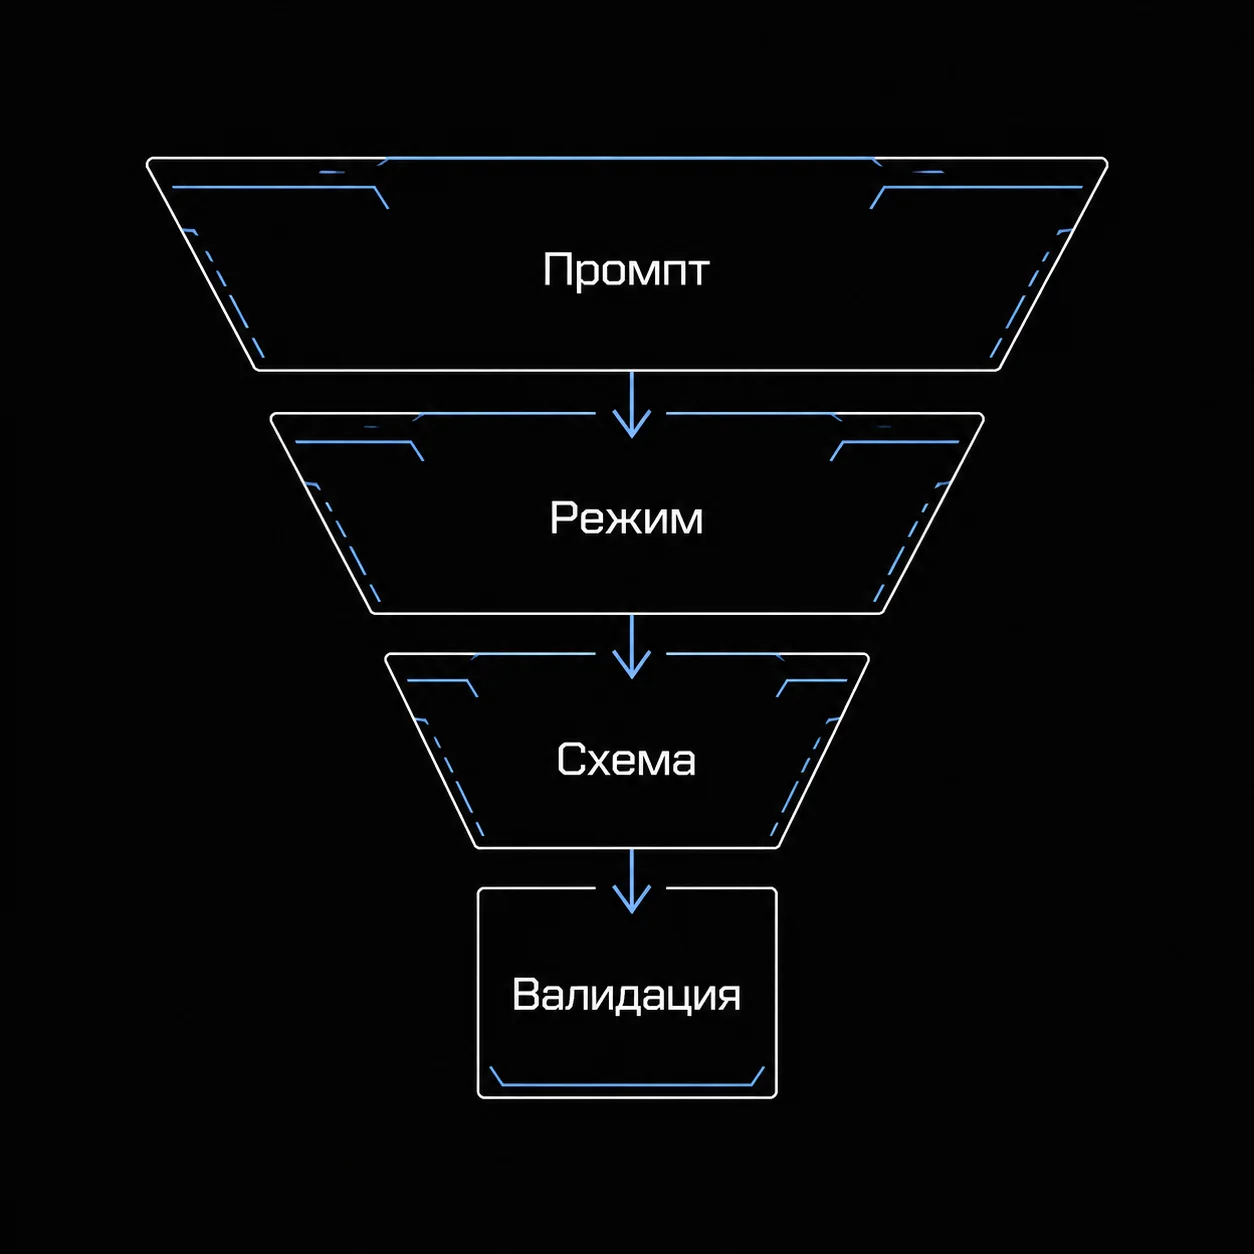
Строгая схема (structured output) — режим, в котором вы передаёте JSON Schema с strict: true, а сервис не выпускает ответ, который ей не соответствует. OpenAI формулирует разницу так: оба режима дают валидный JSON, но соответствие схеме гарантирует только structured output. Там же компания советует по возможности использовать его вместо JSON mode.
Строгая схема у трёх вендоров: одно название, разные правила
Схема, которая проходит у одного вендора, у другого может дать 400 или молча потерять ограничение. Сравнение по документации на 29.10.2026:
| OpenAI | Anthropic | Google Gemini | |
|---|---|---|---|
| Как включить | response_format с json_schema и strict: true; в Responses API — text.format | output_config.format или strict: true у инструмента | схема в response_format с типом application/json |
| Необязательные поля | все поля в required, необязательность через ["string", "null"] | не больше 24 необязательных параметров на запрос | обычный required |
minimum, maximum | поддерживаются | не поддерживаются, 400 | поддерживаются |
minLength, maxLength | в списке поддерживаемых нет | не поддерживаются, 400 | сервер молча вырезает |
| Неподдерживаемое слово | ошибка запроса: allOf, not, if/then/else | 400 с описанием | слишком сложная схема — 400 |
| Первый запрос с новой схемой | медленнее, дальше без задержки | компиляция грамматики, кэш на 24 часа | не описано |
Источники: OpenAI, Anthropic, Google.
Из таблицы следует практическое правило. Поле "minimum": 0 пройдёт у OpenAI и Gemini, а у Anthropic вернёт 400. "maxLength": 100 у Gemini исчезнет без предупреждения, и модель вернёт строку длиннее. Google прямо пишет в документации, что гарантирует синтаксически корректный JSON, а не правильность значений, и советует проверять их в приложении. Поэтому в схеме держите форму: типы, enum, required, additionalProperties: false. Границы чисел и длин проверяйте в своём коде.
Схема в запросе: GPT и Gemini
Через наш API response_format работает у моделей GPT и Gemini (документация). Возьмём разбор расходов из текста: категория, сумма, валюта и продавец, которого может не быть.
import json
import os

from openai import OpenAI

client = OpenAI(base_url="https://api.altrouter.ai/v1", api_key=os.environ["ALTROUTER_API_KEY"])

EXPENSE_SCHEMA = {
    "type": "object",
    "properties": {
        "category": {"type": "string", "enum": ["еда", "транспорт", "жильё", "прочее"]},
        "amount": {"type": "number"},
        "currency": {"type": "string", "enum": ["RUB", "USD", "EUR"]},
        "merchant": {"type": ["string", "null"]},
    },
    "required": ["category", "amount", "currency", "merchant"],
    "additionalProperties": False,
}


class BadAnswer(Exception):
    """Ответ нельзя разбирать: обрыв, отказ или текст вместо вызова."""


def ask_json(model: str, text: str) -> str:
    resp = client.chat.completions.create(
        model=model,
        reasoning_effort="low",
        max_completion_tokens=2000,
        messages=[
            {"role": "system", "content": "Извлеки расход из текста. Если продавец не назван, верни null."},
            {"role": "user", "content": text},
        ],
        response_format={
            "type": "json_schema",
            "json_schema": {"name": "expense", "strict": True, "schema": EXPENSE_SCHEMA},
        },
    )
    choice = resp.choices[0]
    if choice.finish_reason != "stop":  # length или content_filter: JSON может быть неполным
        raise BadAnswer(choice.finish_reason)
    if getattr(choice.message, "refusal", None):
        raise BadAnswer("refusal")
    return choice.message.content


print(json.loads(ask_json("gpt-6-luna", "Такси до аэропорта, 1450 рублей")))
Основной выигрыш даёт enum. Свободная строка в поле категории через полгода оборачивается разными написаниями одного и того же: «Транспорт», «транспортные расходы», «taxi». additionalProperties: false не даёт модели дописать поля от себя, а merchant с типом ["string", "null"] остаётся в required: так строгий режим OpenAI выражает необязательное поле.
max_completion_tokens — потолок длины ответа — задавайте явно и с запасом. gpt-6-luna и gemini-3.8-flash рассуждают перед ответом, и черновик тратит тот же лимит. Если потолок кончится раньше, придёт finish_reason: "length" и обрезанный JSON.
Claude: та же схема через инструмент
У самой Anthropic строгий JSON-ответ есть: параметр output_config.format вышел из беты, заголовок для него больше не нужен. Через наш OpenAI-совместимый API response_format у моделей Claude не поддерживается, и документация предлагает другой путь: инструмент с одной функцией, у которой параметры совпадают со схемой. Модель «вызывает» функцию, а аргументы вызова и есть ваш JSON. Подробно механику инструментов мы разбирали в статье про tool calling.
Здесь есть ловушка. Принудительный вызов инструмента у Anthropic называется tool_choice со значением any или tool, в OpenAI-формате ему соответствуют required и выбор функции по имени. По документации Anthropic Claude Opus 5.5, Sonnet 5.5 и Fable 5.1 отвечают на него ошибкой 400. Haiku 5.5 принудительный вызов принимает, но пропускает при этом рассуждения. Для старших моделей оставляйте auto, просите вызвать функцию в промпте и проверяйте, что вызов пришёл:
EXPENSE_TOOL = {
    "type": "function",
    "function": {
        "name": "save_expense",
        "description": "Сохраняет один расход, извлечённый из сообщения пользователя. Вызывай ровно один раз.",
        "parameters": EXPENSE_SCHEMA,
    },
}


def ask_json_claude(model: str, text: str) -> str:
    # Haiku 5.5 принимает принудительный вызов, Sonnet 5.5 и Opus 5.5 отвечают на него 400.
    forced = model == "claude-haiku-5.5"
    resp = client.chat.completions.create(
        model=model,
        max_tokens=1024,
        messages=[
            {"role": "system", "content": "Извлеки расход и вызови save_expense. Текстом не отвечай."},
            {"role": "user", "content": text},
        ],
        tools=[EXPENSE_TOOL],
        tool_choice={"type": "function", "function": {"name": "save_expense"}} if forced else "auto",
    )
    calls = resp.choices[0].message.tool_calls
    if not calls:
        raise BadAnswer("модель ответила текстом, а не вызовом")
    return calls[0].function.arguments
У инструментов своя цена. С каждым таким запросом Anthropic добавляет служебный системный промпт: у Haiku 5.5 это 286 токенов при auto и 406 при принудительном вызове, плюс токены самого описания функции (Anthropic). Сколько входных токенов насчитано в итоге, видно в usage.prompt_tokens.
Чего схема не проверяет
Строгий режим проверяет типы и имена полей, а смысл значений проверяете вы. Сумма 0 или -1450 проходит как число, дата из будущего проходит как строка. Валидатор в коде нужен при любом режиме: он ловит бессмысленные значения, ответы моделей без строгого режима и изменение формата после обновления модели, о котором вы иначе узнаете от пользователей.
from typing import Literal

from pydantic import BaseModel, ConfigDict, Field


class Expense(BaseModel):
    model_config = ConfigDict(extra="forbid")

    category: Literal["еда", "транспорт", "жильё", "прочее"]
    amount: float = Field(gt=0, lt=10_000_000)
    currency: Literal["RUB", "USD", "EUR"]
    merchant: str | None
Схема в запросе и модель Pydantic описывают одно и то же с разной строгостью, и это нормально. Первая держит форму на стороне вендора и обязана укладываться в его поднабор JSON Schema. Вторая хранит бизнес-правила, которые не каждый вендор принимает в схеме.
🔴 Отказ и обрыв ломают гарантию схемы. У OpenAI отказ приходит в поле refusal. У Anthropic ответ с stop_reason: "refusal" приходит со статусом 200, токены оплачиваются, а вывод может не совпасть со схемой. При обрыве по лимиту токенов (finish_reason: "length" или stop_reason: "max_tokens") JSON может оказаться неполным (Anthropic). Такой ответ не разбирайте и не сохраняйте: запись с половиной полей в базе обходится дороже повторного запроса.
Что делать с браком и сколько это стоит
Для ответа, который не прошёл проверку, рабочих путей два. Можно повторить запрос, добавив в сообщения текст ошибки валидатора. Можно отправить случай на модель посильнее. Второй путь проще встроить в конвейер:
import logging

from pydantic import ValidationError

log = logging.getLogger(__name__)


def extract(text: str) -> Expense | None:
    for model in ("gpt-6-luna", "gpt-6.1-sol"):
        try:
            return Expense.model_validate_json(ask_json(model, text))
        except (BadAnswer, ValidationError) as err:
            log.warning("%s: брак, %s", model, err)
    return None  # в очередь на ручной разбор
Посчитаем на потоке в 50 000 чеков в месяц: 300 входных токенов вместе со схемой и 60 выходных на чек. Формула: 50 000 × (300 × цена входа + 60 × цена выхода) / 1 000 000. Цены наши, из каталога на 27.10.2026.
| Схема | Расчёт | В месяц |
|---|---|---|
Всё на gpt-6.1-sol | 15 000 × 1,70 + 3 000 × 8,50 | $51,00 |
Всё на gemini-3.8-flash | 15 000 × 0,637 + 3 000 × 3,187 | $19,12 |
Всё на gpt-6-luna | 15 000 × 0,10 + 3 000 × 0,50 | $3,00 |
gpt-6-luna, 3% брака уходит на gpt-6.1-sol | 3,00 + 0,03 × 51,00 | $4,53 |
gpt-6-luna, 10% брака уходит на gpt-6.1-sol | 3,00 + 0,10 × 51,00 | $8,10 |
gpt-6-luna у нас стоит как у OpenAI, $0,10 / $0,50 за миллион токенов (OpenAI). gpt-6.1-sol и gemini-3.8-flash на 15% ниже официальных цен OpenAI и Google. Доли брака в 3% и 10% — допущения, а не замер: свою долю узнаете, прогнав сотню реальных текстов через валидатор. Даже при 10% брака каскад обходится в шесть раз дешевле, чем всё на старшей модели.
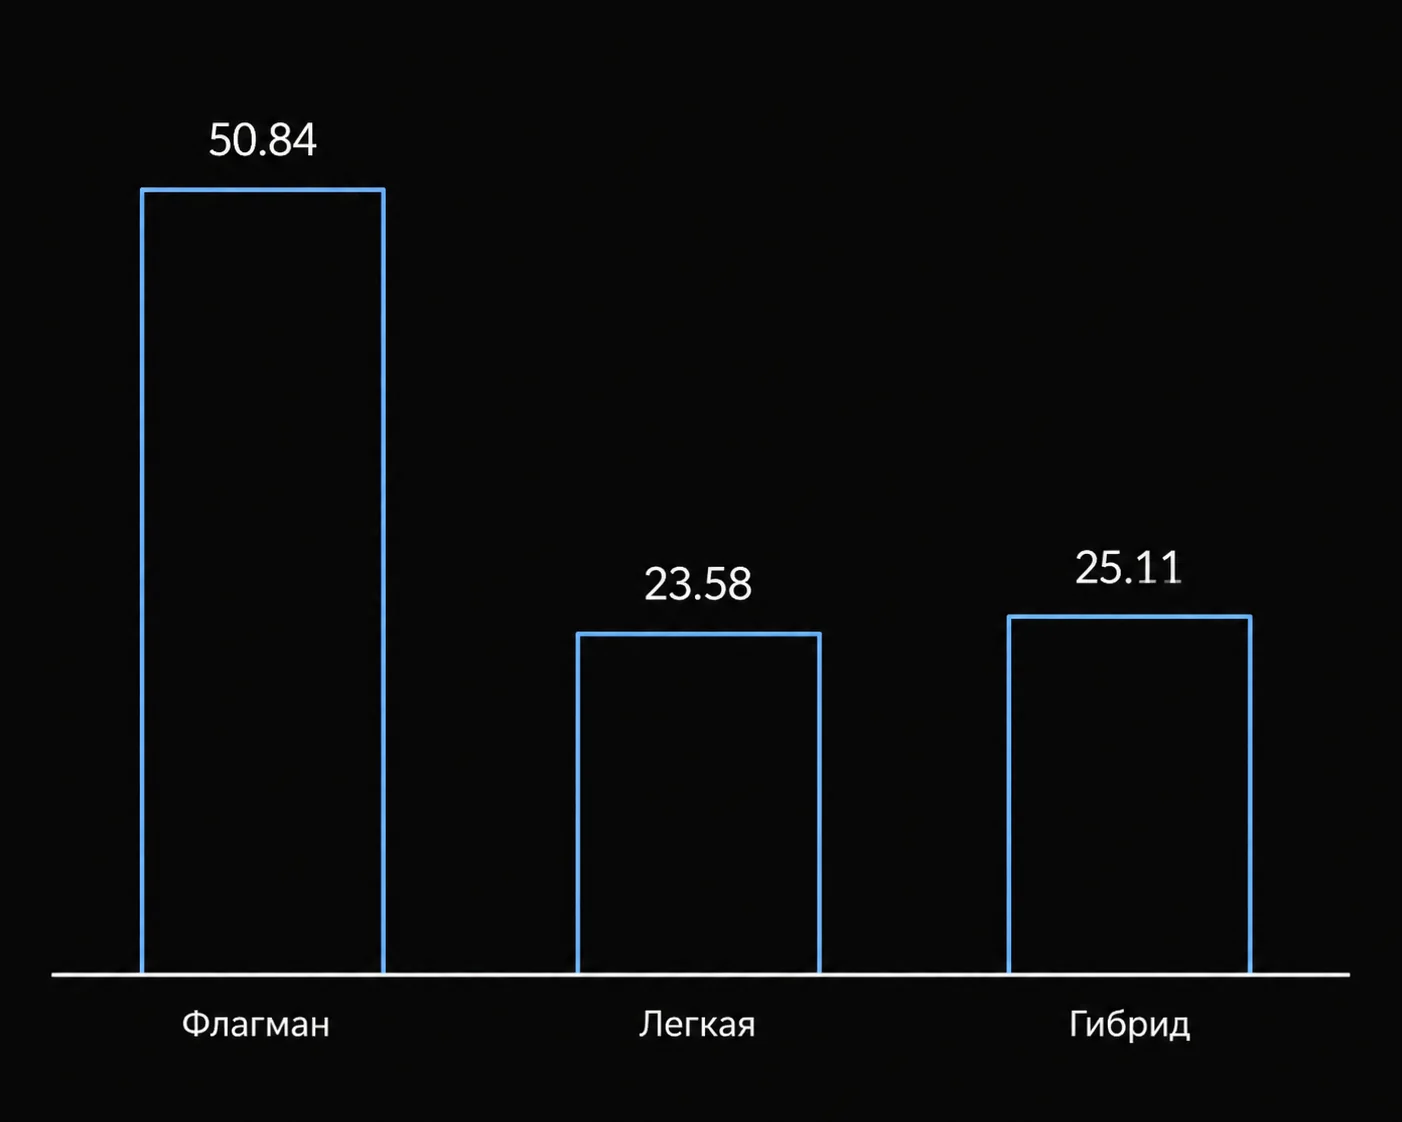
Расчёт — нижняя граница. Все три модели рассуждают, а черновик оплачивается по цене выхода. В нашем разборе счетов одна модель при 147 видимых токенах ответа написала 4408 скрытых. Сколько стоил конкретный запрос, показывает usage.cost в ответе. У Claude Haiku 5.5 токен дешевле, чем у gpt-6-luna, но через принудительный инструмент к каждому запросу добавляются 406 служебных токенов. Если они попадают в счёт так же, как у Anthropic напрямую, формула даёт 50 000 × (706 × 0,085 + 60 × 0,425) / 1 000 000 = $4,28, дороже gpt-6-luna. Как раздавать задачи моделям по цене в коде, мы разбирали в статье про маршрутизацию.
FAQ
Можно ли получать структурированный ответ стримом?
Можно. Anthropic стримит такие ответы как обычные, у Gemini куски потока — части JSON-строки, которые склеиваются в итоговый объект. Разбирайте JSON только после конца потока и после проверки причины остановки: промежуточный кусок почти всегда невалиден.
Подробнее: Anthropic API: модели и цены.
Почему первый запрос со схемой отвечает дольше?
Вендор готовит схему к работе. У OpenAI первый запрос с новой схемой идёт с дополнительной задержкой, у Anthropic компилируется грамматика, которая хранится в кэше 24 часа с последнего использования. Смена name или description кэш у Anthropic не сбрасывает, а смена структуры сбрасывает. Поэтому не собирайте схему заново на каждый запрос, например подставляя в enum свежий список из базы.
Подробнее: Anthropic API: модели и цены.
Как сделать поле необязательным в строгом режиме?
У OpenAI все поля должны быть в required, а необязательность выражается типом с null, например ["string", "null"]. У Anthropic необязательные параметры разрешены, но не больше 24 на запрос по всем строгим схемам вместе. В Pydantic этому соответствует поле str | None без значения по умолчанию: ключ обязателен, значение может быть пустым.
Подробнее: Anthropic API: модели и цены.