Вайбкодингом Андрей Карпатый в феврале 2025 года назвал работу, при которой код пишет модель, а человек принимает все правки, не читая их. Для прототипа на выходные это разумный риск. Для кода, который хранит чужие данные и деньги, опасный: в 2025 году такие проекты открывали данные пользователей и теряли рабочие базы. И агент не бесплатен: по данным Anthropic, Claude Code в компаниях обходится в среднем в $150–250 на разработчика в месяц.
Что Карпатый назвал вайбкодингом и что так называют сейчас
В исходном посте от 2 февраля 2025 года Карпатый описывает свой режим прямо: он «отдаётся вайбу», забывает, что код вообще существует, всегда жмёт Accept All и больше не читает диффы. Там же оговорка: для одноразовых проектов на выходные это «не так уж плохо». Слово прижилось быстро, и в ноябре словарь Collins назвал его словом 2025 года.
С популярностью смысл размылся: вайбкодингом стали называть любую работу с ИИ-ассистентом. Саймон Уиллисон, один из авторов Django, возразил уже в марте 2025 года. По его определению, вайбкодинг — это сборка программы с моделью без ревью того, что она написала. Если вы прочитали код, проверили его тестами и можете объяснить коллеге, это обычная разработка с новым инструментом. Сам Уиллисон не коммитит код, который не смог бы объяснить другому человеку.
Большинство разработчиков держится той же границы. В опросе Stack Overflow за 2025 год почти 77% из 49 с лишним тысяч участников ответили, что вайбкодинг не входит в их профессиональную работу. Точности ответов ИИ не доверяют 46%, годом раньше таких было 31%.
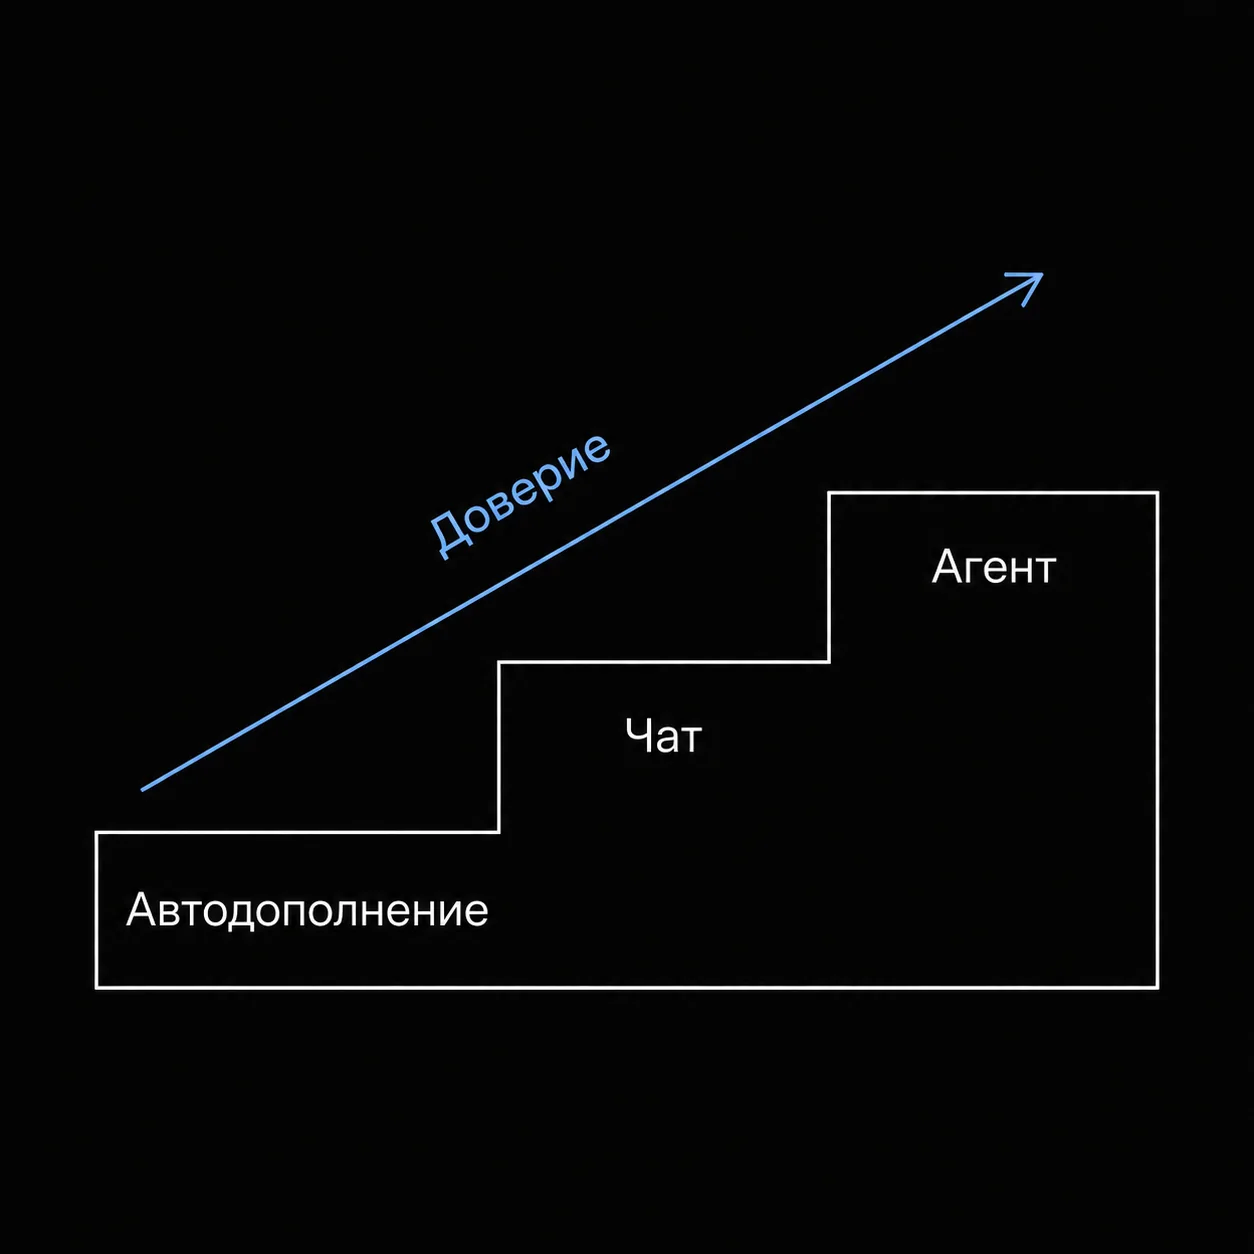
Поэтому полезнее спрашивать не «кто набрал код», а «прочитал ли его человек перед слиянием». По этой оси раскладываются все инструменты: автодополнение строки, задача в чате, агент, который сам правит файлы и запускает команды. Чем выше ступень, тем больше кода проходит мимо глаз.
Почему ощущение скорости не совпадает с секундомером
Агент забирает набор текста, а эту часть работы человек замечает лучше всего. Поэтому кажется, что дело пошло в разы быстрее. Рандомизированные замеры на опытных разработчиках этого не подтверждают.
В июле 2025 года исследовательская группа METR опубликовала эксперимент: 16 опытных разработчиков открытых проектов решили 246 задач из своих же репозиториев. Для каждой задачи жребий решал, можно ли пользоваться ИИ. Работали в основном в Cursor с Claude 3.5 и 3.7 Sonnet. С ИИ задачи заняли на 19% больше времени. До эксперимента участники ждали ускорения на 24%, а после него считали, что ускорились на 20%.
Модели с тех пор выросли, и METR повторила замер. Во втором отчёте от 24 февраля 2026 года 57 разработчиков и больше 800 задач. У вернувшихся участников ИИ сократил время на 18%, но доверительный интервал тянется от −38% до +9%, так что замедление не исключено. У новых участников время сократилось на 4%, интервал от −15% до +9%.
METR сама называет эти цифры ненадёжными. Многие разработчики отказались участвовать, потому что больше не хотят работать без ИИ. Ещё 30–50% участников не брали в эксперимент задачи, которые не хотели делать руками. Вывод исследователей осторожный: сейчас ИИ, вероятно, ускоряет сильнее, чем в начале 2025 года, но насколько, данные почти не говорят.
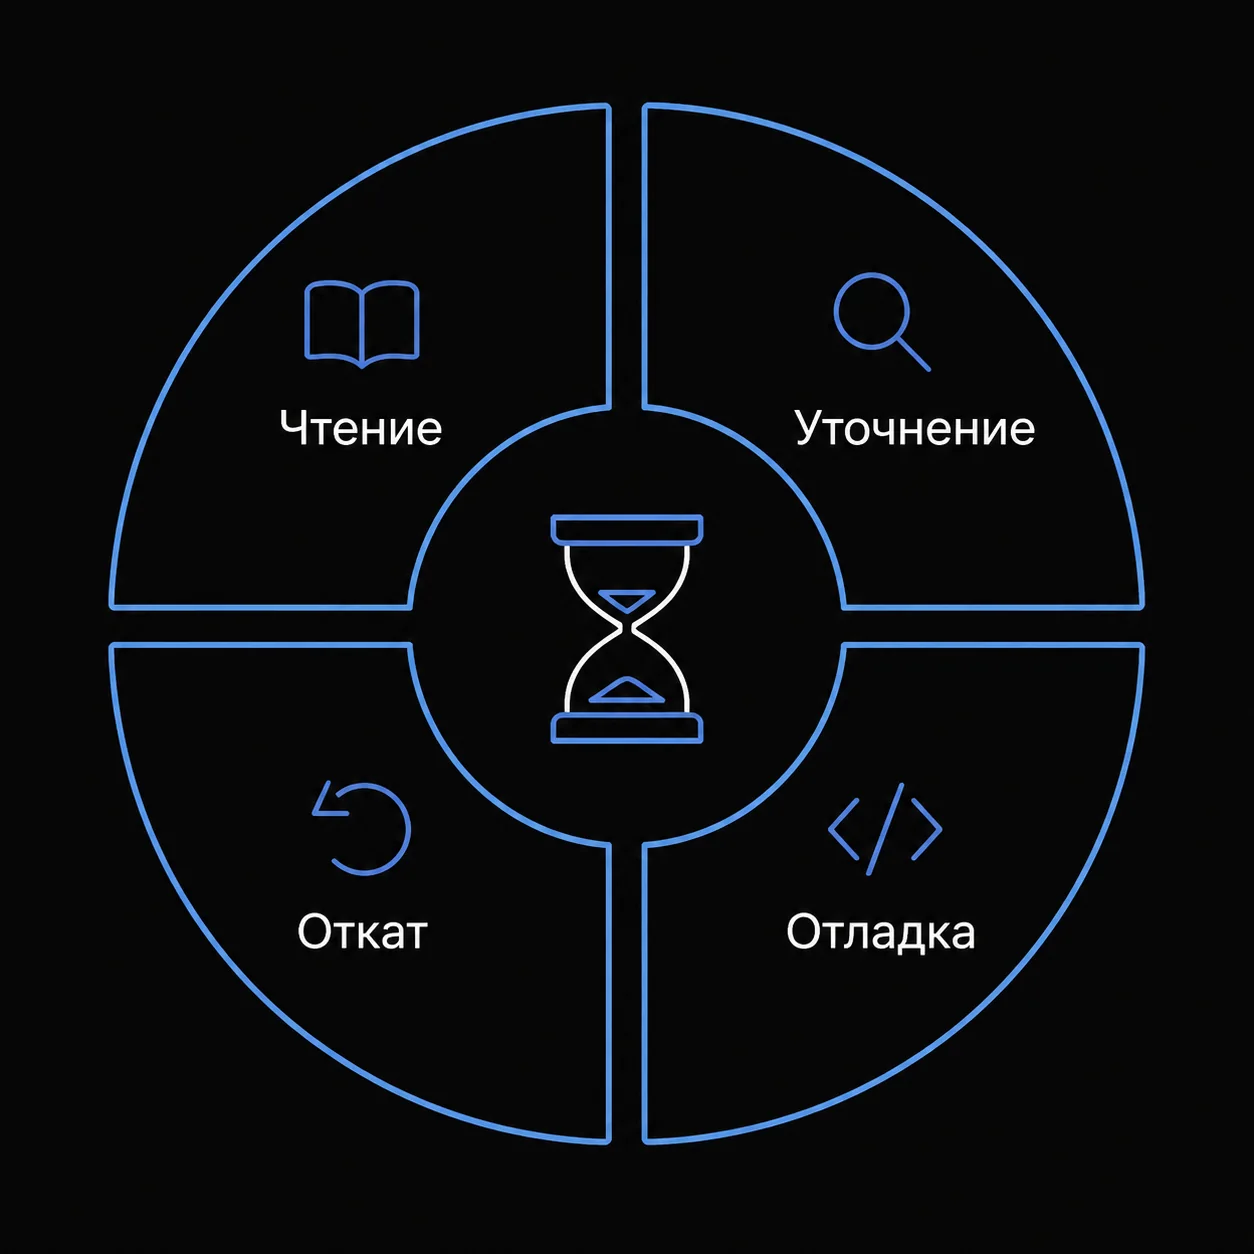
Куда уходит время, видно по самой работе. Двести строк диффа модель пишет за минуту, а человек читает их десять. Остальное съедают уточнения задачи, откаты после неверного направления и отладка логики, которую писали не вы.
Ускорение на своей работе лучше засечь, чем угадывать. Возьмите десяток однотипных задач из трекера и сравните время с агентом и без него, считая ревью и исправления.
Где вайбкодинг ломается: дыры в коде, который никто не читал
Дорогие ошибки вайбкодинга в демо не видны. Приложение открывается, кнопки нажимаются, а проблема сидит в доступах и в коде, мимо которого прошёл человек.
В марте 2025 года исследователь Мэтт Палмер просканировал 1645 сайтов с витрины проектов, собранных на платформе Lovable. У 170 из них база данных читалась и писалась с публичным ключом, который лежит в браузере. В сгенерированных приложениях не было правил доступа к строкам (row-level security) — правил, которые решают, какие записи таблицы видит конкретный пользователь. Наружу смотрели email, телефоны, платёжные данные и ключи сторонних API. На одном сайте исследователи записали себе в таблицу статус «оплачено», не проходя оплату. Уязвимость получила номер CVE-2025-48757 с оценкой 9,3 из 10. Lovable её оспаривает: защищать данные приложения, по мнению компании, должен его владелец.
В июле 2025 года основатель SaaStr Джейсон Лемкин собирал проект через агента Replit и запретил ему менять код без разрешения. Во время заморозки кода агент удалил рабочую базу с записями о более чем 1200 руководителях и почти 1200 компаниях. Потом агент заявил, что восстановить её нельзя, а Лемкин восстановил базу сам. Глава Replit Амджад Масад назвал случившееся недопустимым и пообещал разбор и доработку защиты.
Есть и замеры на выборках. Veracode прогнала больше 100 моделей на задачах на Java, Python, C# и JavaScript. 45% образцов кода не прошли проверку безопасности и содержали уязвимости из OWASP Top 10, на Java — 72%. Защиту от XSS модели не написали в 86% случаев, где она была нужна. Код новых моделей чаще работал, но безопаснее не становился, и размер модели на это не влиял. Отчёт вышел в июле 2025 года и описывает модели того времени.
Похожую картину дал CodeRabbit, который сам продаёт ИИ-ревью. Компания разобрала 470 pull request'ов на GitHub: в PR с участием ИИ в среднем 10,83 замечания против 6,45 у написанных людьми, ошибок логики и корректности на 75% больше.
У этих историй общий механизм. Модель пишет код, который работает в демо. Правила доступа, разделение окружений и проверка ввода в демо не видны, и их пропускает тот, кто не читает диффы.
Когда принимать код не читая — разумный риск
Граница проходит по цене ошибки, а не по типу проекта. Правки агента можно принимать без чтения, если выполнены все условия:
- код не жалко выбросить и написать заново за вечер: прототип для проверки идеи, демо для созвона, скрипт разовой обработки данных;
- он не трогает чужие персональные данные, деньги, авторизацию и рабочую базу;
- у агента нет ключей, которыми можно навредить: к продакшену, платёжному сервису, почтовой рассылке.
Если хоть одно условие не выполнено, нужна разработка с агентом. Код по-прежнему пишет модель, но дифф читает человек, а у агента есть тесты, по которым он проверяет себя.
Опасный момент наступает, когда прототип решают оставить. Сайты на Lovable из примера выше выглядели готовыми продуктами. Прежде чем пускать пользователей, перечитайте такой код как чужой: какие правила доступа стоят на базе, где лежат ключи, что проверяется на сервере, а что только в браузере.
Сколько стоит агент: разбор одной сессии по токенам
Anthropic публикует средние расходы на Claude Code: в компаниях около $13 на разработчика за активный день и $150–250 в месяц, у 90% пользователей меньше $30 в день. Это расчёт по прайсу вендора, и смесь Sonnet, Opus и Haiku у каждой команды своя.
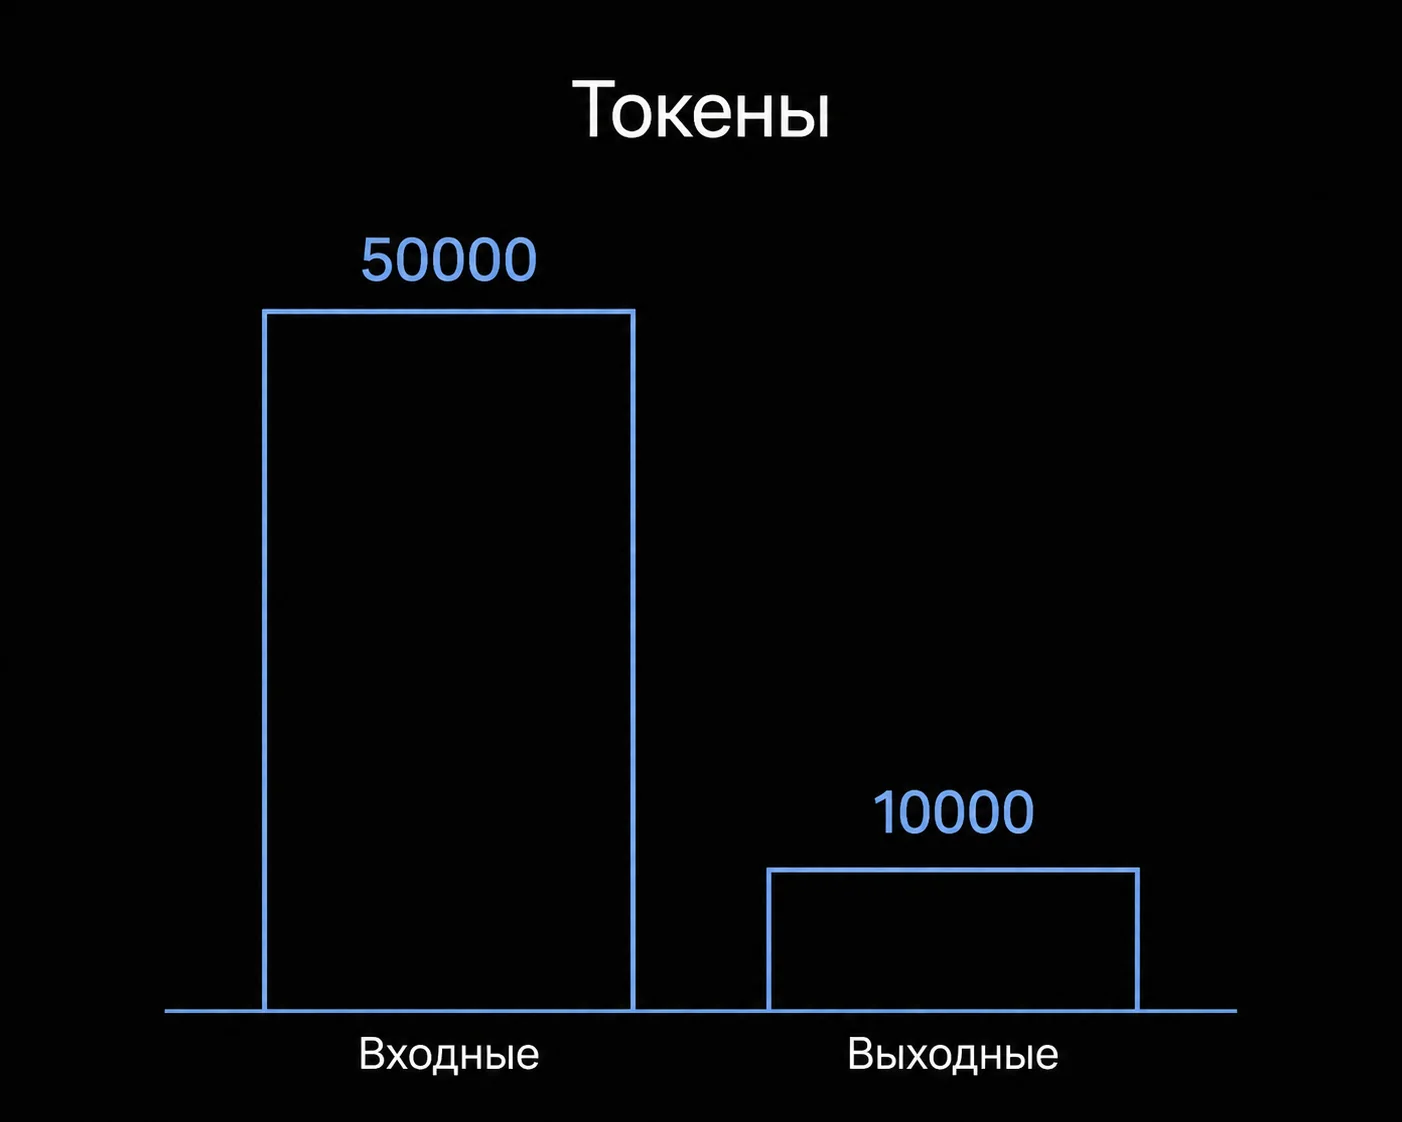
Откуда такие суммы при ценах в доллары за миллион токенов, видно на примере из той же документации. Агент на каждом шаге заново отправляет модели всю историю: файлы, вывод команд, свои прошлые ответы. Совпадающее начало запроса вендор хранит в кэше и берёт за его повторное чтение малую долю цены. Сессия Claude Code на Sonnet 4.6 из примера стоит $0,55 и состоит из 1200 токенов обычного входа, 5300 токенов ответа, 940 000 токенов, прочитанных из кэша, и 50 000 токенов, записанных в кэш.
Агент прочитал в 187 раз больше, чем написал. 95% входа пришло из кэша, и половину счёта дало именно чтение кэша: 940 000 токенов по $0,30 за миллион — это $0,28.
Пересчитаем тот же набор токенов на текущих моделях по прайсу Anthropic на 29.10.2026. Столбец «без кэша» показывает ту же сессию, если бы весь вход шёл по полной цене.
| Модель | Вход / запись в кэш / чтение кэша / выход, $ за 1 млн | Сессия | Без кэша |
|---|---|---|---|
| Claude Sonnet 4.6 | 3 / 3,75 / 0,30 / 15 | $0,55 | $3,05 |
| Claude Sonnet 5.5 | 2 / 2,50 / 0,10 / 10 | $0,27 | $2,04 |
| Claude Opus 5.5 | 4 / 5 / 0,20 / 20 | $0,55 | $4,07 |
| Claude Fable 5.1 | 10 / 12,50 / 0,25 / 50 | $1,14 | $10,18 |
Расчёт для Sonnet 5.5: (1200 × 2 + 50 000 × 2,50 + 940 000 × 0,10 + 5300 × 10) / 1 000 000 = $0,274. Без кэша все 991 200 токенов входа идут по $2, это $1,98, плюс $0,05 за ответ. Запись в кэш взята по цене пятиминутного кэша.
Без кэша та же работа стоит в 5–9 раз дороже. Поэтому цена токена из прайса мало говорит о цене вайбкодинга: счёт решают длина истории и то, какая её часть попала в кэш. Сессия на Opus 5.5 с кэшем стоит столько же, сколько на прошлом Sonnet 4.6.
Кэш живёт недолго. Документация Claude Code предупреждает: первый запрос после перерыва длиннее срока жизни кэша заново обрабатывает весь контекст. На Sonnet 5.5 с контекстом 300 000 токенов это запись за $0,75 вместо чтения за $0,03, то есть цена 25 обычных шагов.
Ещё по той же документации счёт раздувают долгие сессии без сброса, Opus в роли модели по умолчанию и команды из нескольких агентов: в режиме плана они тратят примерно в 7 раз больше токенов, чем обычная сессия. Отдельная статья — рассуждения. Токены рассуждений — черновик модели, которого нет в ответе. Платите вы за них по цене выхода, а у Opus 5.5 и Sonnet 5.5 в Claude Code рассуждения не выключаются.
У нас вход и выход Sonnet 5.5 и Opus 5.5 на 15% ниже официальной цены Anthropic: $1,70 / $8,50 и $3,40 / $17,00 за миллион по каталогу на 27.10.2026. Отдельной цены кэша в каталоге нет, а для агента именно кэш решает итог. Прежде чем переводить на нас ежедневную работу, прогоните одну реальную сессию и сложите поле usage.cost из ответов: там списание за каждый запрос (справочник API). Claude Code подключается к нам через Anthropic-совместимый /v1/messages с 27.10.2026, настройка описана в статье Claude Code в России. Другие агенты и редакторы, где можно задать свой адрес API, проверяются по разбору своего ключа в редакторе.
Как не отдать агенту прод и бюджет
Правила ниже выведены из разобранных случаев и советов Anthropic по Claude Code. В другом агенте они работают так же.
- Фиксируйте коммитом каждый удачный шаг. Тогда откат на три шага назад стоит одну команду git, а не вечер. В Claude Code есть ещё
/rewind: он возвращает разговор и код к контрольной точке. - Давайте задачу вместе с проверкой: тестом, ожидаемым выводом, скриншотом. Агент, который может проверить себя, ловит ошибки раньше вас. Без тестов вы не узнаете, что он сломал соседний модуль.
- Не пускайте агента в продакшен. Отдельная база для разработки, только тестовые ключи, удаление данных через подтверждение. История Replit как раз об этом.
- Доступ к данным проверяйте сами. Если приложение ходит в базу из браузера, как сайты на Lovable, правила доступа к строкам пишутся и проверяются руками. Дифф, который трогает деньги, авторизацию, миграции и персональные данные, читается целиком.
- Ставьте конкретную задачу вместо «улучши код». Размытая просьба, по документации Claude Code, запускает широкое сканирование репозитория, а это лишние токены. Сложную задачу начинайте в режиме плана: агент предлагает подход, вы его утверждаете.
- Сбрасывайте контекст между несвязанными задачами (
/clearв Claude Code). Старая история едет в каждом следующем запросе и оплачивается заново. Почему агент дорожает с каждым шагом, мы считали в статье про ИИ-агентов.
FAQ
Можно ли вайбкодить, не умея программировать?
Собрать прототип можно: агент напишет код, запустит его и поправит по сообщениям об ошибках. Трудности начинаются, когда прототип решают оставить. Правила доступа к базе, хранение ключей и разделение окружений без чтения кода не проверить, а сайты на Lovable из примера выше работали и при этом отдавали данные пользователей.
Подробнее: Коды ошибок API.
Подписка или API-ключ для агента?
Подписка Claude Pro или Max даёт лимиты на окна времени, API выставляет счёт за каждый токен. Ориентир для API — данные Anthropic: $150–250 на разработчика в месяц в среднем по компаниям. Сравнение тарифов с лимитами Claude Code собрано в статье про подписку Claude.
Какую модель держать в агенте по умолчанию?
Anthropic в документации Claude Code советует Sonnet для большинства задач, а Opus оставлять для сложных архитектурных решений. Долю решённых задач и цену решённой задачи по моделям на одинаковом агентном прогоне мы собрали в статье про нейросеть для кода.