«Оживить фото» разработчики называют задачей image-to-video (I2V). Нейросеть не реставрирует старое изображение и не восстанавливает исторические кадры. Она берет снимок как первый кадр и методами диффузии рассчитывает физику движения объектов на несколько секунд вперед.
Раньше диффузионные модели держали 4–5 секунд движения, после чего лица искажались. Релизы второй половины 2026 года, включая Kling 4.0 и Seedance 2.5, генерируют сцены до 30 секунд с синхронной звуковой дорожкой.
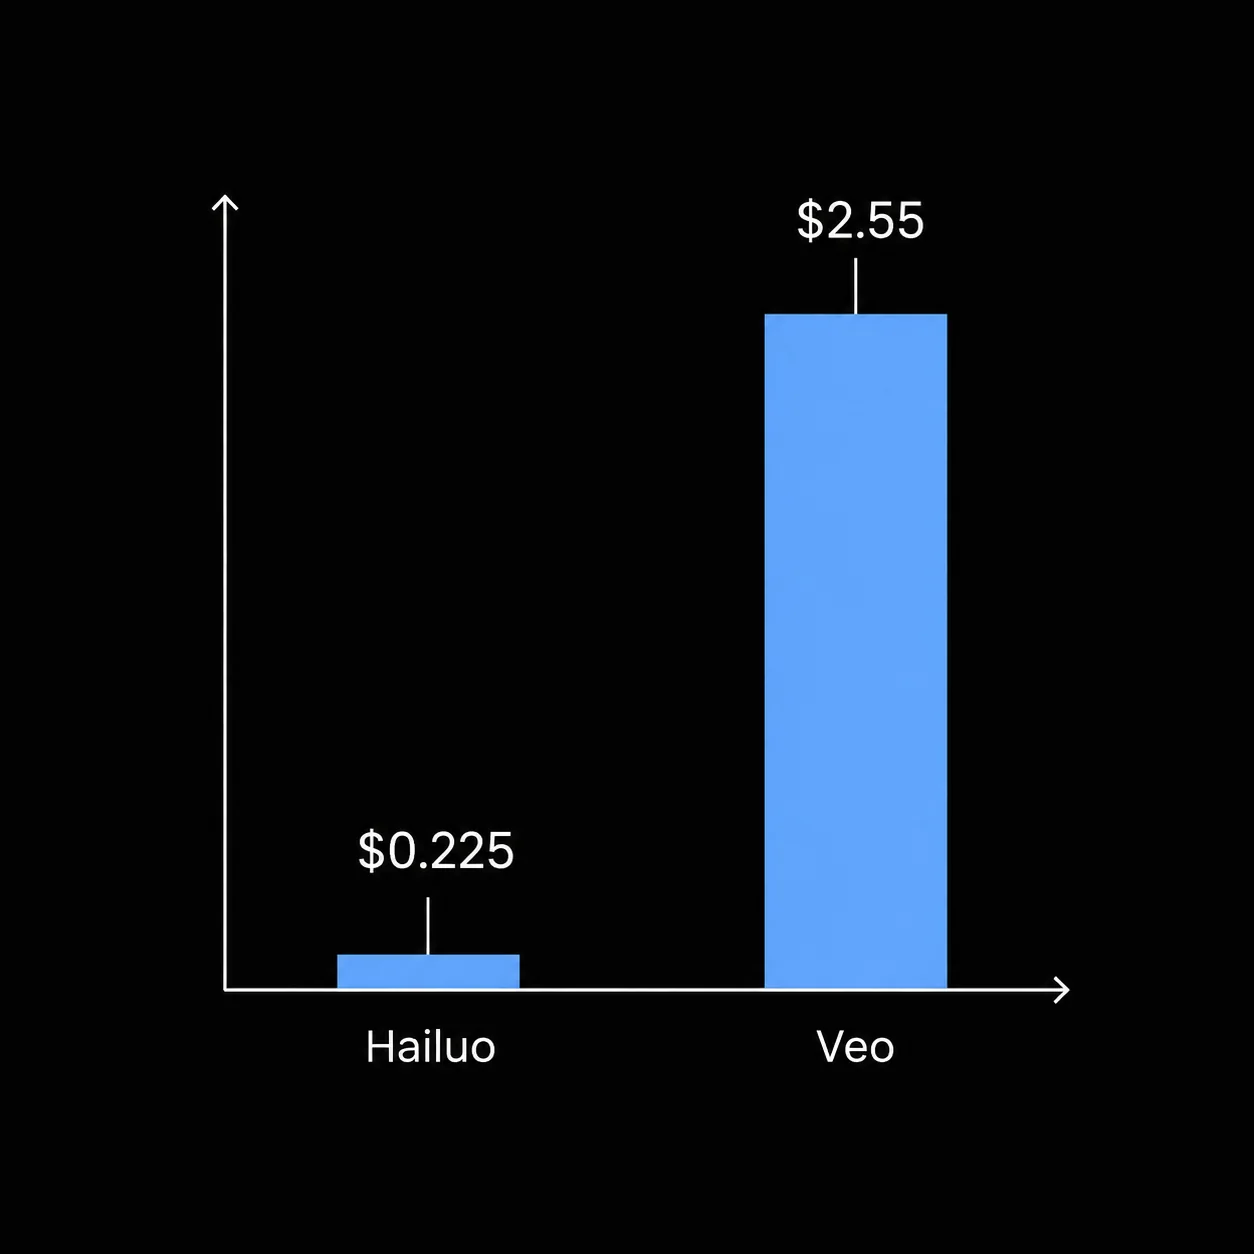
Ниже — расчет стоимости удачного дубля, механика управления кадром и правила составления промптов.
Кадр-донор и промпт-режиссер: механика управления
При генерации видео из текста (text-to-video) алгоритм берет шум и сам определяет внешность объекта, одежду и свет. В image-to-video композицию, цвет и анатомию лица задает опорный снимок.
Два правила работы:
- Модель наследует дефекты исходника. Если на фото есть зернистость, пересвет, размытые зрачки или обрезанное плечо, нейросеть сохранит искажения в движении. Диффузионная видеомодель не работает как апскейлер: перед отправкой в пайплайн очистите снимок от артефактов.
- Промпт задает действие, а не внешность. Ошибка новичков — описывать то, что уже есть на фото. Если передать снимок пожилого человека и написать в промпте
старик с седой бородой в темном костюме, модель попытается пересобрать внешность заново и изменит черты лица.
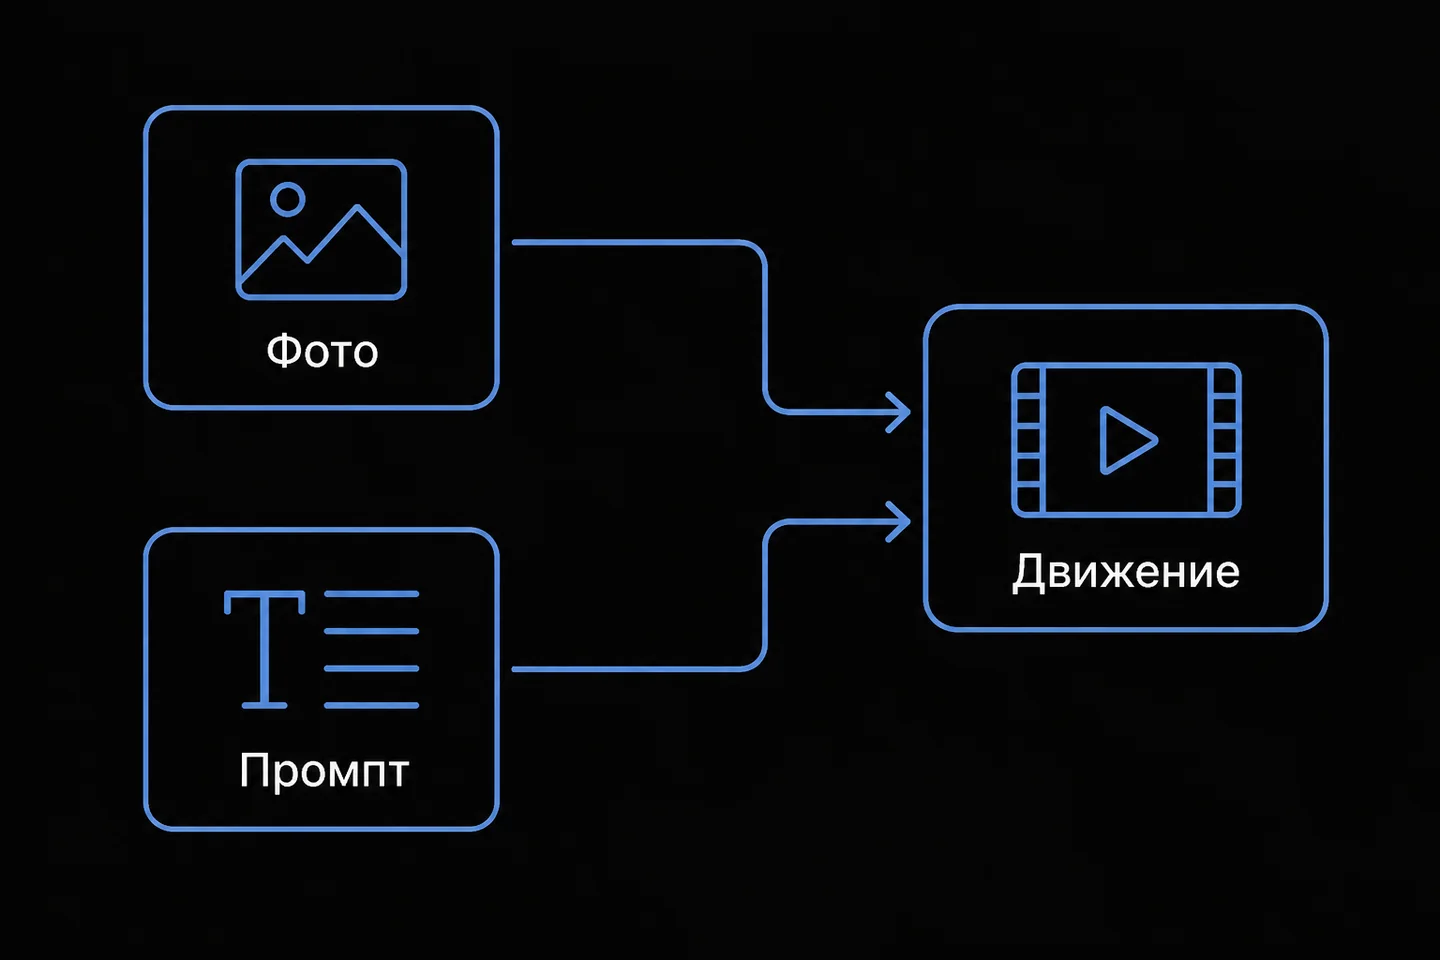
В запросе для I2V указывают только динамику:
- Мимика и направление взгляда:
медленно переводит взгляд в камеру, легкая полуулыбка, естественное моргание; - Движение элементов одежды и окружения:
легкий ветер шевелит пряди волос, листва деревьев на заднем плане колышется; - Положение камеры:
плавный наезд камеры (zoom in), кинематографичная глубина резкости, стабильный ракурс.
Модели для оживления фото
Модели делятся на закрытые коммерческие платформы и открытые веса, доступные для запуска на своих GPU или аренды через облачные шлюзы.
Hailuo 2.3 (MiniMax Video)
Hailuo 2.3 компании MiniMax оптимизирована под мимику, дыхание и микромоторику губ.
Модель работает только в режиме image-to-video и не принимает текстовые запросы без опорного кадра. Длительность фиксирована: 6 или 10 секунд. Разрешения: 768P и 1080P.
Семейство Kling (Kuaishou)
Линейка Kling:
- [Kling 3.0] генерирует сцены в разрешениях Standard, Pro и 4K с нативным аудио (шумы, шаги, синтезированные реплики). Официальные тарифы на kling.ai/dev/pricing рассчитываются в юнитах (1 Unit = $0.14).
- Kling 4.0 увеличила хронометраж одного прогона до 30 секунд и получила механизм Omni Reference для фиксации геометрии лица на длинных видео.
ByteDance Seedance 2.0 и 2.5
Модели ByteDance ориентированы на динамичные сцены и взаимодействие персонажей с предметами:
- Seedance 2.0 (релиз февраля 2026 года) генерирует ролики длительностью от 4 до 15 секунд в разрешениях 480p и 720p и принимает до 9 входных изображений и 3 видеоклипов в качестве визуального контекста.
- Seedance 2.5 (релиз 31 июля 2026 года) по данным анонса ByteDance рассчитывает до 30 секунд непрерывной анимации с синхронизированной озвучкой и обрабатывает до 50 мультимодальных референсов.
Google DeepMind Veo 3.1
Модели DeepMind доступны разработчикам через Gemini API и Google Cloud Vertex AI. Google Veo 3.1 автоматически генерирует синхронный пространственный звук под видеоряд. По информации из релиза Ingredients to Video на blog.google, модель масштабирует вертикальный формат 9:16 под короткие ролики и выводит видео в 1080p и 4K.
В каталоге доступна версия [Veo 3.1 Fast] с фиксированной оплатой за сгенерированный клип, а не посекундно.
Открытые архитектуры: Alibaba Wan 2.1 и Wan 2.2
Для локального запуска Alibaba Cloud опубликовала веса серии Wan 2.1 на GitHub под лицензией Apache 2.0.
Для анимации фото подходит модель Wan 2.1 FLF2V-14B (First-and-Last Frame to Video). Она принимает два кадра: стартовый снимок и конечную позу. Нейросеть интерполирует промежуточные кадры, приводя объект в заданную точку. Облегченная версия Wan 2.1 1.3B умещается в потребительские видеокарты с 10 ГБ VRAM при разгрузке памяти на CPU. В каталоге Altrouter также доступна коммерческая версия [Wan 2.2 Video].
Экономика генерации: тарифы и расчет стоимости дубля
Диффузионные процессы вероятностны: анатомию пальцев или угол поворота глаз нельзя гарантировать с первого раза. Рабочий расчет закладывает коэффициент брака: 2–3 генерации на один чистовой ролик.
Цены в каталоге Altrouter:
| Модель | Модель оплаты | Базовое разрешение | Цена Altrouter | Официальная цена вендора | Скидка |
|---|---|---|---|---|---|
| Hailuo 2.3 | За секунду | 768P | $0.0375 / сек | $0.0467 / сек | 20% |
| Hailuo 2.3 | За секунду | 1080P | $0.06255 / сек | — | — |
| Kling 2.6 | За секунду | Базовое (без звука) | $0.06875 / сек | $0.07 / сек | 2% |
| Kling 3.0 | За секунду | Standard (без звука) | $0.0875 / сек | — | — |
| Kling 3.0 | За секунду | Standard (со звуком) | $0.125 / сек | — | — |
| Wan 2.7 Video | За секунду | 720p | $0.092 / сек | $0.10 / сек | 8% |
| Seedance 2.0 | За секунду | 720p | $0.246 / сек | $0.30 / сек | 18% |
| Seedance 2.5 | За секунду | 720p | $0.39375 / сек | $0.473 / сек | 17% |
| Veo 3.1 Fast | За ролик | 720p | $0.65 / ролик | — | — |
| Veo 3.1 Fast | За ролик | 1080p | $0.78 / ролик | $0.96 / ролик | 19% |
| Wan 2.2 Video | За ролик | 720p | $0.52 / ролик | — | — |
Примечание: для сопоставления с рублями при курсе 80 ₽ за доллар 6 секунд на Hailuo 2.3 обойдутся в ~$0.225 (около 18 ₽), а ролик на Seedance 2.0 той же длительности — в ~$1.47 (около 118 ₽). Посекундные затраты подробно разобраны в статье о стоимости нейросетей для видео.
Логика тарификации: Veo 3.1 Fast и Wan 2.2 списывают фиксированную сумму за генерацию клипа независимо от длительности. Для роликов на 8–10 секунд фиксированная ставка выгоднее посекундной. Для превью на 4–6 секунд дешевле посекундные тарифы Hailuo 2.3 и Kling 3.0.
Запуск рендера через API
Генерация видео занимает от 40 секунд до нескольких минут в зависимости от длительности сцены и очереди на сервере. API работает асинхронно: клиент создает задачу на рендер, получает id, затем опрашивает статус готовности.
Пример скрипта на Python для отправки входного фото и получения готового MP4-видео через единый шлюз Altrouter:
import os
import time
import requests

API_KEY = os.getenv("ALTROUTER_API_KEY", "ar-your-api-key")
BASE_URL = "https://api.altrouter.ai/v1"

headers = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}

# 1. Отправка задачи на рендер (image-to-video)
payload = {
    "model": "hailuo-2.3",
    "prompt": "slow head turn towards the camera, gentle natural blink, subtle smile, soft cinematic daylight",
    "seconds": 6,
    "image": ["https://images.unsplash.com/photo-1534528741775-53994a69daeb?auto=format&fit=crop&w=1080&q=80"]
}

response = requests.post(f"{BASE_URL}/videos", json=payload, headers=headers)
response.raise_for_status()

task_data = response.json()
video_id = task_data["id"]
print(f"Задача поставлена в очередь. ID: {video_id}")

# 2. Опрос готовности результата (polling)
while True:
    status_response = requests.get(f"{BASE_URL}/videos/{video_id}", headers=headers)
    status_response.raise_for_status()
    result = status_response.json()

    status = result.get("status")
    print(f"Текущий статус рендера: {status}")

    if status == "completed":
        video_url = result.get("url")
        cost = result.get("cost")
        print(f"Рендер завершен успешно!")
        print(f"Ссылка на файл: {video_url}")
        print(f"Фактическое списание: ${cost} USD")
        break
    elif status == "failed":
        error_info = result.get("error", {})
        print(f"Ошибка генерации: {error_info.get('message', 'Неизвестная ошибка')}")
        break

    time.sleep(5)
Три правила интеграции:
- Интервал опроса: опрашивайте эндпоинт не чаще раза в 3–5 секунд, чтобы не превысить лимит запросов.
- Параметр
image: схема принимает массив ссылок. При анимации фото первым элементом передают прямой URL изображения. - Фиксация расходов: сервер возвращает итоговую сумму списания в поле
costобъекта задачи.
Границы возможностей: где модели ошибаются
Качество анимации зависит от движения, описанного в промпте.
Что получается стабильно
- Микромимика лица: моргание, полуулыбка, перевод взгляда;
- Физика легких сред: волосы на ветру, складки ткани, пар от чашки чая, рябь на воде;
- Плавные движения камеры: наезд, статичный портретный план, медленное панорамирование фона.
Где диффузия дает сбои
- Кисти рук и пальцы: если на фото человек подпирает подбородок рукой или держит пальцы у лица, в 70% случаев нейросеть исказит количество или форму фаланг при движении.
- Текстовые надписи: мелкий текст на одежде, бейджах или вывесках размывается со второй секунды.
- Дрейф сходства (face drift): с каждым кадром нейросеть все больше опирается на собственные сгенерированные пиксели, а не на исходник. На 5–6 секунде лицо узнаваемо, но к 12–15 секунде без жестких референсов черты персонажа искажаются.
- Групповые портреты: если на фото больше двух человек, физика часто рассинхронизируется: одно лицо поворачивается нормально, второе застывает или деформируется.
Выбор: веб-сервис или API
Выбор инструмента зависит от объема и регулярности задач.
- Приложения и сайты вендоров: подходят для разовых задач — например, оживить одну семейную фотографию. Подписка или приветственные кредиты решают бытовую задачу без кода.
- Шлюз API: нужен для интеграции генерации в веб-сервисы, Telegram-ботов, рекламные генераторы или обработку товарных каталогов. API позволяет комбинировать модели: делать черновые прогоны на Hailuo 2.3, а финальный рендер со звуком отправлять в Veo 3.1 Fast или Kling 3.0. Разбор форматов доступа — в статье «Ключ или подписка».
FAQ
Как нейросеть оживляет статичную фотографию?
Модель берет исходный снимок как первый кадр и диффузионным алгоритмом достраивает движение во времени. Она моделирует вероятное физическое продолжение кадра на основе обучающей выборки видеозаписей.
Подробнее: Генерация видео через API.
Сколько стоит оживить одно фото через нейросеть?
Стоимость зависит от хронометража и разрешения. 6 секунд портрета в Hailuo 2.3 стоят от $0.225 (около 18 ₽ при курсе 80 ₽/$). Ролик на Kling 3.0 без звука стоит $0.44 за 5 секунд, а рендер в Veo 3.1 Fast — $0.65–$0.78 за клип. С учетом брака рассчитывайте на 2–3 генерации для одного чистового дубля.
Подробнее: Hailuo 2.3: цены и параметры.
Какая нейросеть лучше всего держит лицо человека?
Для портретов мягкую мимику и стабильное лицо дают Hailuo 2.3 и Kling 3.0. Для длинных сцен без потери сходства подходят Kling 4.0 или Wan 2.1 FLF2V с фиксацией начального и конечного кадров.
Подробнее: Hailuo 2.3: цены и параметры.
Можно ли анимировать старые поврежденные снимки?
Да, но перед генерацией видео старый снимок нужно отреставрировать: убрать заломы, трещины и цифровой шум. Видеомодель не чистит картинку, а анимирует имеющиеся дефекты, превращая трещины в плавающие артефакты.
Подробнее: Генерация видео через API.
Почему лицо на видео искажается после 5–10 секунд?
Это дрейф признаков (feature drift). С каждым новым кадром модель накапливает погрешность относительно начального фото. Чтобы сохранить сходство, видео генерируют отрезками по 4–6 секунд или используют модели с контролем референсов (Seedance 2.5).
Подробнее: Seedance 2.5: цены и параметры.