Разработчики видеогенераторов перешли от общей резкости кадра к управляемости режиссуры: предсказуемости движений, удержанию внешности персонажей и нативной генерации аудиодорожки. Зритель в мобильной ленте вряд ли заметит микроконтраст текстур, но сломанную анатомию рук, дрифт при панорамировании камеры или рассинхрон липсинка видно сразу.
При выборе модели для продакшена критичны три фактора: режим ввода (текст, опорный кадр или связка первого и последнего кадров), максимальная длина непрерывного дубля и модель тарификации (посекундная ставка против фиксированной платы за запуск).
Text-to-Video, Image-to-Video и Reference-to-Video
Способ ввода определяет контроль над итоговым материалом.
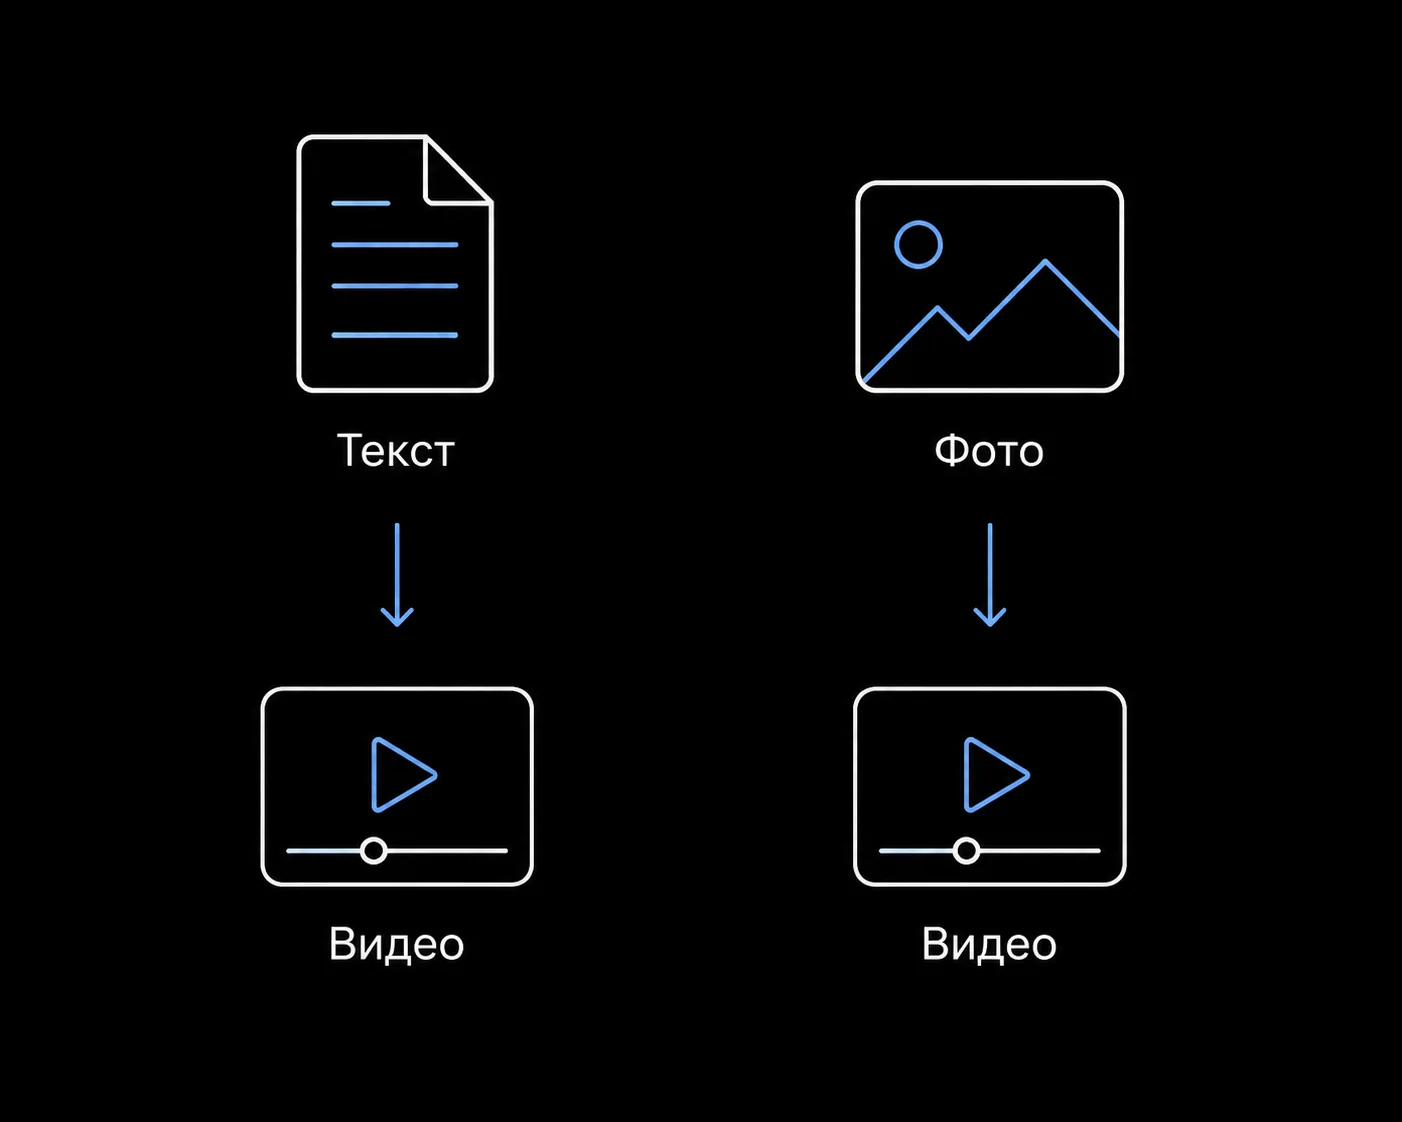
- Text-to-Video (T2V). Сцена строится по текстовому описанию. Модель с нуля задает композицию, ракурс, освещение и типаж героев. Подходит для пейзажей, абстрактных фонов и общих планов без жестких требований к внешности актеров.
- Image-to-Video (I2V). Модели передают опорное изображение в качестве первого кадра. Нейросеть генерирует движение, сохраняя стилистику и детали оригинала. Промпт описывает траекторию движения объектов и работу виртуальной камеры. Разбор механики оживления кадров — в статье про генерацию видео из фото.
- Reference-to-Video (R2V) и кинематический контроль. Модели принимают несколько типов входных данных. Seedance 2.5 использует набор референсов: до 30 изображений, 10 видеофрагментов и 10 аудиозаписей, фиксируя внешность героя, динамику движений и окружение. Технология Motion Control в линейке Kling VIDEO 3.0 удерживает лицо персонажа под разными углами обзора без деформаций.
По официальной документации MiniMax модель MiniMax-Hailuo-2.3 генерирует видео как из текста, так и из картинок. Облегченная версия Hailuo-2.3-Fast ограничена только режимом I2V.
Длительность, звук и скрытые расходы
Лимиты хронометража
Непрерывный инференс обычно ограничен 5–15 секундами, поэтому длинные сюжеты разбивают на короткие шоты.
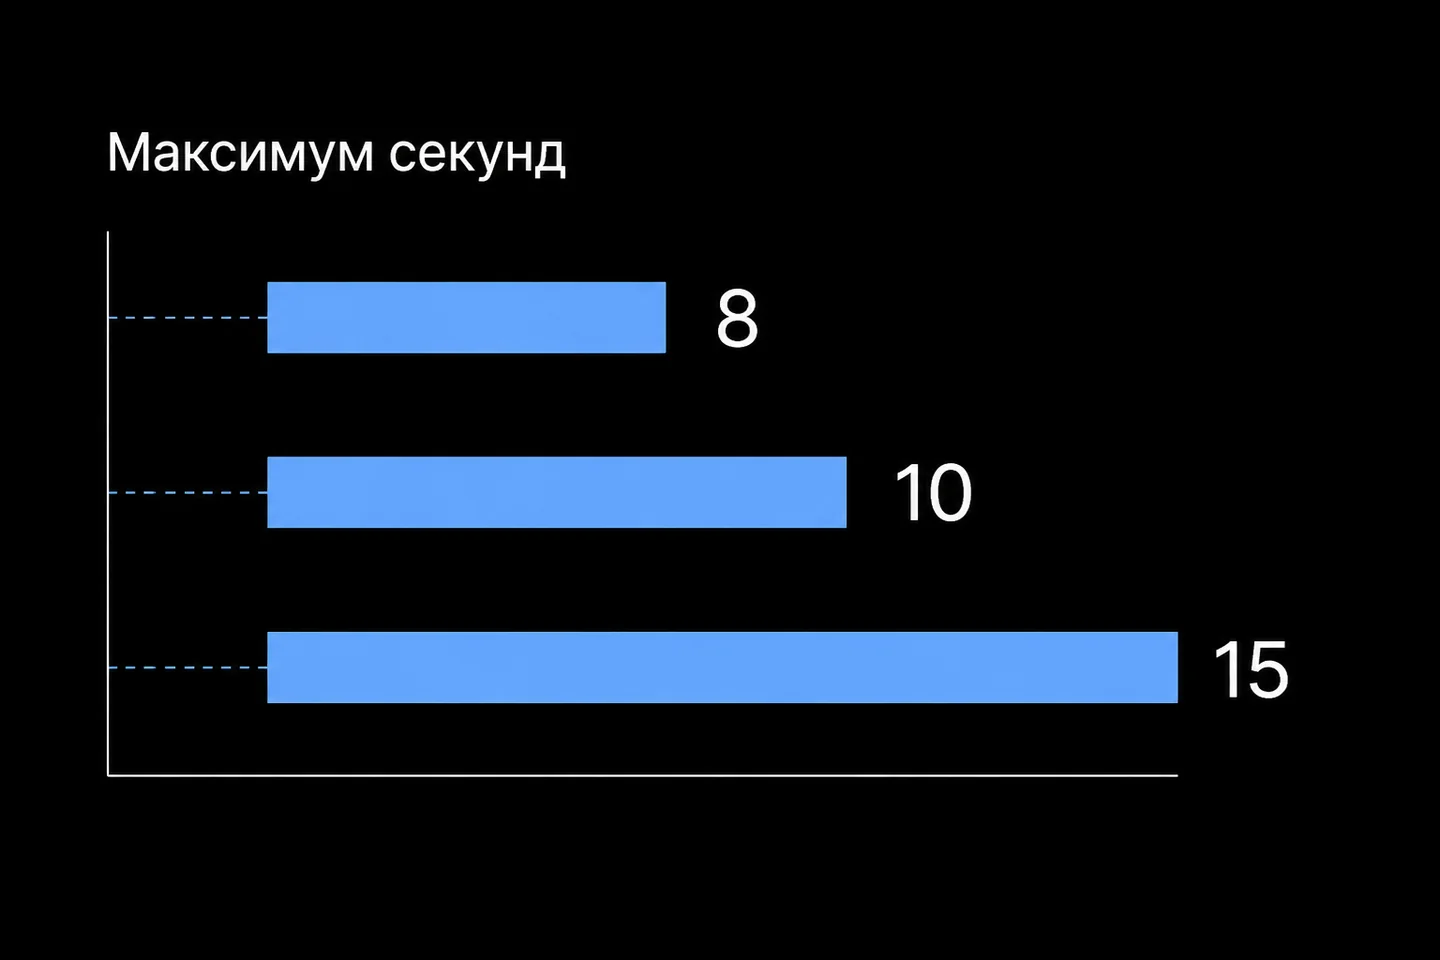
Seedance 2.5 от ByteDance генерирует до 30 секунд в один проход. Но для рекламы и постановочных видео надежнее покадровая сборка: склеить три дубля по 6–8 секунд проще и точнее по композиции, чем умещать сюжет в один полуминутный дубль.
Генерация аудиодорожки
Звук тарифицируется по трем схемам:
- Раздельные SKU по типу контента. В Google Cloud для Google Veo 3.1 рендер видео со звуком (Video + Audio) стоит $0.40 за запуск в разрешениях 720p/1080p, а видеоряд без аудио — $0.20.
- Наценка за секунду аудио. В API Kling 3.0 звук увеличивает посекундную ставку: на тарифе
stdгенерация без звука стоит $0.0875 за секунду, а со звуком — $0.125 за секунду. - Встроенная синхронизация. Alibaba Wan 2.7 создает дорожку с липсинком сразу при инференсе.
Если на постпродакшене на видео накладывается голос диктора или музыка, переплачивать за генерацию шумов в нейросети бессмысленно.
Сравнение актуальных моделей
Параметры и ставки в каталоге на ноябрь 2026 года:
| Модель | Ввод | Длительность | Разрешения | Тариф altrouter (USD) | Особенности |
|---|---|---|---|---|---|
| Hailuo 2.3 | Текст, фото | 6 или 10 с | 768P, 1080P | $0.0375 / с (768P)<br>$0.06255 / с (1080P) | Реалистичная мимика и плавность движений человека |
| Kling 2.6 | Текст, фото | 5 или 10 с | — | $0.06875 / с (без аудио)<br>$0.1375 / с (с аудио) | Пайплайн для вертикальных соцсетей |
| Kling 3.0 | Текст, фото | 3–15 с | std, pro, 4K | от $0.0875 / с (std)<br>до $0.41875 / с (4K) | Многокадровая съемка (Multi-shot), поддержка 4K |
| Wan 2.7 Video | Текст, 1-й/посл. кадр | 2–15 с | 720p, 1080p | $0.092 / с (720p)<br>$0.138 / с (1080p) | Переходы между кадрами, поддержка seed |
| Seedance 2.0 | Текст, фото, видео | 4–15 с | 480p, 720p, 1080p | $0.114 / с (480p)<br>$0.246 / с (720p) | Устойчивая геометрия сцены, соотношения до 21:9 |
| Seedance 2.5 | Текст, мультиреф. | до 30 с | 480p, 720p, 1080p | $0.175 / с (480p)<br>$0.39375 / с (720p) | Непрерывные дубли до 30 секунд, удержание героев |
| Veo 3.1 Fast | Текст, фото | 4, 6, 8 с | 720p, 1080p | $0.65 / видео (720p)<br>$0.78 / видео (1080p) | Кинематографичный свет, фиксированная ставка за ролик |
Анализ затрат при больших объемах генерации — в обзоре тарифов на видеомодели.
Сценарии применения
Короткие видео для Reels, Shorts и TikTok
Для коротких роликов подходят Kling 2.6 и Kling 3.0 в стандартном разрешении. Обе модели держат соотношение сторон 9:16, добавляют звуковые эффекты и обеспечивают низкую себестоимость секунды. Если нужно протестировать гипотезы и сделать десятки вариантов креативов для посева, Kling 2.6 обойдется дешевле флагманов.
Оживление персонажей, портретов и каталогов одежды
Анатомию человека точнее всего передает Hailuo 2.3. Модель воспроизводит моргание, улыбку, повороты головы и движение волос без размытия кожи. При стоимости $0.0375 за секунду в 768P (по официальному прайсу MiniMax базовый запуск стоит $0.28 за 6-секундный ролик) это практичный вариант для аватаров и предметных фото.
Рекламные шоты со строгой геометрией перехода
Для сквозного сюжета подходит Wan 2.7 Video. В режиме First-to-Last Frame нейросеть принимает начальный и финальный кадры сцены и рассчитывает морфинг между ними. Для локальной работы веса моделей семейства Wan2.1 запускаются на собственных GPU через ComfyUI.
Кинематографичные рекламные планы
Для проектов со сложным светом, глубиной резкости и имитацией кинооптики подходит линейка Google Veo 3.1. В версии veo-3.1-fast оплата идет за ролик целиком (от $0.65 за 720p до $0.78 за 1080p). Поэтому выгоднее заказывать предельный отрезок в 8 секунд и убирать лишнее на монтаже.
Архитектура интеграции через асинхронный API
Видеогенерация требует больших вычислительных мощностей: обработка запроса длится от 30 секунд до 3–4 минут. Синхронные HTTP-соединения при таком ожидании закрываются по таймауту.
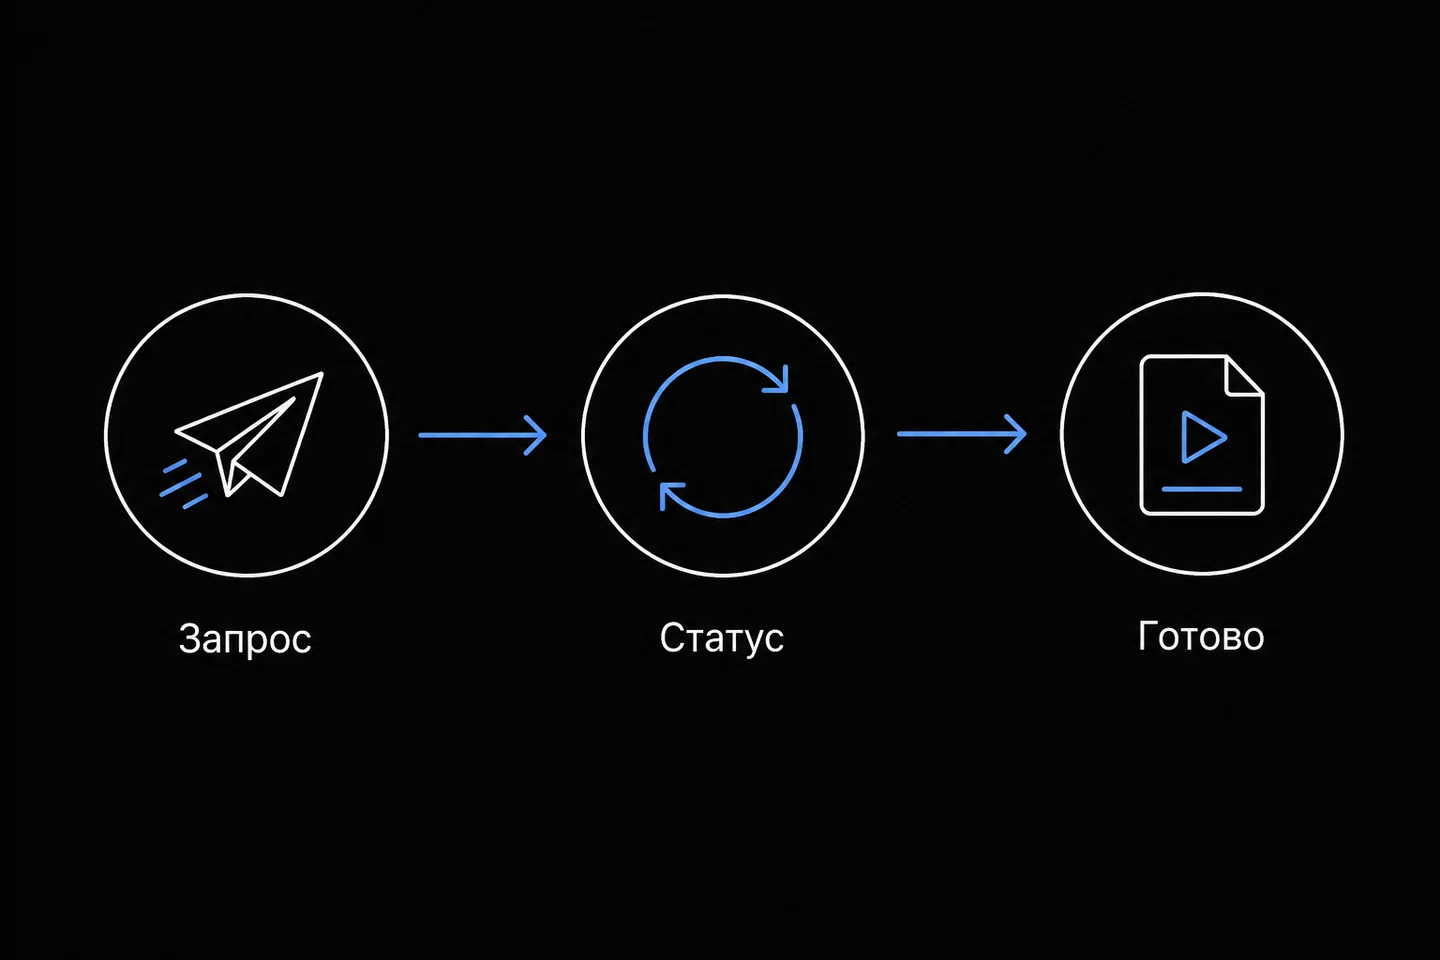
Схема работы:
- Отправить параметры генерации в
POST /videosи получить идентификатор задачиid. - Опрашивать статус задачи через
GET /videos/{id}с паузой 3–5 секунд до статусаcompletedилиfailed. - Скачать готовый MP4-файл в свое постоянное S3-хранилище: временные ссылки провайдеров быстро сгорают.
Пример скрипта на Python для API altrouter:
import time
import requests

API_KEY = "ar-test-key-video-render"
BASE_URL = "https://api.altrouter.ai/v1"
HEADERS = {
    "Authorization": f"Bearer {API_KEY}",
    "Content-Type": "application/json"
}

def render_clip(prompt: str, model: str = "kling-2.6", seconds: int = 5) -> str:
    payload = {
        "model": model,
        "prompt": prompt,
        "seconds": seconds
    }

    # 1. Постановка задачи в очередь
    response = requests.post(f"{BASE_URL}/videos", headers=HEADERS, json=payload)
    response.raise_for_status()
    job = response.json()
    task_id = job["id"]
    print(f"Задача создана: {task_id}, начальный статус: {job.get('status')}")

    # 2. Опрос статуса задачи
    while True:
        status_res = requests.get(f"{BASE_URL}/videos/{task_id}", headers=HEADERS)
        status_res.raise_for_status()
        data = status_res.json()
        status = data.get("status")

        if status == "completed":
            print(f"Рендер завершен. Списано: ${data.get('cost', 0):.4f}")
            return data.get("url")
        elif status == "failed":
            error_details = data.get("error", {})
            raise RuntimeError(f"Сбой рендера: {error_details.get('message', 'Unknown error')}")

        time.sleep(5)

if __name__ == "__main__":
    video_url = render_clip(
        prompt="Медленный пролет камеры над неоновым мегаполисом будущего, туман и отражения в лужах",
        model="kling-2.6",
        seconds=5
    )
    print("Ссылка на видео:", video_url)
🔴 Особенности баланса: при вызове POST /videos система холдирует максимальную стоимость генерации для выбранного хронометража. Списание происходит только при успехе: точная сумма указана в поле cost объекта ответа. Если генерация завершается ошибкой, зарезервированные средства возвращаются на баланс.
Технические ограничения видеомоделей
- Деформация пальцев и контакт с мелкими объектами. Взаимодействие рук с мелкими предметами (печать на клавиатуре, завязывание шнурков, сборка пазлов) — слабое место диффузионных трансформеров.
- Динамический текст. Вывески, логотипы и надписи на одежде искажаются при движении камеры. Титры и графику проще накладывать на монтаже.
- Дрейф геометрии при длинном промпте. Описание цепочки действий («человек заходит в кафе, заказывает чай, достает книгу и читает») в одном промпте приводит к сбою: модель смешивает фазы в один жест. Надежнее делить сценарий на отдельные короткие шоты.
Все семь моделей с текущими ценами доступны на витрине: на пробу хватит $1, которые начисляются за подтверждённый Telegram.
FAQ
Какая нейросеть лучше всего анимирует статичные фотографии?
Для анимации людей подходит Hailuo 2.3: модель сохраняет черты лица, передает мимику и не искажает анатомию глаз. Для графики и пейзажей подходят Kling 2.6 и Wan 2.7 Video.
Подробнее: Hailuo 2.3: цены и параметры.
Сколько секунд видео можно сгенерировать за один вызов API?
Hailuo 2.3, Kling 2.6 и Veo 3.1 генерируют клипы от 4 до 10 секунд. Wan 2.7 и Kling 3.0 создают ролики до 15 секунд, а ByteDance Seedance 2.5 — до 30 секунд.
Подробнее: Hailuo 2.3: цены и параметры.
В чем разница между тарификацией за секунду и за ролик?
В посекундных моделях (Kling, Wan, Seedance, Hailuo) итоговая цена пропорциональна длительности клипа: 5 секунд стоят вдвое дешевле 10 секунд. При фиксированной тарификации (Google Veo 3.1) ставка берется за запуск целиком, поэтому выгоднее сразу указывать максимальную длину — 8 секунд.
Подробнее: Veo 3.1: цены и параметры.
Можно ли получить идентичное видео при повторном запуске?
Видеомодели стохастичны: один и тот же текстовый промпт дает разные результаты. Воспроизводимость повышают опорный кадр (Image-to-Video) и фиксация случайного зерна (seed), если модель поддерживает этот параметр (как в Wan 2.7).
Подробнее: Wan 2.7: цены и параметры.
Зачем скачивать видео на свой сервер, если есть готовая ссылка из API?
Ссылки в ответе API временные: провайдеры удаляют их через некоторое время. Если ролик нужен в интерфейсе или базе данных, сразу после рендера сохраните его в постоянный S3-бакет.
Подробнее: Хранение данных.