Попытка опереться на одну универсальную модель в продакшене приводит к двум проблемам: бизнес либо переплачивает тысячи долларов за простую классификацию текстов флагманом, либо лёгкая модель ломает логику на нестандартном запросе. Ни один вендор не предлагает решение, одинаково эффективное и для массового парсинга, и для многоэтапного аудита кода.
Нагрузку распределяют с помощью трёх схем: статического роутинга по типам задач, каскадной эскалации сложных случаев и межпровайдерного фолбэка.
Шаг 0: внутренняя оптимизация через параметр effort
Прежде чем вводить в пайплайн вторую модель и усложнять зависимости, проверьте управление вычислениями внутри используемой нейросети.
В моделях с адаптивными цепочками рассуждений Anthropic выделила параметр effort (документация Anthropic по выбору моделей). Настройка effort сокращает количество reasoning-токенов на простых сценариях без переключения эндпоинта. Если флагман выдаёт длинные рассуждения там, где нужен короткий ответ, уменьшение effort сократит и задержку (latency), и итоговую сумму расходов на токены.
Когда калибровки effort недостаточно из-за базовой цены токенов, подключают внешнюю маршрутизацию.
Схема 1: маршрут по типу задачи (Task-Based Routing)
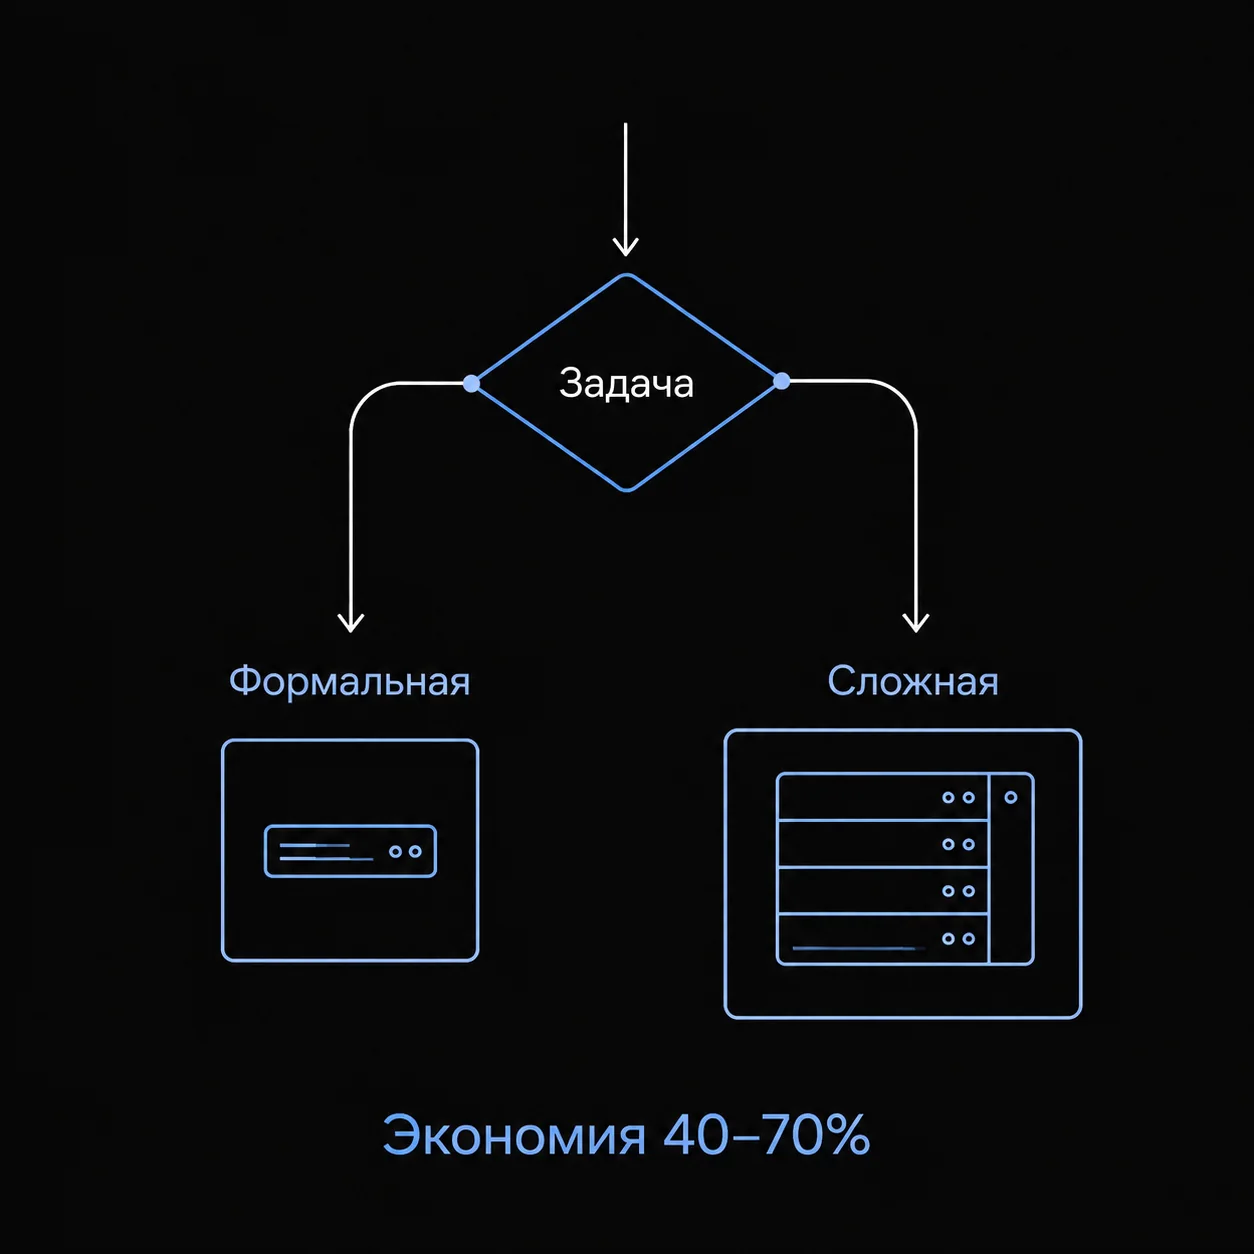
Разница между классами моделей неравномерна. На шаблонных операциях — парсинге неструктурированного текста, валидации полей, сортировке обращений, нормализации адресов — лёгкие модели работают с той же точностью, что и флагманы. Здесь требуется соблюдение синтаксиса, а не глубокие рассуждения.
В исследовательских задачах — проектировании архитектуры, пошаговом анализе инцидентов, агентных циклах вызова инструментов (tool calling) — разрыв между уровнями моделей ощутим. Экономия на таких сценариях приводит к галлюцинациям и повторным вызовам.
Инженерный принцип прост: чем формальнее задача, тем легче модель.
По официальной спецификации линейки Claude ряд моделей делится на четыре эшелона с контекстным окном в 1 миллион токенов:
- Claude Haiku 5.5 (
claude-haiku-5-5): базовая модель для поточной обработки данных, извлечения сущностей и быстрой сортировки по тарифам от $0.10 за вход и $0.50 за выход на 1 млн токенов. - Claude Sonnet 5.5 (
claude-sonnet-5.5): рабочая модель для пользовательских диалогов, написания кода и работы со сложным контекстом ($2 вход / $10 выход за 1M токенов). - Claude Opus 5.5 (
claude-opus-5.5): модель глубокого анализа, синтеза противоречивых требований и архитектурных аудитов ($4 вход / $20 выход за 1M токенов). - Claude Fable 5.1 (
claude-fable-5-1): флагман для комплексного моделирования и тонкой работы со стилем ($10 вход / $50 выход за 1M токенов).
У OpenAI схожую градацию закрывают модели GPT-6 Sol и Luna с ценой $2/$10 и $0.10/$0.50 за 1M токенов соответственно.
В коде разделение по типам задач задают через диспетчер маршрутов:
from openai import OpenAI

client = OpenAI(
    api_key="ar-backend-token-live",
    base_url="https://api.altrouter.ai/v1"
)

TASK_ROUTING = {
    "classify": "claude-haiku-5.5",   # Формальная сортировка и разметка
    "extract": "gpt-6-luna",          # Извлечение JSON по заданной схеме
    "dialog": "claude-sonnet-5.5",    # Пользовательские чаты и поддержка
    "deep_code": "claude-opus-5.5",   # Аудит безопасности и системный анализ
    "creative": "claude-fable-5.1"    # Сложная редакторская работа
}

def dispatch_task(task_type: str, messages: list, **kwargs):
    model_id = TASK_ROUTING.get(task_type, "claude-sonnet-5.5")
    return client.chat.completions.create(
        model=model_id,
        messages=messages,
        **kwargs
    )
Anthropic выделяет две стратегии внедрения:
- Efficiency-first: разработка начинается на лёгкой
claude-haiku-5-5, а модель меняют на старшую только в тех изолированных модулях, где тесты фиксируют падение метрик качества. - Capability-first: прототип собирают на
claude-opus-5.5для проверки реализуемости, после чего отлаженные промпты переносят на младшие модели.
Схема 2: каскадная эскалация (Cascade Routing)
Маршрутизация по типу задачи не работает, если поток запросов в рамках одной категории неоднороден. Например, в технической поддержке: 80% тикетов — типовые вопросы по тарифам и восстановлению пароля, а 20% — неочевидные баги интеграции с внешними API.
В каскаде лёгкая модель обрабатывает 100% входящего потока. Если результат не проходит проверку надёжности, система автоматически передаёт запрос старшей модели.
Расчёт экономики каскада
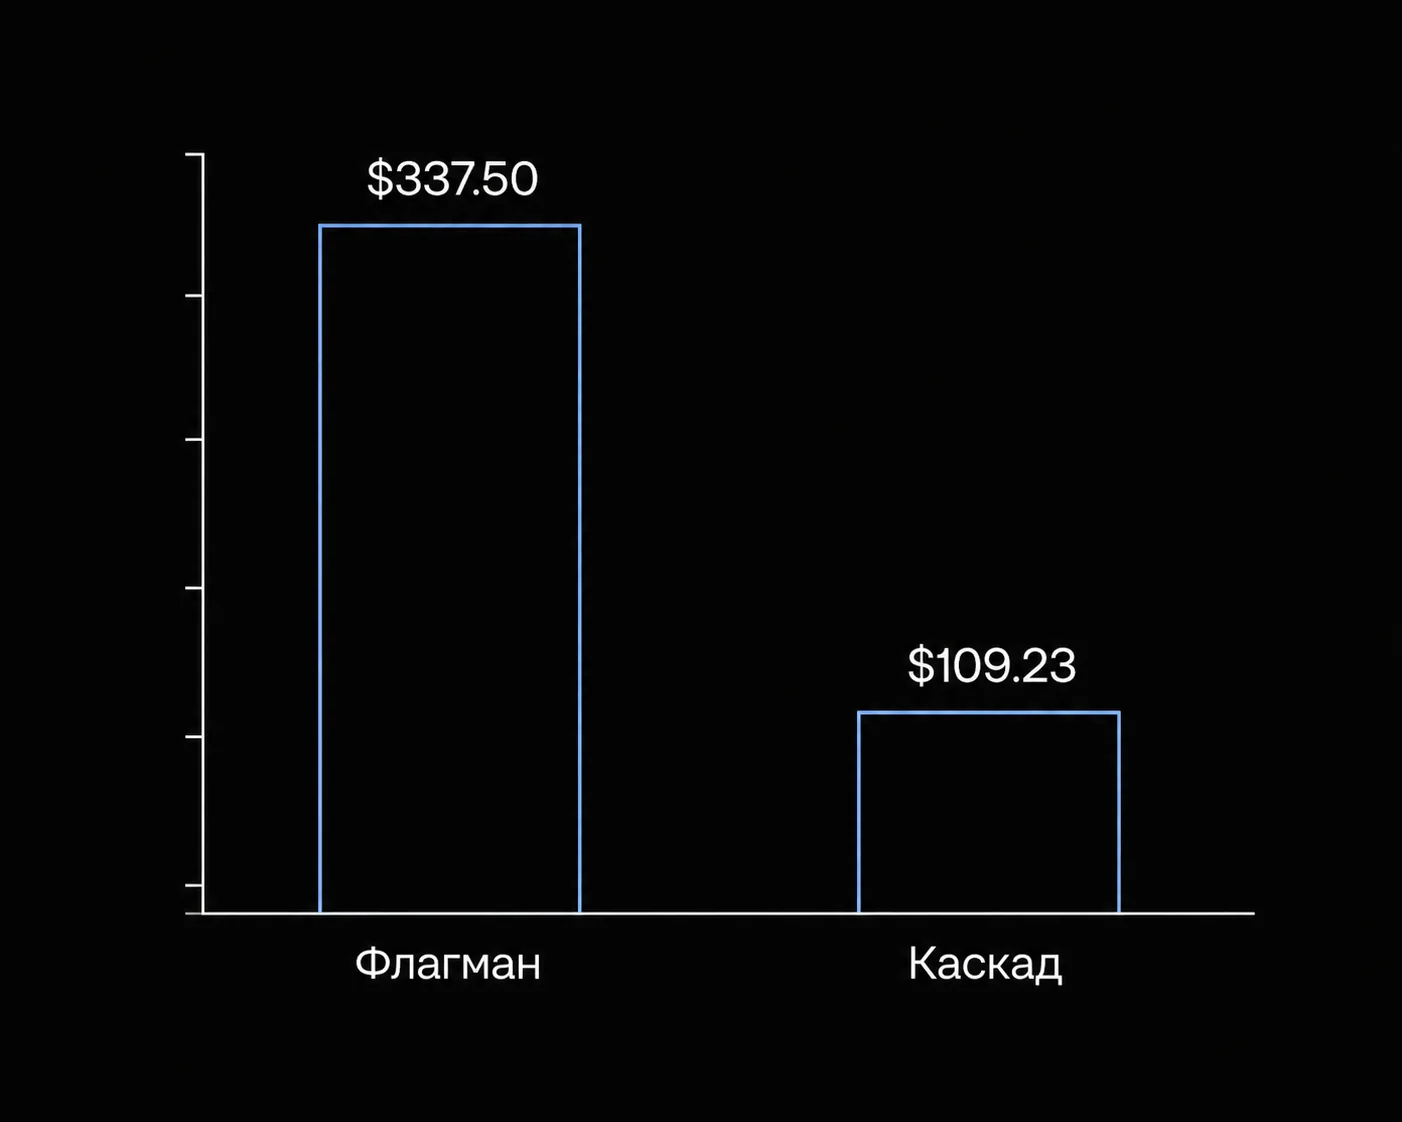
Сравним расходы на обработку 100 000 обращений со средним размером в 500 входных и 50 выходных токенов. Общий объем потока: 50 млн токенов на входе и 5 млн токенов на выходе.
По официальным прайсам вендоров на 2026-11-02:
- Claude Haiku 5.5: $0.10 за 1M входных / $0.50 за 1M выходных токенов.
- Claude Opus 5.5: $4.00 за 1M входных / $20.00 за 1M выходных токенов.
Расчёт затрат:
- 100% на Claude Opus 5.5: $$50 \times $4.00 + 5 \times $20.00 = $200.00 + $100.00 = $300.00$$
- 100% на Claude Haiku 5.5: $$50 \times $0.10 + 5 \times $0.50 = $5.00 + $2.50 = $7.50$$
- Каскад (Haiku 5.5 на 100% + Opus 5.5 на 15% сложных случаев):
- Первый проход всех 100 000 запросов через Haiku 5.5: $7.50.
- Второй проход 15 000 обращений (7.5 млн входных и 0.75 млн выходных токенов) через Opus 5.5: $$7.5 \times $4.00 + 0.75 \times $20.00 = $30.00 + $15.00 = $45.00$$
- Итоговый чек каскада: $$7.50 + $45.00 = \mathbf{$52.50}$.
Каскад сокращает расходы на 82.5% относительно постоянного использования флагмана ($52.50 против $300.00), сохраняя точность на сложных 15% потока. В каталоге altrouter тарифы на эти модели составляют $0.085/$0.425 для claude-haiku-5.5 и $3.399994/$16.999966 для claude-opus-5.5, что даёт пропорциональную экономию при списании баланса.
Критерии эскалации
Запрос передаётся на второй уровень по трём критериям:
- Самооценка уверенности (Confidence score): модель возвращает структурированный ответ в JSON с полем
confidenceот 0.0 до 1.0. Если значение ниже порога (например, 0.8), подключается старшая модель. - Валидация схемы: если ответ лёгкой модели не проходит валидацию Pydantic, содержит пустые обязательные поля или неизвестную категорию, запрос передаётся старшей модели.
- Внешняя алгоритмическая верификация: для кода — запуск через linter или unit-тесты, для сущностей — сверка вычлененных данных с регулярными выражениями базы данных.
Порог уверенности калибруют на тестовой выборке из 300–500 размеченных кейсов с шагом 0.05. Это помогает зафиксировать точку перегиба, где прирост точности перестаёт оправдывать рост затрат.
Схема 3: фолбэк и отказоустойчивость
Каскад снижает расходы, а фолбэк защищает сервис от сбоев инфраструктуры провайдеров.
В документации по ошибкам Claude API зафиксированы различия кодов ответов:
- HTTP 429 (
rate_limit_error): превышение лимитов запросов в минуту (RPM) или токенов в минуту (TPM) для конкретного токена (как устроена ошибка 429). - HTTP 529 (
overloaded_error): серверы вендора перегружены общим трафиком. В пиковые часы Anthropic возвращает 529 даже клиентам с доступным балансом. - HTTP 500 (
api_error): внутренний сбой инфраструктуры вендора, требующий экспоненциального отката (backoff).
Для защиты от 529 вендор предлагает выделенный уровень Priority Tier. Но на программном уровне основной страховкой остаётся переключение на резервную модель в коде.
import time
from openai import OpenAI, APIStatusError

client = OpenAI(
    api_key="ar-backend-token-live",
    base_url="https://api.altrouter.ai/v1"
)

# Цепочка деградации: флагман -> альтернативный вендор -> скоростная замена
FALLBACK_CHAIN = [
    "claude-sonnet-5.5",
    "gpt-6-sol",
    "claude-haiku-5.5"
]

def ask_with_fallback(messages: list, **kwargs):
    last_error = None
    for model_id in FALLBACK_CHAIN:
        try:
            return client.chat.completions.create(
                model=model_id,
                messages=messages,
                **kwargs
            )
        except APIStatusError as err:
            last_error = err
            # Перехват исчерпания квот (429), сбоев бэкенда (500) и перегрузки (529)
            if err.status_code in (429, 500, 529):
                time.sleep(0.5)
                continue
            raise err
    raise RuntimeError(f"Все эшелоны недоступны. Последняя ошибка: {last_error}")
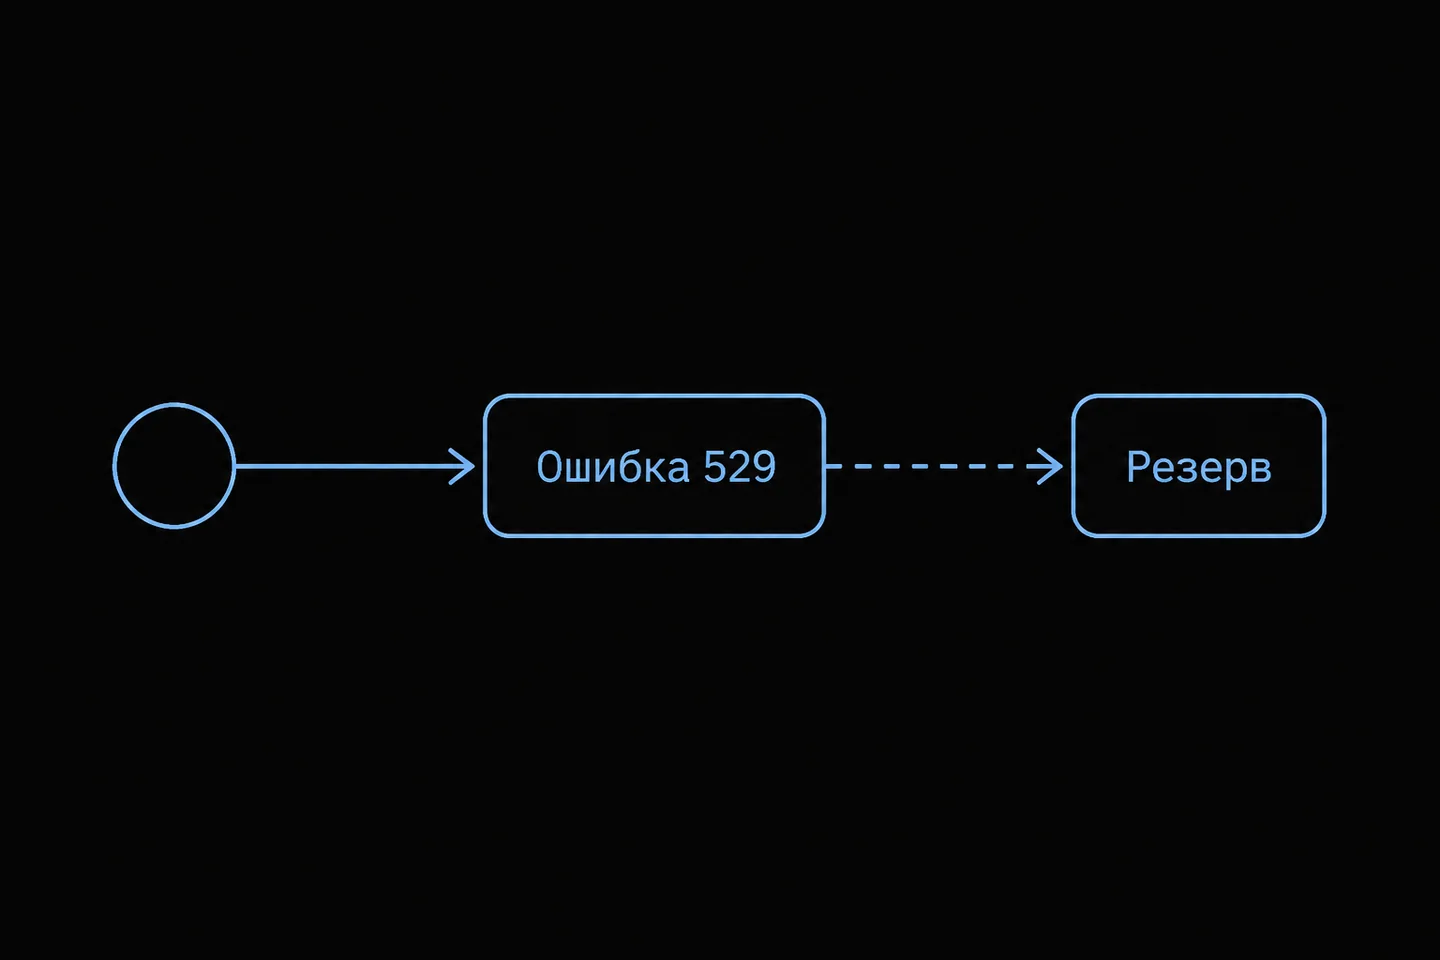
🔴 Ограничение резервирования по бюджету: Модели в цепочке фолбэка могут различаться по тарификации. Если основной трафик шел на claude-sonnet-5.5 по $2/$10, а резервом выставлена тяжелая модель без ограничения токенов, непредвиденный сбой вендора в течение нескольких часов способен кратно увеличить операционный чек.
Что ломается на практике
Маршрутизация усложняет архитектуру и добавляет технические риски.
Ошибки HTTP 400 из-за параметров сэмплирования
В reasoning-моделях (начиная с Claude 4.7) вендоры блокируют кастомные параметры генерации (спецификация ошибок API). Если универсальная функция ask() отправляет temperature: 0.7, top_p или top_k к модели с активным блоком рассуждений, API вернёт HTTP 400 Bad Request.
В разнородных цепочках параметры сэмплирования очищают перед вызовом reasoning-моделей.
Непереносимость системных промптов
Инструкция, отлаженная под Claude, при фолбэке на GPT или Gemini может сбоить. Разные семейства моделей неодинаково строго соблюдают формат: одна модель отдаст чистый структурированный ответ, а другая добавит вводный текст. Схему вывода необходимо проверять на каждом звене цепочки.
Дрейф распределения сложности
При расчёте каскада закладывают долю сложных запросов (например, 15%). Сезонность, релиз новой версии интерфейса или спам-трафик могут поднять долю эскалаций до 40–50%. Без мониторинга логов и расхода токенов (руководство по учету расходов) расходы быстро превысят плановые.
Проблема зоопарка моделей
Поддержка пяти и более моделей в одном бэкенде усложняет интеграционные тесты. Для большинства продуктов достаточно двух или трёх моделей. Каждое дополнительное звено требует подтверждения замерами качества и окупаемости.
FAQ
С какого набора моделей безопаснее всего начинать маршрутизацию?
Начните со связки двух моделей одного семейства: быстрой рабочей (claude-haiku-5.5) и флагманской (claude-sonnet-5.5 или claude-opus-5.5). Это исключит расхождения в синтаксисе промптов и упростит калибровку каскада.
Подробнее: Claude Haiku 5.5: цены и параметры.
Как кеширование промптов влияет на экономику каскада?
В Claude базовые множители тарификации кеша составляют 1.25x за запись с 5-минутным TTL и дают скидку 90% (множитель 0.1x) при чтении. Если системный промпт занимает несколько тысяч токенов, кеширование снижает стоимость повторных вызовов на обоих шагах каскада.
Почему нельзя использовать фолбэк внутри одной модели?
Шлюз может автоматически перенаправить запрос на резервный узел внутри той же модели при локальном отказе. Но при масштабной недоступности серверов вендора спасает только переход на независимую модель альтернативного провайдера.
Подробнее: Надёжность и резервные маршруты.
Как отслеживать реальную стоимость вызовов при динамическом роутинге?
Фактический объём использованных токенов возвращается в объекте usage каждого ответа API. Полагаться только на предварительные калькуляторы в продакшене нельзя: объём выходных токенов меняется, а reasoning-модели тратят скрытые токены на внутренние размышления. Итоговые списания отслеживают через регулярный аудит системных логов API.
Подробнее: Каталог моделей и цены.