Когда десктопный клиент или конструктор ботов не сохраняет API-ключ либо чат-бот на пятой реплике забывает контекст, сбой шлюза ни при чём. Чаще всего дело в значениях по умолчанию: программы сами дописывают пути к эндпоинтам, урезают окно контекста до устаревших лимитов или блокируют вызов внешних функций.
Общие правила интеграции сторонних ключей описаны в статье про свой ключ в редакторах кода. Ниже разобран пошаговый ввод параметров для десктопного пространства Cherry Studio и no-code платформы Dify.
Cherry Studio: базовый URL и отбор моделей
Десктопный клиент Cherry Studio вырос из простого интерфейса диалогов в рабочее пространство с поддержкой Model Context Protocol (MCP) и автономных агентов. В сборке Cherry Studio v2.1.10 настройка сторонних провайдеров находится в меню Настройки → Сервисы моделей → + Добавить.
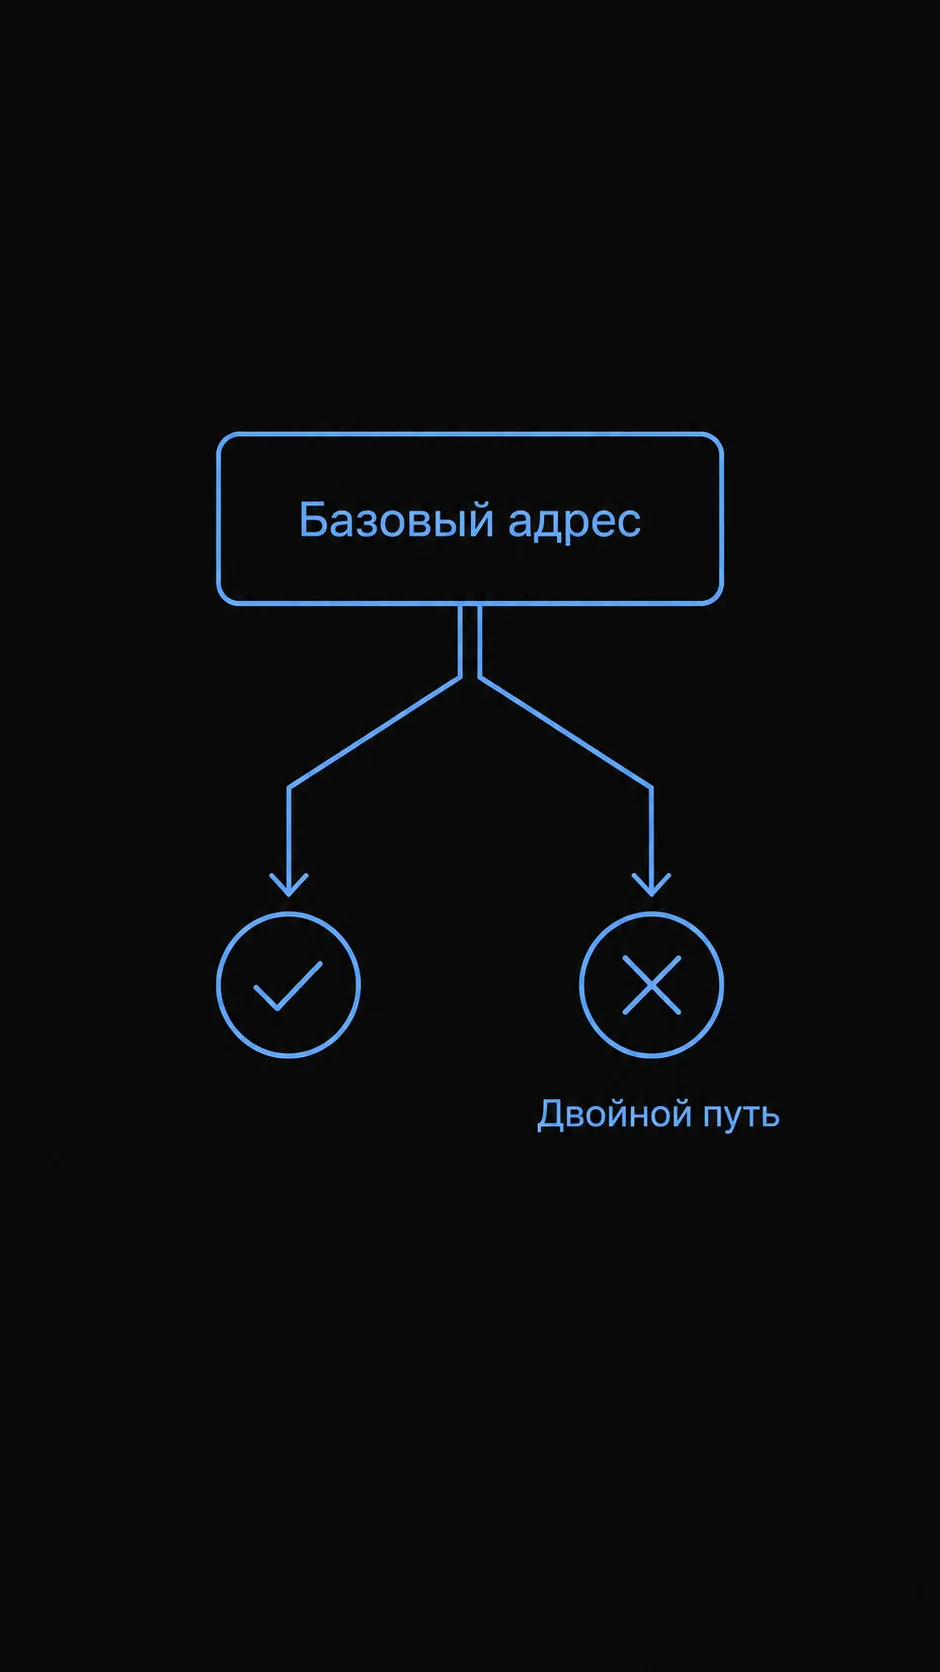
Главная ошибка при заполнении формы — указание полного пути к обработчику сообщений.
Неправильно: https://api.altrouter.ai/v1/chat/completions
Правильно:   https://api.altrouter.ai/v1
Клиент сам добавляет суффикс /chat/completions к указанному адресу. Полный путь сформирует некорректный запрос вида /v1/chat/completions/chat/completions, который вернёт код 404. Подходят два варианта базового URL: https://api.altrouter.ai и https://api.altrouter.ai/v1 — повторный префикс версии клиент не дублирует.
Поле API-ключ принимает токены формата ar-....
После ввода адреса и ключа кнопка Получить список моделей запрашивает ручку GET /v1/models. Шлюз возвращает полный перечень моделей, куда входят текстовые LLM, генераторы картинок и модели синтеза видео. Добавляйте в список активных чатов через плюс только текстовые модели: отправка текстового сообщения в модель генерации медиа вернёт ошибку 404, так как обработчик чата не работает с визуализацией.
Для запуска провайдера включите тумблер в правом верхнем углу карточки сервиса. Без этого подключённые модели не появятся в списке диалогового окна. Кнопка Проверить отправляет валидационный запрос и подтверждает связь.
Настройка Dify: скрытый лимит контекста и вызов инструментов
В платформе Dify 1.18.0 сторонние OpenAI-совместимые шлюзы подключают через официальный плагин langgenius/openai_api_compatible 0.0.73 из встроенного каталога. Настройка доступна администраторам в разделе Integrations → Model Provider.
В отличие от Cherry Studio, этот плагин не запрашивает список моделей автоматически — каждую вносят вручную:
- Model Type — выберите
LLM. - Model Name — точный идентификатор из каталога шлюза (например,
gemini-3.1-flash-lite,gemini-3.5-flashилиgrok-4.3). - API Key — секретный ключ шлюза вида
ar-.... - API Base URL — адрес вида
https://api.altrouter.ai/v1. Плагин сам дописывает путьchat/completions. - Completion mode — выберите режим
Chat. - API Type — выберите
Chat Completions. Поддержка схемы OpenAI Responses API заложена в кодовой базе плагина, но требует ручки/responses. - Upper bound for max tokens — по умолчанию стоит 4096. Этот параметр задаёт жёсткий потолок генерации одного ответа.
Критически важная настройка — поле Model context size. По умолчанию в схеме openai_api_compatible.yaml прописан лимит в 4096 токенов.
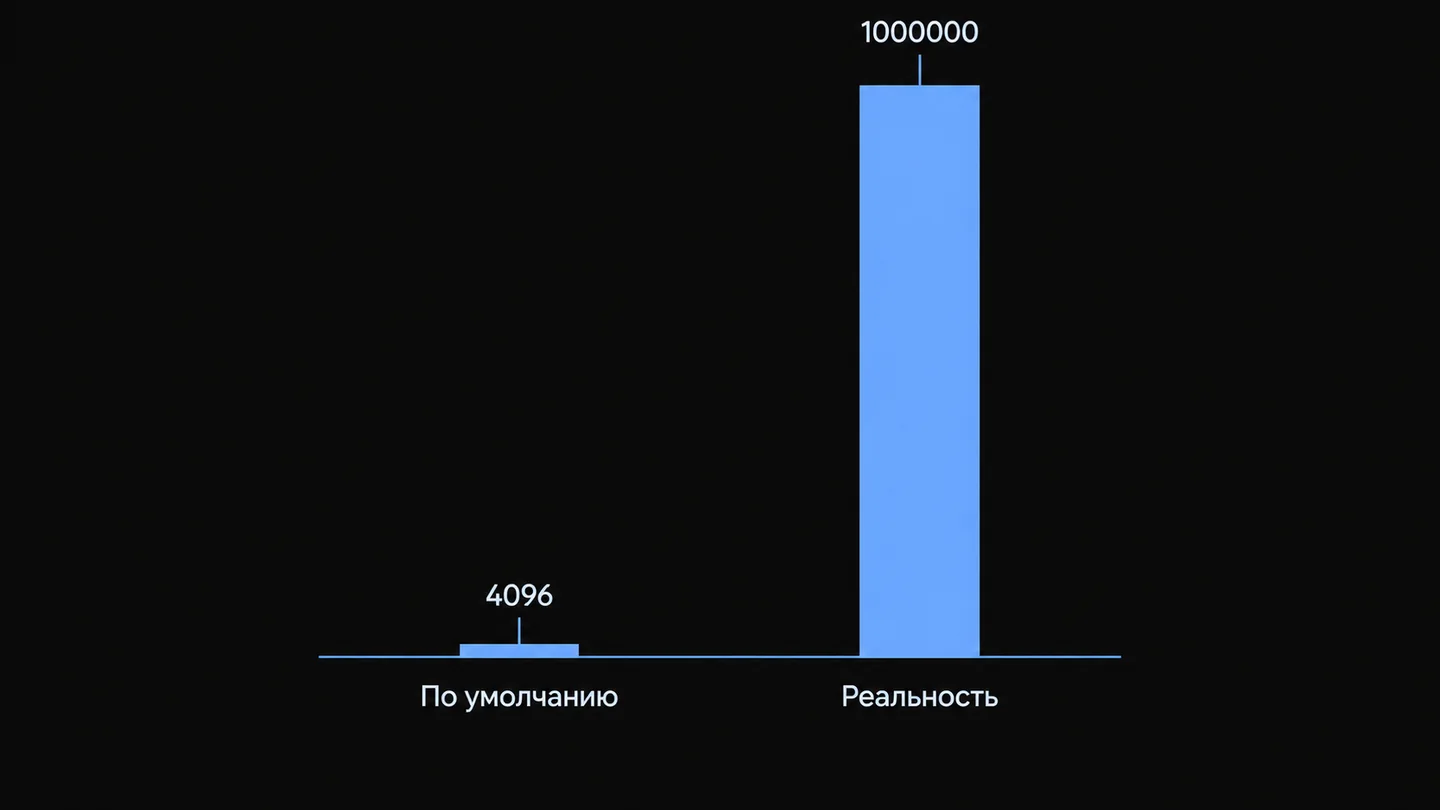
Dify не опрашивает модель о поддерживаемом окне внимания, а опирается только на число из этого поля. Если оставить дефолтные 4096, платформа обрежет историю диалога и системные промпты до 4 Кб, проигнорировав реальные возможности модели. Для gemini-3.1-flash-lite и gemini-3.5-flash впишите 1000000, а для grok-4.3 — 256000.
Второй скрытый барьер связан с параметром Function Call Type. По умолчанию плагин оставляет его в положении Not Support. В этом режиме Dify вырезает из запроса блок описания внешних функций, лишая агента запуска скриптов и веб-поиска. Для сценариев с вызовами функций переключите поле в режим Tool Call.
Механика валидации: как клиенты проверяют соединение
При сохранении формы плагин Dify не просто записывает параметры в базу данных, а проверяет шлюз на совместимость. Клиент отправляет на указанный базовый адрес короткий ping-запрос:
{
  "model": "gemini-3.1-flash-lite",
  "messages": [
    {
      "role": "user",
      "content": "ping"
    }
  ],
  "max_tokens": 5,
  "stream": false
}
Для reasoning-моделей линеек o1, o3 или gpt-5 плагин автоматически подменяет ключ max_tokens на max_completion_tokens. Сохранение формы пройдёт успешно, только если сервер вернул HTTP-статус 200 и валидный JSON с объектом типа chat.completion. Если в имени модели опечатка или шлюз заблокировал запрос, Dify прервёт операцию с общей ошибкой верификации.
Проверка параметров на практике показала различия в обработке вызовов функций. При отправке структуры tools и флага tool_choice:
gemini-3.5-flashиgrok-4.3корректно вернули вызов инструмента с аргументами в формате JSON;gemini-3.1-flash-liteна такой же пейлоад ответила текстом, проигнорировав директиву запуска инструмента.
Поэтому Flash Lite подойдёт для быстрых текстовых ответов, а для автономных рабочих процессов с внешними скриптами нужна модель уровня Gemini 3.5 Flash или Grok 4.3. Структура параметров и аргументов подробно разобрана в руководстве по вызову инструментов.
Базы знаний и RAG: ограничения без эмбеддингов
Использование баз знаний и семантического поиска через сторонний шлюз накладывает технические ограничения, важные при проектировании архитектуры.
Семантический поиск требует векторных представлений (эмбеддингов). На шлюзе altrouter эндпоинт /v1/embeddings не поддерживается и возвращает ошибку 404. Из-за этого:
- База знаний в Cherry Studio не работает на одном ключе. Для векторизации локальных документов в настройках приложения придётся подключить отдельного провайдера с моделью эмбеддингов.
- В Dify доступен только режим Economical. При создании базы знаний Dify предлагает два метода индексации: High Quality (требует векторных эмбеддингов) и Economical. Без ручки
/v1/embeddingsбаза запустится только во втором режиме. Режим Economical извлекает из каждого текстового блока до 10 ключевых слов и ищет совпадения по инвертированному индексу. Точность выдачи здесь ниже, чем у векторного поиска, зато токены на эмбеддинги не тратятся.
Для диалоговых агентов со сложными документами через протокол Anthropic Messages с 27 октября 2026 года работает ручка /v1/messages. Инженерные подходы к таким системам описаны в статье ИИ-агенты своими руками.
Расходы на диалоги и агентов
Тарифы шлюза altrouter зафиксированы на 27.10.2026. Для Gemini 3.1 Flash Lite цена составляет $0,224993 за 1 млн входных и $1,349958 за 1 млн выходных токенов (на 10% ниже тарифов вендора в $0,25 и $1,50). Для Gemini 3.5 Flash тариф равен $1,35 на входе и $8,10 на выходе (на 10% ниже вендорских $1,50 и $9,00). Для Grok 4.3 стоимость составляет $1,0625 на входе и $2,125 на выходе (на 15% ниже цен xAI в $1,25 и $2,50). Расход токенов клиенты отслеживают по стандартной статистике в ответе шлюза, на основе которой рассчитывается стоимость.
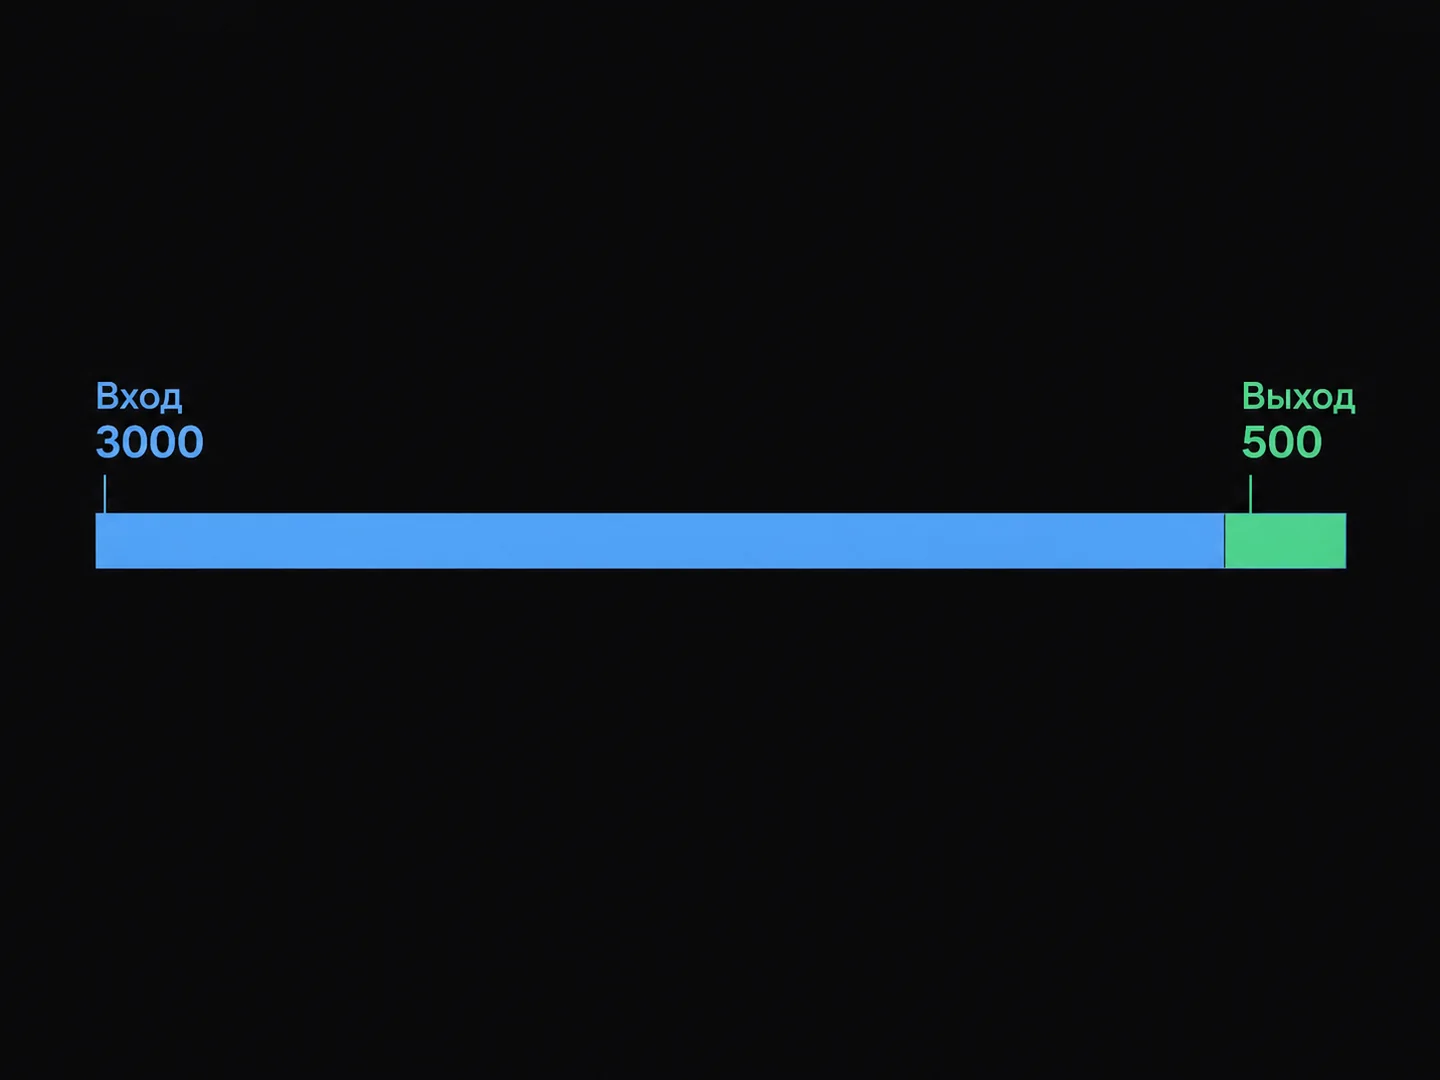
В многошаговых диалогах входящий трафик превышает исходящий в 6–7 раз: модель не хранит состояние сессии, поэтому клиент с каждым новым сообщением заново отправляет системный промпт, релевантные цитаты и весь предыдущий контекст.
Сравним расходы в двух типовых сценариях:
- Сценарий А (персональный чат в Cherry Studio): 40 реплик в день (1200 в месяц). При средней длине запроса с учётом истории в 3000 входных токенов и ответе в 500 токенов суммарный объём за месяц составляет 3,6 млн токенов на входе и 0,6 млн на выходе.
- Сценарий Б (сервисный бот в Dify): 3000 диалоговых шагов в месяц. С учётом системных инструкций и цитат базы знаний каждый шаг требует в среднем 2000 токенов на входе и 300 токенов на выходе. Месячный объём — 6,0 млн входных токенов и 0,9 млн выходных.
| Модель | Сценарий А (Cherry Studio, 3,6M вход / 0,6M выход) | Сценарий Б (Dify, 6,0M вход / 0,9M выход) |
|---|---|---|
| Gemini 3.1 Flash Lite | $1,62 (по официальному прайсу $1,80) | $2,56 (по официальному прайсу $2,85) |
| Grok 4.3 | $5,10 (по официальному прайсу $6,00) | $8,29 (по официальному прайсу $9,75) |
| Gemini 3.5 Flash | $9,72 (по официальному прайсу $10,80) | $15,39 (по официальному прайсу $17,10) |
Расчёт для Gemini 3.1 Flash Lite в сценарии А:
$$3{,}6 \times 0{,}224993 + 0{,}6 \times 1{,}349958 = 0{,}80997 + 0{,}80997 = $1{,}62$$
При пополнении баланса картой РФ, через СБП или криптовалютой депозита в $15 хватит на полтора месяца персонального ассистента на Gemini 3.5 Flash, а бота поддержки на Flash Lite — почти на полгода работы.
FAQ
Какой адрес API вписывать в Cherry Studio?
Используйте https://api.altrouter.ai или https://api.altrouter.ai/v1. Клиент сам добавляет суффикс /chat/completions. Полный путь до конечной ручки приведёт к задвоению адреса.
Подробнее: API нейросетей: один ключ ко всем моделям.
Почему Dify выдаёт ошибку проверки при добавлении модели?
При верификации Dify шлёт на базовый адрес пробный запрос со строкой ping и лимитом ответа в 5 токенов, ожидая код 200 и объект chat.completion. Проверьте, чтобы в поле API Base URL был указан адрес https://api.altrouter.ai/v1 без хвоста chat/completions, а имя модели в поле Model Name в точности повторяло идентификатор из каталога.
Подробнее: Коды ошибок API.
Почему подключённые модели не видны в чате Cherry Studio?
Убедитесь, что после опроса шлюза вы нажали плюс напротив нужных моделей, перенеся их в активный список. Также проверьте переключатель активации сервиса в правом верхнем углу карточки провайдера: пока он выключен, модели скрыты из окна переписки.
Подробнее: API-ключи и авторизация.
Какой размер контекста указывать в форме Dify?
В поле Model context size вручную впишите реальное окно модели вместо 4096 по умолчанию. Для Gemini 3.1 Flash Lite и Gemini 3.5 Flash укажите 1000000, а для Grok 4.3 — 256000. Если оставить 4096, Dify принудительно обрежет историю сообщений.
Подробнее: Gemini 3.1 Flash Lite: цены и параметры.
Как заставить агента в Dify вызывать внешние инструменты?
Переключите параметр Function Call Type из значения Not Support в положение Tool Call. Убедитесь, что выбранная модель поддерживает вызов функций: Gemini 3.5 Flash и Grok 4.3 обрабатывают аргументы функций, а Gemini 3.1 Flash Lite отвечает на такие запросы простым текстом.
Подробнее: Gemini 3.5 Flash: цены и параметры.