На токенизаторе OpenAI o200k_base русский текст занимает 1,7–2 токена на слово и 3,3–4,2 знака на токен. Тот же смысл по-английски требует в 1,1–1,4 раза меньше токенов. На старом cl100k_base разница доходила до 2,6 раза, отсюда и живучее правило «русский вдвое дороже». Для Claude и Gemini открытых токенизаторов нет, их счёт узнают только у вендора.
Почему кириллица режется мельче
Токен — кусок текста, за который модель берёт деньги: иногда слово целиком, иногда слог или одна буква. Токенизатор хранит словарь таких кусков, собранный на обучающих текстах. Частые сочетания попадают в словарь целиком, редкие собираются из обрывков. Английского в текстах, на которых собирают словарь, обычно больше, поэтому английские слова чаще лежат в нём целиком.
Мы прогнали несколько слов через три токенизатора: cl100k_base (GPT-4 и GPT-3.5), o200k_base (GPT-4o и GPT-5) и токенизатор DeepSeek V4. Первое число — слово само по себе, второе — слово с пробелом впереди, как оно стоит внутри фразы.
| Слово | cl100k_base | o200k_base | DeepSeek V4 |
|---|---|---|---|
support | 1 / 1 | 1 / 1 | 1 / 1 |
neural | 2 / 1 | 2 / 1 | 2 / 1 |
привет | 4 / 3 | 2 / 1 | 2 / 2 |
нейросеть | 5 / 5 | 3 / 3 | 3 / 3 |
поддержки | 5 / 4 | 3 / 1 | 3 / 2 |
стоимость | 4 / 4 | 2 / 1 | 3 / 1 |
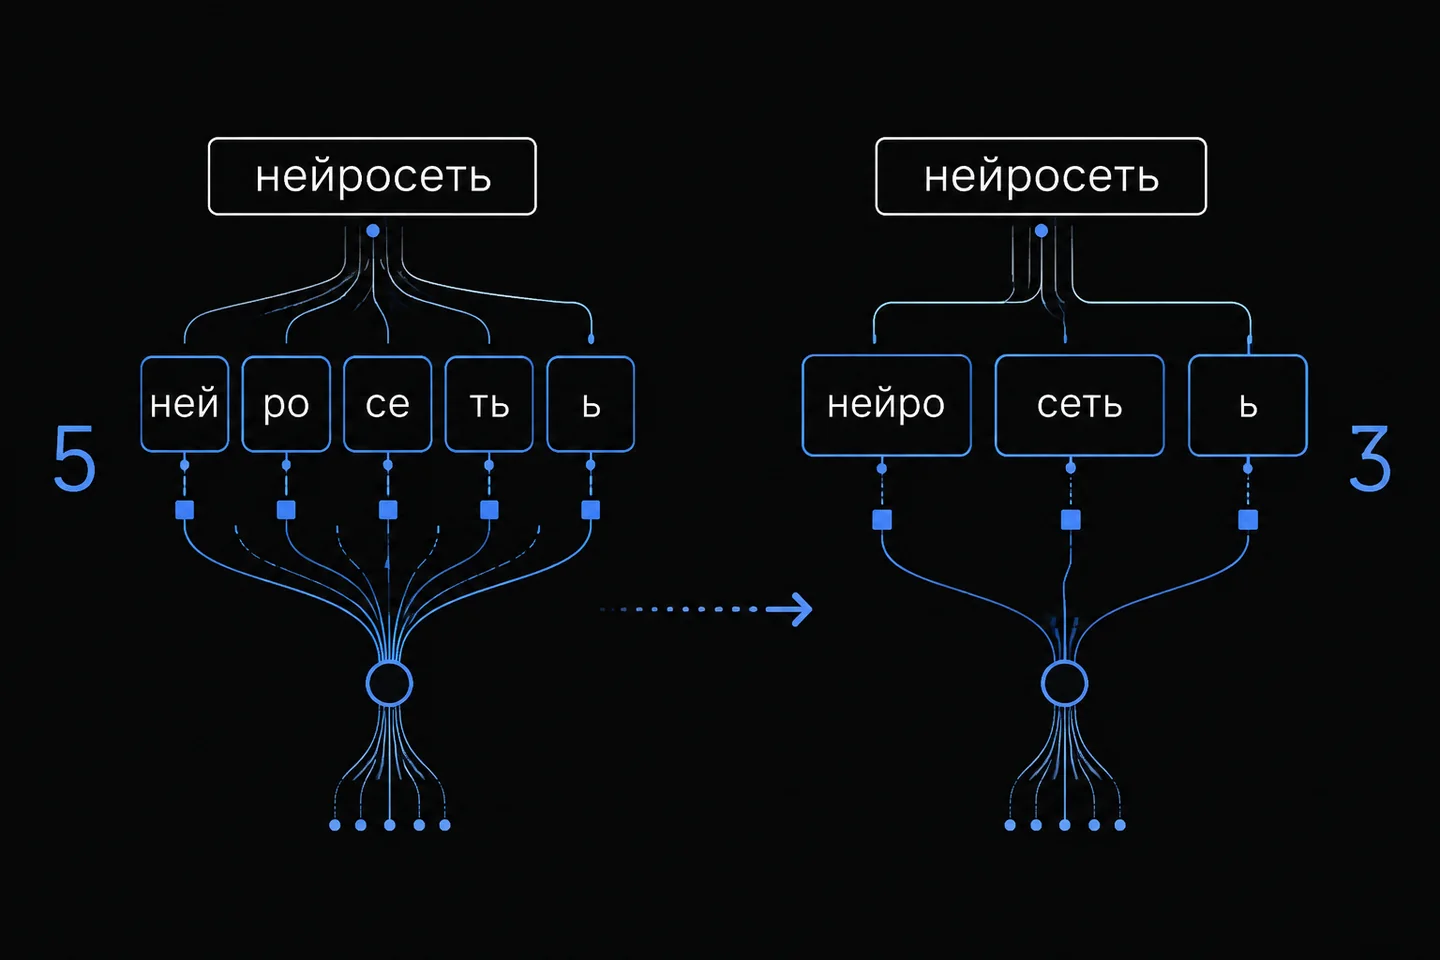
В словаре o200k_base 200 тыс. элементов против 100 тыс. у cl100k_base, и кириллических среди них 14 212 против 736 (наш подсчёт по tiktoken 0.14.0: токены, где есть хотя бы одна кириллическая буква). Частое слово с пробелом впереди («поддержки», «стоимость») там занимает один токен. Поэтому онлайн-демо, где слово вводят без пробела, завышают счёт для обычного текста.
Откуда взялось «вдвое дороже»
23.08.2026 мы сравнили старый и новый токенизаторы OpenAI на четырёх парах фраз, русской и английской об одном и том же (библиотека gpt-tokenizer 4.0.0):
| Токенизатор | Русский | Английский | Отношение |
|---|---|---|---|
cl100k_base (GPT-4, GPT-3.5) | 149 | 74 | 2,01 |
o200k_base (GPT-4o, GPT-5) | 91 | 74 | 1,23 |
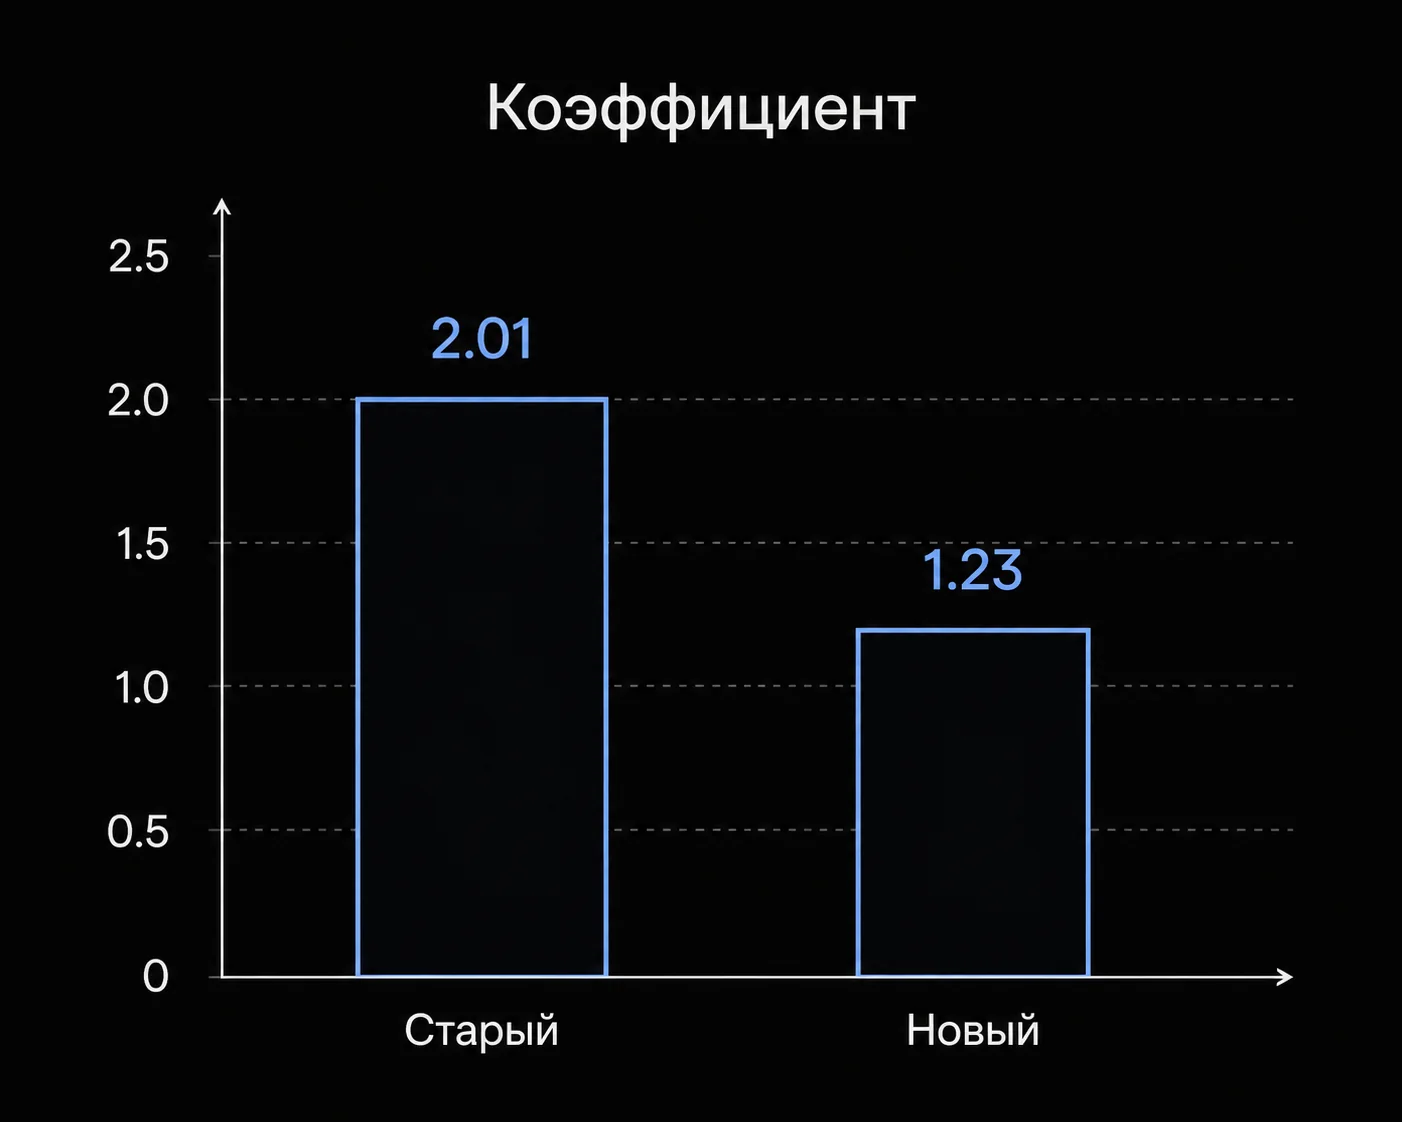
Английский текст на обоих токенизаторах занял одинаково, 74 токена, а русский стал короче в 1,6 раза. Правило «вдвое» верно для моделей на cl100k_base. Для GPT-5 оно завышает счёт.
Четыре пары — маленькая выборка, и сами фразы не сохранились. Поэтому 29.10.2026 мы повторили замер на текстах, которые может проверить любой.
Замер 29 октября: два корпуса, три токенизатора
Тексты:
- Всеобщая декларация прав человека, официальные тексты ООН на русском и английском: преамбула и 30 статей, 11 773 и 10 596 знаков;
- 12 статей нашего блога и их английские переводы: технический текст с названиями моделей, числами и терминами, 104 тыс. знаков на каждом языке, без кода и ссылок.
Инструменты: tiktoken 0.14.0 от OpenAI в изолированном окружении и токенизатор, который DeepSeek выкладывает для офлайн-подсчёта (deepseek_v4_tokenizer.zip, открыт через библиотеку tokenizers 0.23.3). Служебные токены не считали.
| Токенизатор | Декларация: русский / английский | Знаков на токен, рус. | Токенов на слово, рус. | Блог: русский / английский | Знаков на токен, рус. | Токенов на слово, рус. |
|---|---|---|---|---|---|---|
cl100k_base | 2,57 | 2,29 | 3,19 | 1,64 | 2,27 | 2,88 |
o200k_base | 1,40 | 4,18 | 1,74 | 1,14 | 3,33 | 1,97 |
| DeepSeek V4 | 1,55 | 3,82 | 1,91 | 1,24 | 3,00 | 2,18 |
Английский текст на всех трёх токенизаторах занимает почти одинаково: 5,3 знака на токен у декларации и около 4 у блога. Различаются они на русском.
Прикидка «два токена на слово» для o200k_base подтвердилась на техническом тексте: 1,97. Декларация дала 1,74, скорее всего потому, что в ней почти нет чисел, латиницы и разметки, которые дробятся на мелкие токены. «Четыре символа на токен» из англоязычной документации для русского — верхняя граница: у декларации 4,2 знака на токен, у статей блога 3,3.
Почему разница с английским зависит от текста
На o200k_base русский текст декларации длиннее английского в 1,4 раза, статей блога — в 1,14. В технических статьях 2–16% знаков латинские: названия моделей, параметры, base_url. Цифры и английские термины в обоих языках режутся одинаково, и разрыв сокращается. По отдельным статьям отношение гуляет от 0,99 до 1,35, но переводы делались не дословно, поэтому надёжнее суммарная цифра.
Код от языка почти не зависит. Блоки кода из тех же статей, с русскими и английскими комментариями, разошлись на 2% у o200k_base и DeepSeek и на 5% у cl100k_base.
На странице в 1 800 знаков это 430–540 токенов у o200k_base, 470–600 у DeepSeek V4 и около 790 у cl100k_base.
Claude, Gemini, GPT-6 и Grok: что говорят вендоры
Офлайн-токенизатора для этих моделей вендоры не публикуют, поэтому цифры только их собственные.
- Anthropic: Claude 4.7 и новее, включая Fable 5.1, режут текст новым токенизатором, который даёт примерно на 30% больше токенов, чем у прежних моделей, а точная разница зависит от содержимого (прайс Anthropic). Отдельных цифр по русскому нет. Что это меняет при переходе на Sonnet 5, мы разбирали в статье про токенизатор Sonnet 5.
- Google: «токен — это примерно 4 символа, 100 токенов — 60–80 английских слов» (документация Gemini). Это оценка для английского.
- OpenAI: tiktoken 0.14.0 сопоставляет с
o200k_baseмодели GPT-4o, GPT-4.1, o-серии и GPT-5, а для GPT-6 записи в нём нет. OpenAI предупреждает, что офлайн-токенизатор подходит для простого текста и не учитывает особенности конкретной модели (гайд по подсчёту токенов).
Посчитать токены до отправки запроса вендоры разрешают отдельным вызовом: count_tokens у Anthropic (бесплатный, с лимитом запросов в минуту) и у Gemini, POST /v1/responses/input_tokens у OpenAI, POST /v1/tokenize-text у xAI.
Как посчитать токены своего текста
Для моделей OpenAI до GPT-5 включительно и для DeepSeek хватит офлайн-подсчёта (pip install tiktoken tokenizers, токенизатор DeepSeek — из архива с их страницы):
import tiktoken
from tokenizers import Tokenizer

text = open("prompt.txt", encoding="utf-8").read()

openai_enc = tiktoken.get_encoding("o200k_base")
deepseek = Tokenizer.from_file("deepseek_v4_tokenizer/tokenizer.json")

for name, n in [
    ("o200k_base", len(openai_enc.encode(text))),
    ("deepseek_v4", len(deepseek.encode(text, add_special_tokens=False).ids)),
]:
    print(f"{name}: {n} токенов, {len(text) / n:.2f} знака на токен")
Для остальных моделей точное число даёт сам API: поле usage.prompt_tokens в ответе, то есть сколько токенов насчитано на входе. В него входят служебные токены разметки, поэтому из него вычитают «пустой» запрос. Короткий ответ (max_tokens=16) делает такой замер дешёвым:
import os

from openai import OpenAI

client = OpenAI(
    base_url="https://api.altrouter.ai/v1",
    api_key=os.environ["ALTROUTER_API_KEY"],
)


def prompt_tokens(model: str, text: str) -> int:
    r = client.chat.completions.create(
        model=model,
        messages=[{"role": "user", "content": text}],
        max_tokens=16,
    )
    return r.usage.prompt_tokens


text = open("prompt.txt", encoding="utf-8").read()
model = "claude-haiku-5.5"
print(prompt_tokens(model, text) - prompt_tokens(model, "ok"))
Мерьте 50–100 настоящих запросов, а не один абзац: средняя по выборке надёжнее любого множителя из статьи, включая наш.
Сколько это в деньгах
Неверное правило ошибается не в счёте, а в оценке. Возьмём поддержку: 100 000 обращений в месяц, 250 слов на входе и 80 на выходе, модель gpt-5.4-mini по прайсу OpenAI на 29.10.2026 ($0,75 / $4,50 за миллион). Её токенизатор, o200k_base, известен.
| Прикидка | Токенов на обращение | Бюджет в месяц |
|---|---|---|
3 токена на слово, как на cl100k_base | 750 вход + 240 выход | $164,25 |
2 токена на слово, как на o200k_base | 500 вход + 160 выход | $109,50 |
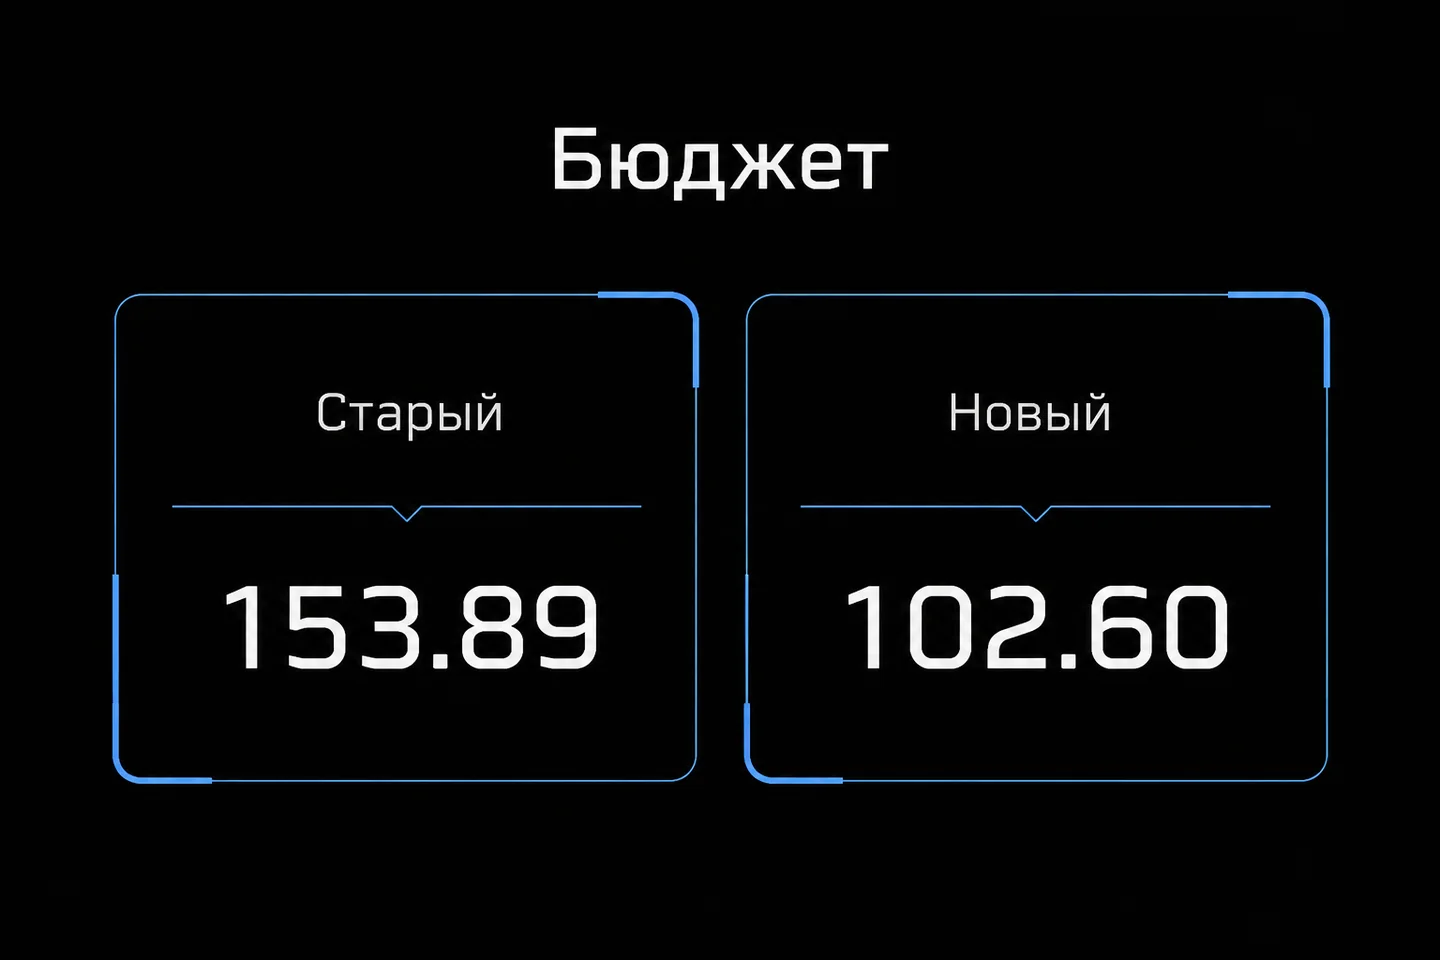
Заплатите вы одинаково, но по старому правилу заложите в полтора раза больше нужного и, возможно, откажетесь от модели, которая на деле проходила по бюджету. С новыми моделями ошибка бывает и обратной: если токенизатор режет русский мельче, прикидка «два токена на слово» занизит счёт. Цены других моделей для такого расчёта собраны в сравнении стоимости API.
Переводить ли промпт на английский
🔴 Разница в 14–40% токенов на o200k_base не повод переводить пользовательские данные на английский. Ответ всё равно нужен на русском, а перевод туда и обратно добавляет и токены, и ошибки.
Смысл есть у длинного системного промпта, который не зависит от языка данных и уходит в каждый запрос. Но и там кэш вендора обычно экономит больше: повторное начало запроса стоит 5–10% цены входа. Как его включить и что ещё режет счёт, мы разбирали в статье как снизить расходы на токены.
FAQ
Сколько токенов в странице текста?
Страница в 1 800 знаков на русском занимает 430–540 токенов у o200k_base (GPT-4o, GPT-5), 470–600 у DeepSeek V4 и около 790 у cl100k_base (GPT-4). Деловой текст ближе к нижней границе, технический с числами и латиницей — к верхней. Для Claude и Gemini посчитайте через count_tokens вендора.
Подробнее: GPT-4o: цены и параметры.
Почему API насчитал больше токенов, чем офлайн-токенизатор?
В запрос, кроме вашего текста, входят служебные токены: роли сообщений, их границы, системный промпт, описания инструментов. OpenAI прямо пишет, что счёт API их включает, а локальный токенизатор нет. Картинки и файлы офлайн вообще не посчитать.
Подробнее: OpenAI API: модели и цены.