Попытка общаться с языковой моделью на естественном языке без явных рамок приводит к водянистым ответам, штампам и выдуманным фактам. Промпт работает предсказуемо, когда построен по принципам технического задания: конкретные входные данные, ограничения на вывод, эталонные примеры и машиночитаемый формат.
Ниже — 14 шаблонов под типовые задачи: от контент-маркетинга и юридического анализа до код-ревью и генерации медиа. Места для подстановки контекста выделены [квадратными скобками]. После шаблонов разобран инженерный каркас: как адаптировать запрос под свои требования, выстроить пайплайн и какие параметры API влияют на результат.
Шаблоны для текстов и маркетинга
1. Пост для блога или Telegram-канала
Напиши пост для [Telegram-канала о разработке и архитектуре].
Тема: [почему микросервисы на раннем этапе стартапа создают лишний оверхед].
Целевая аудитория: [тимлиды и CTO небольших проектов, знающие стек].
Объём: от 900 до 1200 символов с пробелами.
Тональность: спокойная, критическая, с упором на операционные расходы.
Стоп-слова: «в современном мире», «инновационный», «не секрет», «панацея».
Структура:
1. Заход через конкретную инженерную проблему (без вводных фраз).
2. 2–3 примера, где монолит выигрывает по скорости поставки.
3. Одно условие, когда переход на микросервисы действительно оправдан.
4. Финальный тезис без навязчивого вопроса в конце.
Не используй эмодзи в начале строк.
Шаблон работает за счёт стоп-слов и ограничений структуры. Если не отсечь абстрактные понятия, модель заполнит треть объема рассуждениями о прогрессе.
2. Карточка товара для маркетплейса
Составь описание товара для карточки на маркетплейсе.
Товар: [механическая беспроводная клавиатура, свитчи Red, горячая замена].
Ключевые факторы выбора покупателем: [тихий ход клавиш, работа по Bluetooth и 2.4 GHz, автономность до 200 часов].
Объём: 600–800 символов.
Формат:
- Абзац 1: для кого предназначен товар и какой сценарий закрывает.
- Абзац 2: ключевые технические параметры, переведенные в бытовую выгоду.
- Абзац 3: честное конструктивное ограничение, о котором нужно предупредить заранее (например, вес корпуса или отсутствие кириллицы с завода).
Запрещено использовать слова: «качественный», «идеальный», «лучший выбор», «топовый».
Блок с ограничением снижает процент возвратов и формирует доверие к карточке: товар выделяется на фоне хвалебных текстов.
3. Стилизация под авторский тон (Few-Shot)
Перепиши исходный черновик, строго воспроизводя стиль и синтаксис двух образцов.

Образец 1:
[вставьте фрагмент вашего текста с характерным ритмом]

Образец 2:
[вставьте второй фрагмент вашего текста]

Правила трансформации:
1. Сохрани все технические термины, факты и метрики без изменений.
2. Не придумывай новые подробности, которых нет в черновике.
3. Длина итогового текста должна уложиться в диапазон ±15% от объема черновика.

Исходный черновик:
[текст, требующий адаптации]
Техника Few-Shot (передача примеров в запросе) подтверждается руководством OpenAI по проектированию промптов (по документации вендора на 02.11.2026): образцы задают стиль точнее, чем длинные инструкции.
4. Пакетная генерация заголовков
Предложи 10 вариантов заголовков для материала на тему: [миграция базы данных под высокой нагрузкой без даунтайма].
Стилевой ориентир:
- «Запрос выполнялся 40 секунд. Индекс сократил время до 12 миллисекунд»
- «Зачем переписывать сервис на Go, если узкое место было в дисковой подсистеме»

Требования:
- Длина каждого варианта — до 65 символов.
- Без двоеточий, без кликбейта, без вопросительных знаков.
- Запрещено начинать предложения со слова «Как».
Формат вывода: нумерованный список без вводных реплик.
Шаблоны для документов, аналитики и извлечения данных
5. Классификация и разбор отзывов клиентов
Проанализируй список обращений пользователей ниже.
Для каждой строки верни данные в виде таблицы со столбцами:
Номер | Категория (Баг / Тарифы / Интерфейс / Производительность) | Тональность (Позитивная / Нейтральная / Негативная) | Цитата сути (не более 7 слов) | Корневая причина проблемы

Правила:
- Если проблема не очевидна из текста, в столбце «Корневая причина» напиши «требует уточнения».
- Не выводи никаких вводных приветствий и пояснений после таблицы.

Список обращений:
[список сообщений пользователей, каждое с новой строки]
Указание «не выводи вступительных приветствий» экономит выходные токены и ускоряет парсинг скриптами. Подробнее — в статье о том, как снизить расходы на токены.
6. Саммари и протокол технического созвона
Выдели из приведенной стенограммы созвона рабочие договоренности.
Структурируй результат по трем разделам:
1. Принятые архитектурные и продуктовые решения (только факты, о которых явно договорились).
2. Задачи в работу: [Что сделать] — [Ответственный] — [Крайний срок, если прозвучал].
3. Нерешенные разногласия и открытые вопросы.

Критическое ограничение:
Опирайся исключительно на текст расшифровки. Если дедлайн или исполнитель прямо не названы, ставь «не назначен». Категорически запрещено додумывать логичные сроки или имена.

Расшифровка встречи:
[текст стенограммы]
7. Экспертный юридический аудит рисков договора
Ты выступаешь в роли юридического консультанта со стороны [Исполнителя/Подрядчика].
Проанализируй текст договора и подготовь таблицу рисков:
1. Номер пункта договора.
2. Суть юридического или финансового риска для нашей стороны.
3. Предложенная безопасная редакция формулировки.

Отдельно составь перечень условий, которые стандартно присутствуют в договорах такого типа, но полностью отсутствуют в предоставленном тексте.
Не пересказывай весь документ. Ссылайся строго на номера разделов и пунктов.

Текст договора:
[документ]
Для проверки договоров на десятки страниц нужно контекстное окно от сотен тысяч токенов. Для таких задач подходят модели с длинным контекстом, например gemini-3.1-pro с окном обработки свыше 1 млн токенов.
8. Извлечение сущностей из сырого текста в CSV
Извлеки финансовые показатели из текста отчета и оформи их как CSV.
Колонки: Контрагент, Дата_транзакции (формат YYYY-MM-DD), Сумма_руб, Назначение_платежа, Статус_оплаты.
Разделитель: точка с запятой (;).
Первая строка: заголовки колонок.
Если конкретное поле отсутствует в тексте, оставляй ячейку пустой (не пиши «нет данных» или «N/A»).
Не оборачивай вывод в блоки markdown, не пиши ничего до и после CSV-строк.

Исходный текст:
[фрагменты счетов, писем или накладных]
При разборе данных в автоматизированном пайплайне текстовые запросы на CSV дают сбои на краевых кейсах. В продакшене надежнее использовать режим валидации, описанный в руководстве по структурированному ответу JSON.
Шаблоны для разработки и технического анализа
9. Код-ревью на надежность и читаемость
Проведи ревью следующей функции.
Критерий приемки: этот код пойдет в production-контур с высокими требованиями к аптайму. Поддерживать и отлаживать его будет инженер, не знакомый с текущей реализацией.

Верни отчет по пунктам:
1. Потенциальные утечки ресурсов, гонки или необработанные исключения на граничных условиях.
2. Неочевидные участки логики, требующие обязательного комментирования или декомпозиции.
3. Конкретные предложения по упрощению без изменения контракта функции.

Не переписывай функцию полностью без запроса. Выдели фрагменты до/после только для проблемных мест.
Язык: [Python 3.12 / AsyncIO]. Входные данные: [поток событий из брокера сообщений].

Код:
[исходный код функции]
Формулировка критериев через жизненный цикл системы в продакшене меняет фокус анализа: модель перестает придираться к базовому форматированию и оценивает надежность.
10. Декомпозиция и аудит легаси-кода
Объясни пошаговую логику работы следующего фрагмента кода.
Контекст читателя: [мидл-разработчик, знающий синтаксис языка, но незнакомый с внутренними соглашениями этого проекта].

Выведи:
1. Пошаговый пайплайн обработки данных от входа до возврата значения.
2. Неявные сайд-эффекты (мутации глобального состояния, сетевые вызовы, запись в диск).
3. 3 сценария, при которых этот код завершится аварийно или вернет некорректные данные.

Код для анализа:
[фрагмент легаси-кода]Шаблоны для графики, видео и деловой переписки
11. Фотореалистичный промпт для генерации изображений
A professional editorial portrait of a 35-year-old female software architect, sitting near a large concrete window in a minimalist loft, soft diffused daylight from the side, shot on 35mm film, 85mm lens, f/1.8, shallow depth of field, natural skin texture, neutral desaturated tones, fine film grain, no digital smoothing
12. Векторная иллюстрация для продуктового интерфейса
Flat vector art illustration, a DevOps engineer monitoring server infrastructure on a modern dashboard, isometric perspective, minimalist shapes, strict three-color palette: slate navy, muted amber, off-white, clean geometric lines, generous whitespace around the main subject, isolated on a solid white background, no text, no labels
В графических генераторах вроде qwen-image запрос строят через перечисление материальных атрибутов (объект, оптика, освещение, геометрия и стиль), а не через субъективные эпитеты («великолепный», «кинематографичный»).
13. Сценарий динамичного кадра для видеомодели
Cinematic close-up shot, espresso pouring smoothly into a clear glass cup, thick crema layer forming on top, camera slowly pulls backward on a slider, soft morning window light from the left side, subtle rising steam, high-speed slow motion, photorealistic, 4k resolution, no logos, no text overlay
Генераторы видео требуют разделять траекторию камеры (отъезд, панорама, наезд) и движение объекта. Учитывайте спецификации моделей: для видеогенерации в каталоге доступна hailuo-2.3, а формат входных данных задается параметрами запроса к API.
14. Сложное деловое письмо партнеру или клиенту
Подготовь черновик делового письма [контрагенту], который [задерживает подписание закрывающих актов на две недели без объяснения причин].
Цель письма: [добиться подписания документов или мотивированного отказа до конца текущей недели, сохранив контрактные отношения].
Ограничения:
- Без сарказма, пассивной агрессии и фраз-клише вроде «напоминаем вам», «как было сказано ранее».
- Длина — не более 600 символов.
- Подготовь два варианта формулировки:
  Вариант А: партнерский, с фокусом на закрытие бухгалтерского периода.
  Вариант Б: формально-юридический, со ссылкой на пункты регламента в договоре.
Подпись: [Иван Петров, руководитель клиентского сервиса].
5 инженерных правил для надежных промптов
Чтобы запрос давал воспроизводимый результат в автоматизации, составляйте промпты по базовым принципам работы с LLM.
1. Формулируйте прямые требования и жесткие границы
По данным документации Google Cloud по Vertex AI (на ноябрь 2026 года), прямые указания («что сделать») с четкими граничными условиями работают стабильнее абстракций. Требование «напиши профессионально» субъективно: для одного сценария это канцелярит, для другого — разговорный стиль. Задавайте конкретные рамки: «без вводных слов», «не более 3 предложений на абзац», «только утвердительные предложения».
2. Используйте Few-Shot вместо длинных инструкций
Модели обучаются на паттернах. Описание формата на полстраницы уступает показу двух пар «входные данные $\rightarrow$ эталонный ответ». Если нужно извлечь данные в нестандартный синтаксис или выдержать определенный тон, добавьте 1–2 примера в тело запроса.
3. Задавайте функциональные критерии вместо декоративных ролей
Фраза «Представь, что ты маркетолог» лишь смещает вероятности слов к профильной лексике. Результат дает роль, которая задает критерии валидации:
- Слабая роль: «Ты редактор».
- Функциональный критерий: «Исключи формулировки с двояким толкованием. Подтверждай каждое утверждение условием или цифрой».
4. Разделяйте инструкции и контекст с помощью тегов
Рекомендации Anthropic по работе с Claude и обучающий курс Anthropic предлагают оборачивать блоки промпта в теги: <instructions>, <context>, <input_data>. Это разделяет команды и ввод пользователя, а также защищает от инъекций данных:
<instructions>
Сделай саммари текста, выделив главные факты в 3 пункта.
</instructions>

<context>
Текст предназначен для внутренней технической рассылки инженеров.
</context>

<input_data>
[Пользовательский текст]
</input_data>
Документация OpenAI также рекомендует изолировать исходные данные тройными кавычками (""") или разделителями (###).
5. Разбивайте цепочки рассуждений (Chaining)
Решение комплексной аналитической задачи за один вызов приводит к поверхностным выводам. Чтобы разобрать 50 отзывов, сгруппировать их по когортам и составить план доработок продукта, разбейте процесс на три вызова API:
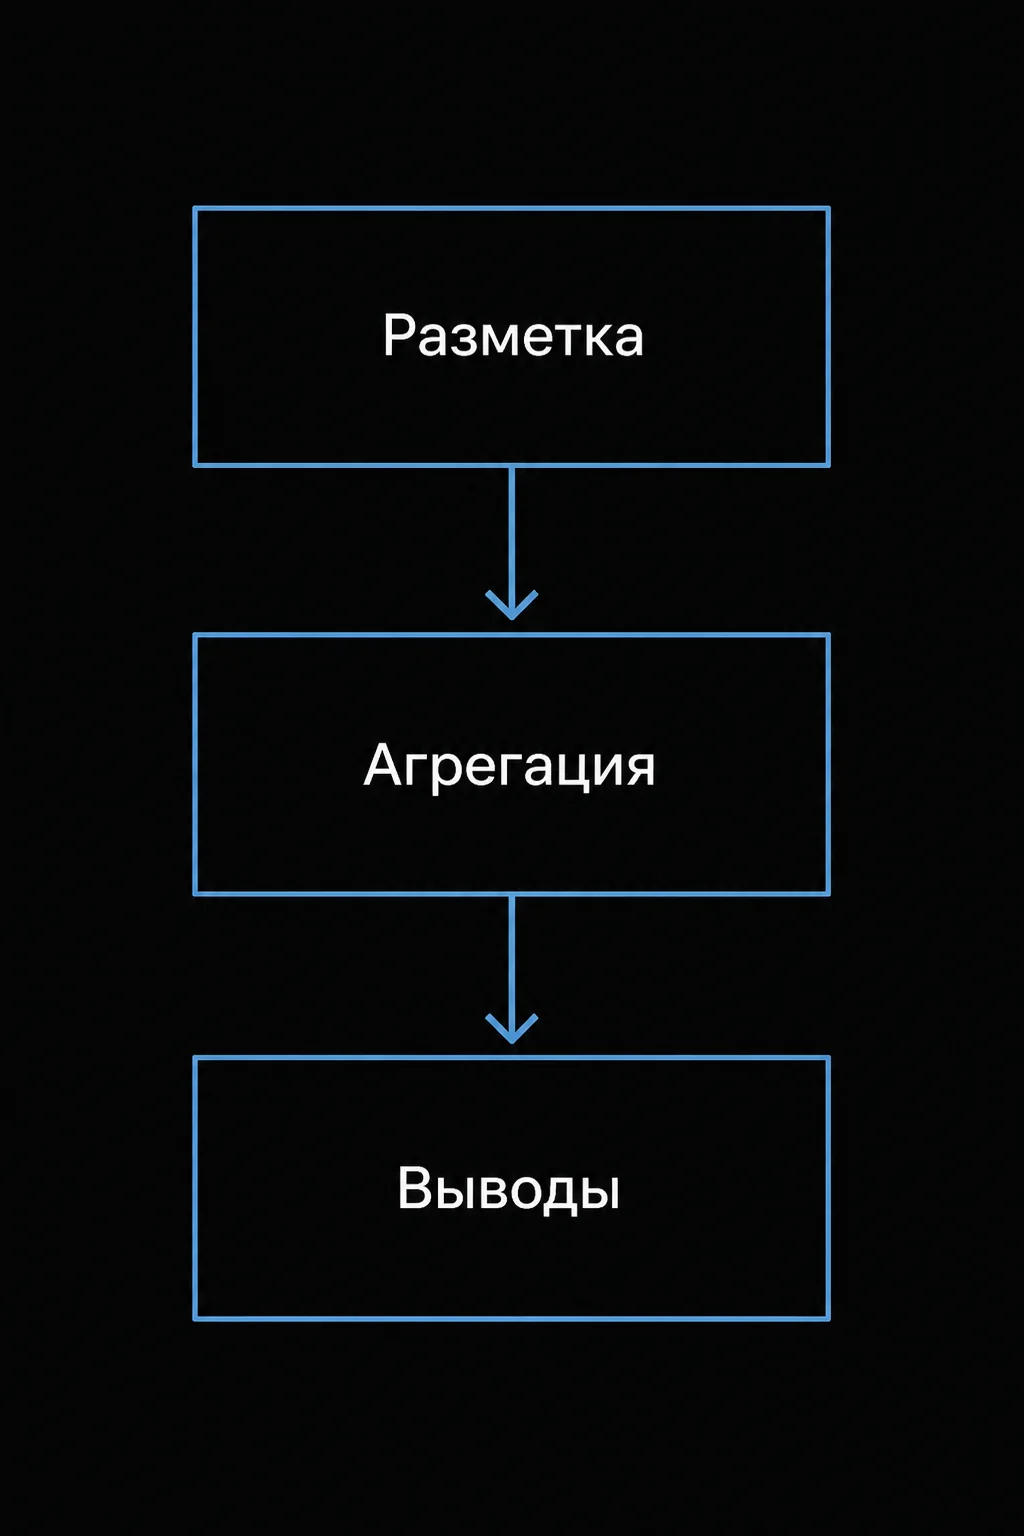
- Шаг 1 (Экстракция): извлечь из каждого отзыва факты и баги в виде чистого JSON-массива.
- Шаг 2 (Агрегация): сгруппировать массив по частоте проблем.
- Шаг 3 (Синтез): составить план действий для продуктовой команды на базе сгруппированных данных.
Каждый шаг изолирован: результат проще логировать, проверять схемой и повторять при сбое.
Параметры API, влияющие на поведение промпта
Когда модель выдает неожиданный результат или ломает пайплайн, причина часто кроется в параметрах вызова API, а не в тексте запроса.
Системный промпт (system message)
По справке OpenAI по системным сообщениям, роль system фиксирует сквозные правила сессии. Если перенести тональность, ограничения форматирования и критерии валидации в system, а задачу передавать в user, модель стабильнее удерживает контекст в длинном диалоге.
Потолок длины генерации (max_tokens)
Ответ обрывается на полуслове при исчерпании лимита выходных токенов. Запрос возвращает HTTP-код 200, но поле finish_reason в объекте ответа содержит length.
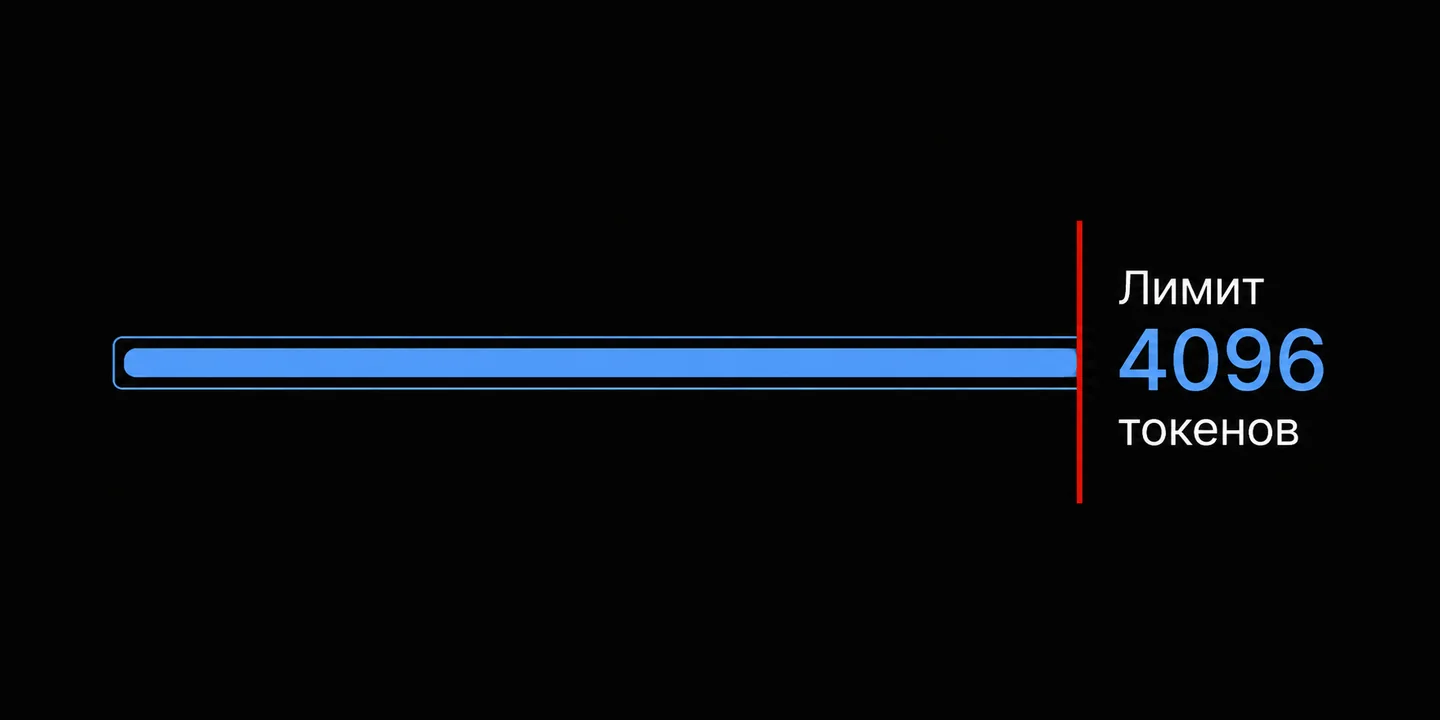
В стандартных интерфейсах лимит по умолчанию составлял 4096 токенов. Флагманские модели выводят больше данных: например, в анонсе Anthropic о Claude 3.5 Sonnet лимит выходных токенов API увеличен до 8192 токенов. При генерации длинных документов задавайте значение max_tokens вручную.
Structured Outputs вместо текстовых просьб
Текстовые указания вроде «верни только JSON без разметки» не гарантируют валидный синтаксис: модель может вставить комментарий или пропустить закрывающую скобку.
По документации OpenAI по Structured Outputs, параметр response_format со строгой схемой (strict: true) принудительно приводит ответ к заданной структуре.
from openai import OpenAI

client = OpenAI(
    base_url="https://api.altrouter.ai/v1",
    api_key="ar-...",
)

response = client.chat.completions.create(
    model="gemini-2.5-flash",
    messages=[
        {"role": "system", "content": "Извлеки данные о компании из текста."},
        {"role": "user", "content": "ООО 'Вектор', ИНН 7701234567, выручка 12 млн руб."}
    ],
    response_format={
        "type": "json_schema",
        "json_schema": {
            "name": "company_data",
            "strict": True,
            "schema": {
                "type": "object",
                "properties": {
                    "name": {"type": "string"},
                    "inn": {"type": "string"},
                    "revenue_mln": {"type": "number"}
                },
                "required": ["name", "inn", "revenue_mln"],
                "additionalProperties": False
            }
        }
    }
)
🔴 Ограничение рассуждающих моделей: в reasoning-моделях (например, o-series от OpenAI) параметр temperature отключен. По руководству OpenAI по рассуждающим моделям, глубина рассуждений настраивается параметром reasoning_effort (low, medium, high). Передача параметра temperature в такие модели не поддерживается или отключается при активном рассуждении.
Чек-лист проверки промпта перед запуском
Перед интеграцией промпта в скрипт или сервис проверьте его по чек-листу:
- Контекст и цель: понятно ли модели, для кого предназначен текст и где он выйдет?
- Границы и фильтры: заданы ли стоп-слова, лимит объема и запрещенные конструкции?
- Критерий приемки: сформулирована ли роль через прикладную задачу («проверь код на утечки памяти»), а не через титул?
- Изоляция данных: отделен ли ввод пользователя от инструкций тегами (
<input>) или разделителями? - Эталоны: добавлены ли 1–2 примера формата (Few-Shot) для сложных структур?
- Лимит токенов: хватает ли значения
max_tokens, чтобы ответ не оборвался? - Структура ответа: настроен ли
response_formatвместо текстовой просьбы прислать JSON?
FAQ
Почему готовые шаблоны промптов часто выдают банальный результат?
Шаблоны из сети содержат только каркас задачи, но не учитывают специфику аудитории, требования и стоп-слова. Без граничных условий модель выдает усредненный текст из обучающей выборки. Чтобы получить рабочий результат, заполните переменные в блоках [...] конкретными данными.
Подробнее: API нейросетей: один ключ ко всем моделям.
Помогает ли фраза «Ты эксперт с 20-летним стажем»?
Фраза меняет только лексический слой, но не добавляет глубины анализу. Назначайте роль через критерий приемки: например, «Критерий оценки кода — устойчивость к сетевым сбоям и читаемость для разработчика с другим стеком».
Подробнее: Надёжность и резервные маршруты.
Зачем разбивать один сложный запрос на несколько этапов?
Если поручить модели сразу анализ, классификацию, расчеты и оформление отчета, возрастает риск ошибок и пропуска инструкций. Цепочка вызовов (разметка $\rightarrow$ агрегация $\rightarrow$ оформление) позволяет контролировать каждый шаг и локализовать сбои в пайплайне.
Подробнее: API нейросетей: один ключ ко всем моделям.
В чем разница между системным промптом и обычным сообщением?
Системное сообщение (system message) задает правила поведения, роль и технические ограничения на всю сессию. Пользовательские сообщения (user message) передают данные для конкретного шага. Если вынести постоянные требования в системный блок, модель не потеряет правила при росте контекстного окна.
Подробнее: API нейросетей: один ключ ко всем моделям.